

Hemos investigado un incidente relacionado con el acceso no autorizado a nuestro entorno de control de calidad y pruebas de producto. En este blog, compartiremos todos los detalles para educar a nuestros socios, mientras esperamos servir como un ejemplo transparente para que las empresas modernas lo sigan.
Brindemos por exigirnos a nosotros mismos el mismo estándar que exigimos a otros proveedores de software 🥂.
Primero lo primero: ¿debo preocuparme?
- No se accedió ni se comprometió ningún dato de clientes
- No se accedió ni se comprometió información de facturación
- No se accedió ni se comprometieron sistemas del entorno de producción
- No se accedió ni se manipuló código fuente ni recursos del pipeline de compilación
- No se encontró ni se explotó código vulnerable o inseguro en este incidente
- Corregimos la mala configuración y el mecanismo de autenticación débil que permitió que una instancia efímera de prueba con Windows sufriera un ataque de fuerza bruta vía RDP 😒
Nuestro entorno de control de calidad es una red de AWS segmentada a propósito, aislada de nuestros sistemas de producción, con cuentas y credenciales de usuario separadas. El entorno se usa para probar funcionalidades del agente de Huntress. Este entorno no tiene datos de clientes y la segmentación impide el acceso a los sistemas de producción que albergan esos datos.
¿Por qué estamos revelando esto?
Si alguna vez has escuchado hablar a nuestro equipo, probablemente nos hayas oído decir algo como: “Los incidentes inevitablemente van a ocurrir. Lo que distingue a las empresas es cómo responden”.
Dicho esto, incluso después de recibir la orientación de nuestro equipo legal de que no era obligatorio hacer esto público, decidimos hacerlo de todas formas. ¿Por qué? Porque les pedimos lo mismo a otros proveedores.
Ese nivel de transparencia es clave para el éxito de quienes forman parte del canal. Tenemos que exigir responsabilidad a nuestros proveedores, y eso nos incluye a nosotros en Huntress. Celebramos nuestros logros, aprendemos de nuestros errores y nos esforzamos por ser mejores hoy de lo que fuimos ayer. Y parte de eso significa asumir la responsabilidad cuando algo sale mal internamente.
Es 2021. Los actores de amenazas son más astutos que nunca, y quienes nos dedicamos a la defensa tenemos mucho trabajo por delante para mantenernos a la vanguardia. Para darnos la mejor oportunidad, debemos ser francos y honestos unos con otros para aprender juntos de nuestros errores.
Esperamos que este blog logre tres cosas:
- Dar el ejemplo sólido que las personas del canal merecen en cuanto a transparencia y responsabilidad de los proveedores
- Inspirar a otros proveedores a ser más abiertos sobre situaciones similares (la divulgación de incidentes necesita dejar de ser estigmatizada para lograr un progreso real)
- Ayudar a otros a aprender de nuestro (vergonzoso) error 😅
Entonces, ¿qué pasó?
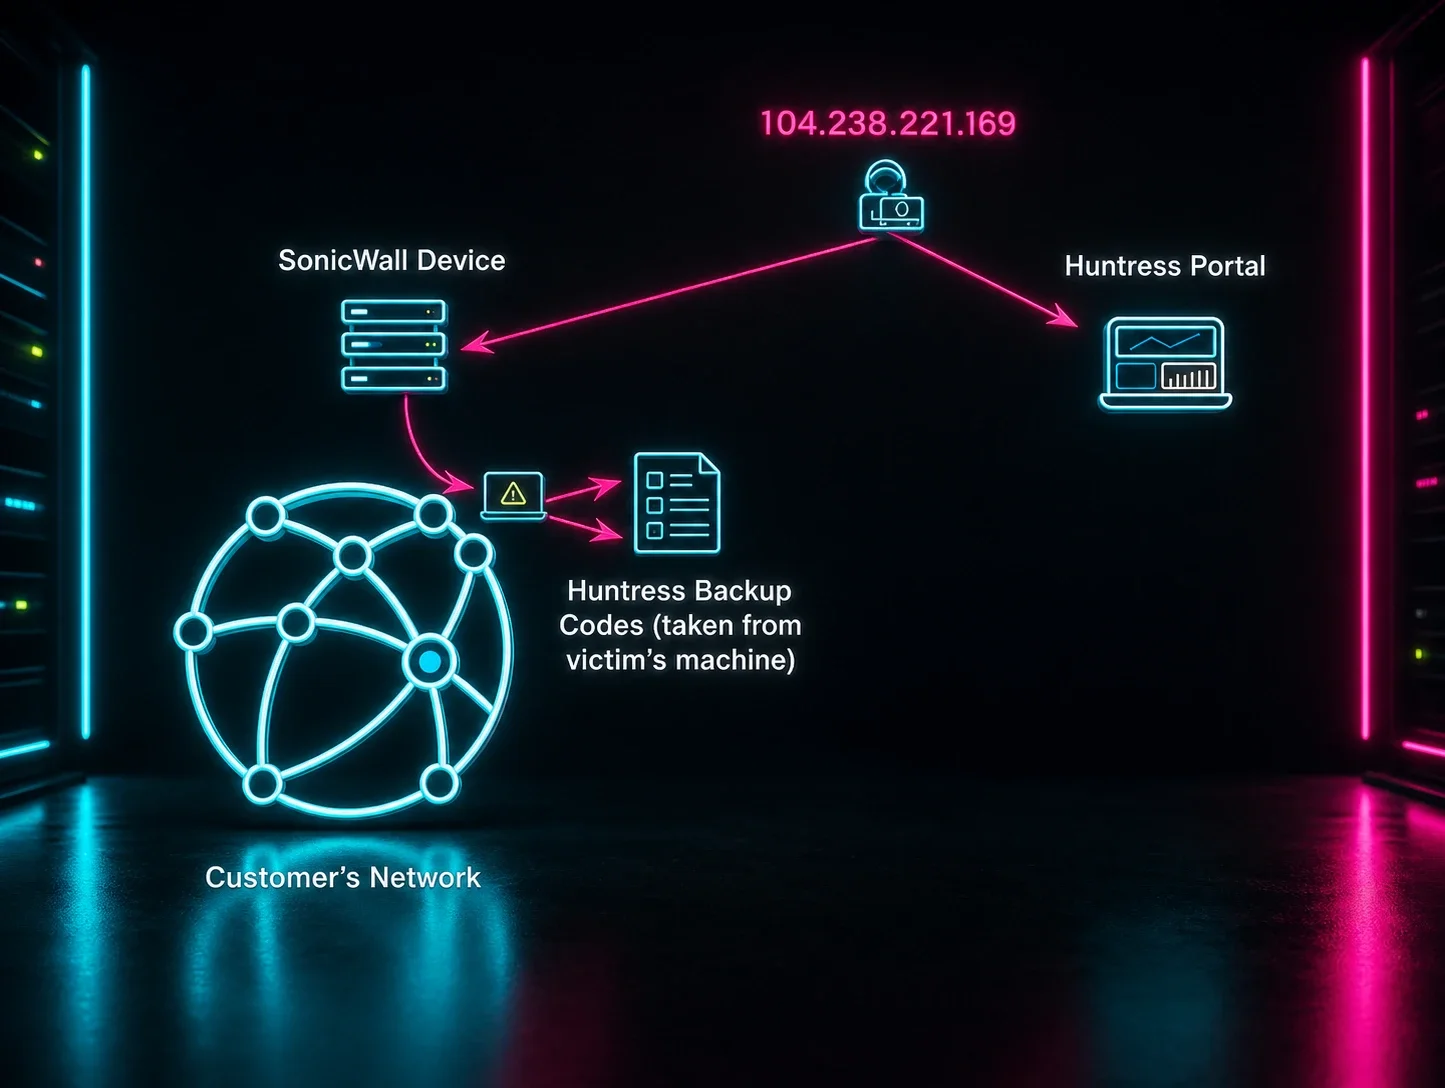
El domingo 17 de octubre, nuestro equipo recibió una notificación de AWS que indicaba que una instancia en la nube dentro de nuestro entorno de control de calidad (QA) estaba escaneando públicamente internet en busca de puertos abiertos del protocolo de escritorio remoto (RDP).
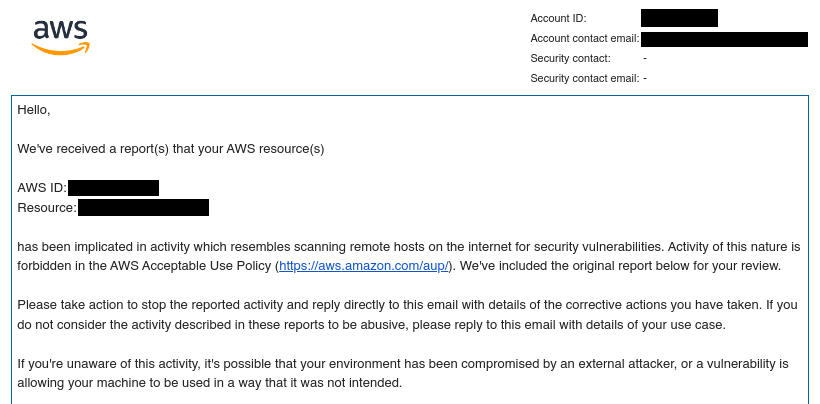
Nuestro entorno de QA activa máquinas virtuales (VM) temporales con Windows y ejecuta un conjunto de pruebas automatizadas para probar la funcionalidad del agente de Huntress. Después de completar una ronda de pruebas, las máquinas virtuales se terminan de inmediato, por lo que suelen estar en línea de 10 a 15 minutos. En su configuración previa a este incidente, cada VM tenía abiertos a internet el puerto RDP (3389) y el puerto SSH (22) para facilitar la depuración y la comunicación unidireccional con un contenedor Docker interno temporal separado, usado por CircleCI (nuestro sistema de compilación automatizado y pipeline de integración continua/entrega continua).
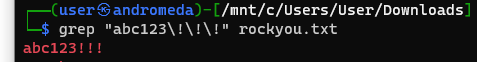
Tras revisar el aviso de AWS, descubrimos que 37 VM con Windows habían quedado huérfanas y activas durante la semana del 13 de octubre. Estas instancias no se terminaron debido a una falla en nuestro sistema de aprovisionamiento automatizado, y una de estas VM de ejecución prolongada era la culpable: escaneaba otras direcciones IP públicas en busca de puertos abiertos. Nos quedó claro que un actor desconocido simplemente había logrado entrar por fuerza bruta a esta instancia efímera de QA usando las supercomplejas credenciales: Administrator/abc123!!!.
Para quienes no captaron el sarcasmo, no es ningún secreto que esta es una de las contraseñas más comunes y fáciles de descifrar que aparecen en cualquier lista de contraseñas. 😔
¿Qué hicimos?
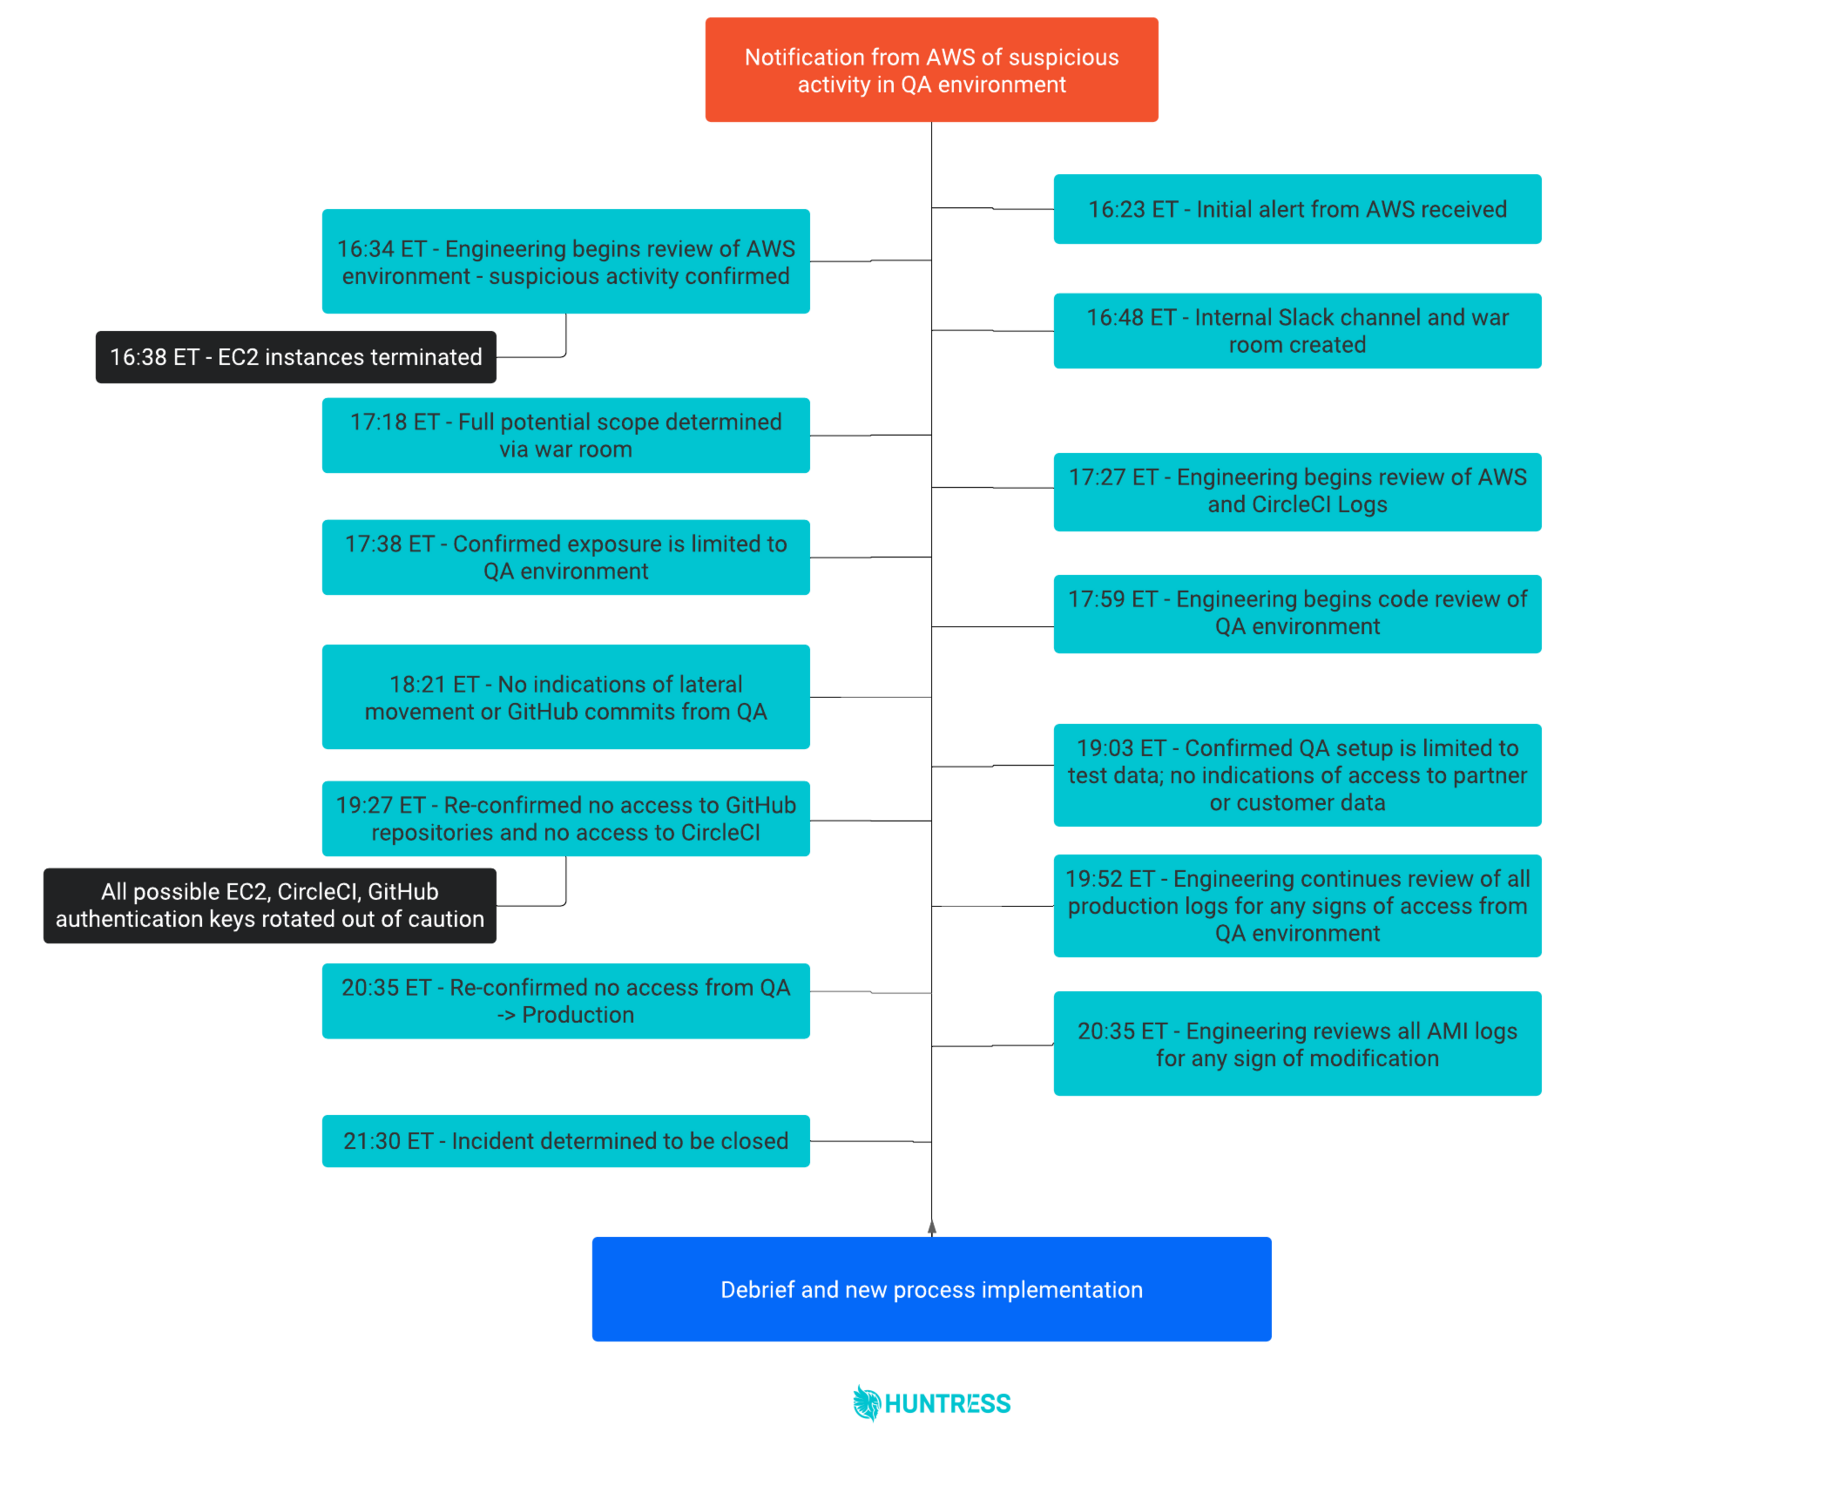
Mientras nuestro liderazgo ejecutivo hacía llamadas y coordinaba acciones, creamos un canal de Slack a nivel de toda la empresa para facilitar la comunicación entre departamentos. También activamos una sesión de Zoom como sala de guerra para crear nuestro plan de acción. Esto le dio a nuestro equipo la base para ponerse manos a la obra y trabajar sin descanso para delimitar y remediar cualquier nuevo hallazgo durante el incidente.
La primera gran acción que tomó nuestro equipo de ingeniería fue identificar y terminar cualquier VM de ejecución prolongada en el entorno de QA de AWS. Aunque esto parecía un paso sólido para erradicar rápidamente a un actor de amenazas dentro de la red, en realidad dificultó parte de nuestros esfuerzos posteriores de análisis forense. Para investigar más a fondo, revisamos los registros de AWS de QA y los registros de CircleCI para asegurarnos de que no hubiera actividad ni acceso no autorizado desde las instancias de QA hacia el portal de CircleCI (no lo hubo). También confirmamos que no hubo otra actividad maliciosa en el entorno de QA de AWS, incluido el movimiento lateral.
Luego empezamos a revisar nuestro código base. Revisamos todo el código que generaba el entorno de QA por tres razones:
- Para entender qué credenciales se usaban para el acceso
- Para entender el comportamiento de las pruebas
- Para asegurarnos de que el entorno no usara ni accediera a ningún dato real de socios, una preocupación prioritaria para nosotros
Confirmamos que la infraestructura de pruebas de QA solo tenía acceso al repositorio de código de pruebas y que las instancias de QA no tenían conectividad con el servidor de CircleCI cuando las pruebas fallaban, lo que impidió que el actor accediera a nuestro pipeline de CI/CD. Por precaución, rotamos todas las claves de API de CircleCI y GitHub.
Para descartar cualquier acceso al código de producción o a datos de socios, revisamos y confirmamos que no había información sensible presente en el entorno de QA. Para reforzar aún más este esfuerzo, examinamos nuestros registros de producción y confirmamos que no hubo acceso no autorizado a ninguna infraestructura relacionada con producción. Finalmente, inspeccionamos y confirmamos que las Amazon Machine Images (AMI) usadas para generar las VM de QA no habían sido modificadas, y nos aseguramos de que no se hubiera realizado ningún cambio de código no autorizado.
Gracias a la toma de notas detalladas y la elaboración de una línea de tiempo a lo largo de todo el incidente, este esfuerzo conjunto permitió a nuestro equipo de ingeniería remediar y mejorar de cara al futuro.
¿Qué nuevos procesos implementamos?
Una vez concluidas nuestras investigaciones, dimos de baja el antiguo entorno de QA de AWS y creamos uno nuevo con los siguientes cambios implementados:
- Cambiamos a claves SSH para la autenticación en las VM de prueba con Windows y nos aseguramos de que las claves se regeneren en cada ejecución de pruebas
- Recreamos la AMI de Windows con el servicio RDP deshabilitado
- Corregimos un error en nuestro sistema de aprovisionamiento automatizado que dejaba VM con Windows huérfanas cuando el entorno de prueba no completaba la configuración
- Usamos etiquetado para identificar y terminar automáticamente las VM de ejecución prolongada
- Vinculamos las instancias EC2 a los volúmenes EBS en los registros para facilitar la depuración y el análisis forense
- Configuramos nuestro entorno de CircleCI para usar una subred privada de AWS para restringir todo acceso desde internet a las instancias de QA de AWS
- Implementamos un proceso de gestión de cambios para el entorno de QA (que ya existía en producción)
- Creamos nuevos roles de configuración de AWS con permisos aún más restringidos
Estamos implementando capacitación formal en seguridad para el equipo de ingeniería, incluida capacitación sobre hacking de aplicaciones web, código seguro y seguridad en la nube de AWS. También estamos iniciando el proceso de documentar y establecer un plan de respuesta a incidentes formal basado en lo aprendido.
Finalmente, completamos nuestras auditorías anuales de código y configuración, pruebas de penetración y evaluaciones de vulnerabilidad para el entorno de producción de AWS en septiembre de 2021 (que no incluyeron el entorno de QA de AWS).
Para ayudar a seguir desafiando las normas de ciberseguridad de la industria, decidimos publicar copias sin censura de estas auditorías anuales en el siguiente repositorio de GitHub (próximamente; fecha estimada diciembre de 2021). Nuestra próxima reevaluación ampliará el alcance del trabajo para incluir el entorno de QA de AWS.
La segmentación importa
Es importante señalar que segmentamos a propósito nuestro entorno de QA de AWS de nuestros otros dos entornos de AWS, producción y staging. (Por si no lo sabías, la segmentación en ciberseguridad es la práctica de separar redes y sistemas informáticos para mejorar la seguridad y el rendimiento). En realidad, es probable que esta decisión nos haya ahorrado mucho tiempo, esfuerzo y dolores de cabeza durante este incidente.
Este incidente es un buen ejemplo de por qué la segmentación debería existir siempre que tenga sentido. Sin ella, los actores de amenazas podrían haberse movido lateralmente desde nuestro entorno de pruebas hasta nuestro sistema de producción, rico en datos sensibles de clientes. En pocas palabras, esta segmentación redujo enormemente el radio de impacto de este incidente.
Sin embargo, la verdadera lección aprendida aquí es que los incidentes son la nueva norma más allá de 2021, y este no será el último. Una postura de ciberseguridad resiliente sigue siendo de suma importancia, incluso con una segmentación adecuada.
Orientación de nuestro equipo legal
Siguiendo el consejo que hemos dado en más de una docena de presentaciones sobre este tema, las primeras llamadas que hicimos fueron a nuestros equipos legal y de seguros.
En aras de la transparencia y la educación, enumeramos a continuación algunas de las recomendaciones del equipo legal. Ten en cuenta que estos puntos son las recomendaciones de nuestro equipo legal; esto no debe interpretarse como asesoría legal por parte de Huntress.
- Los datos son la parte más importante al evaluar tu situación legal. ¿Qué tipo de datos se almacenaron y a quién pertenecían (por ejemplo, datos de clientes, PII/PHI, secretos comerciales de terceros, datos confidenciales, código, etc.)?
- Si se trata de una situación sin daño ni perjuicio, no recomendamos hacerlo público. Piensa en los clientes que podrían decidir no convertirse en clientes, no renovar o solicitar terminar contratos “con causa”.
- Revisa los requisitos de notificación incluidos en tus contratos. Revisa tus contratos más grandes, que pueden tener requisitos de notificación distintos (potencialmente más amplios). Revisa qué tipo de incidentes estás obligado a reportar (por ejemplo, incidentes generales frente a incidentes que involucran datos de ese cliente).
- Notifica a tu aseguradora lo antes posible.
- Trae a un equipo externo de respuesta a incidentes (generalmente asignado por tu aseguradora), porque esto te quita la responsabilidad de determinar si se requiere notificación. Nota: no trajimos uno porque nuestra aseguradora determinó que estábamos más que capacitados para manejar el incidente dada la exposición limitada. 😉
Orientación de nuestro equipo de seguro cibernético
Después de hablar con nuestro equipo legal, nos comunicamos con nuestro equipo de seguro cibernético para asegurarnos de tener todo en orden. Nos dieron dos consejos que compartimos aquí:
- Divulga el incidente lo antes posible y obtén orientación de la aseguradora sobre los próximos pasos. Asegúrate de conocer tus plazos de notificación y cúmplelos.
- Mantén los detalles al mínimo al usar el correo electrónico de la empresa, por si ese canal también está comprometido.
Por si no quedó claro, nos tomamos ese primer punto muy en serio, lo que nos lleva a donde estamos hoy.
Palabras finales
Aunque al final no pasó nada grave con este incidente, simplemente no está en nuestro ADN ocultar un incidente debajo de la alfombra. Si vamos a ser la marea que eleva los barcos de la comunidad, tenemos que exigirnos el estándar más alto, y esperamos que esta divulgación nos acerque un poco más a cumplir con esa expectativa.
Queremos reiterar nuestra firme convicción de que la transparencia es clave en situaciones como esta. Esperamos que esta transparencia sea contagiosa entre otros proveedores, y también esperamos que este incidente y las lecciones que aprendimos resulten valiosos para ti y tu equipo también.
Si eres uno de nuestros socios, por favor contáctanos si tienes alguna pregunta sobre este incidente.