

El acceso inicial es un tema candente para los profesionales de seguridad. Quienes están en el lado ofensivo de nuestra maravillosamente grande industria siempre buscan nuevas formas de entrar a las redes, lejos de las miradas indiscretas de quienes están en el lado defensivo.
Si observamos la categoría de Acceso Inicial de MITRE ATT&CK, vemos 10 técnicas y varias subtécnicas. ¿Deberías instrumentar tu red o la de tus clientes para detectar todas estas técnicas? ¿O se utilizan algunas más que otras?
Esta pregunta va al grano de este blog. Acompáñanos mientras exploramos los vectores de acceso inicial observados por el Centro de Operaciones de Seguridad de Huntress (SOC) y los equipos de Tactical Response.
Tactical Response
Quienes hayan leído con atención o hayan asistido a seminarios web anteriores quizás hayan visto o escuchado sobre el equipo de Tactical Response de Huntress. Pero, ¿qué hace exactamente este equipo y qué lo diferencia del Huntress SOC?
El equipo de Tactical Response de Huntress trabaja de cerca con el SOC y actúa como punto de escalamiento para intrusiones que abarcan múltiples endpoints o que se determinan como "con manos en el teclado".
El/la analista del centro de operaciones de seguridad (SOC) a menudo aísla los endpoints, o la red completa si se considera necesario, y luego traspasa el caso a Tactical Response.
Los analistas de Tactical Response se enfocan en identificar el vector de acceso inicial de las intrusiones para que nuestros socios puedan identificar rápidamente el origen de una intrusión y tomar las medidas necesarias para corregirla.
En muchos casos, Tactical Response extrae eventos de Windows de los endpoints afectados y trabaja con nuestros equipos internos de soporte del SOC para solicitar telemetría adicional a los socios. Esta telemetría puede incluir registros de dispositivos perimetrales o cualquier otra telemetría relevante que el socio pueda proporcionar.
Aunque esto no es un servicio completo de respuesta a incidentes, a menudo—en minutos de recibir la telemetría—ofrecemos a los socios información valiosa, como qué endpoints fueron afectados por el incidente y, cuando es posible, también el vector de acceso inicial.
Gracias a este amplio alcance, Tactical Response ha completado una gran cantidad de casos, con hallazgos muy interesantes que compartimos en este blog.
Análisis de acceso inicial
Ahora que ya dimos el contexto, exploremos el análisis de los métodos de acceso inicial observados por el equipo de Tactical Response.
Debido a la naturaleza sensible de esta información, no se proporcionan cifras exactas. Sin embargo, al revisar las distintas categorías de vectores de acceso inicial descubiertos, comienza a surgir un patrón claro:
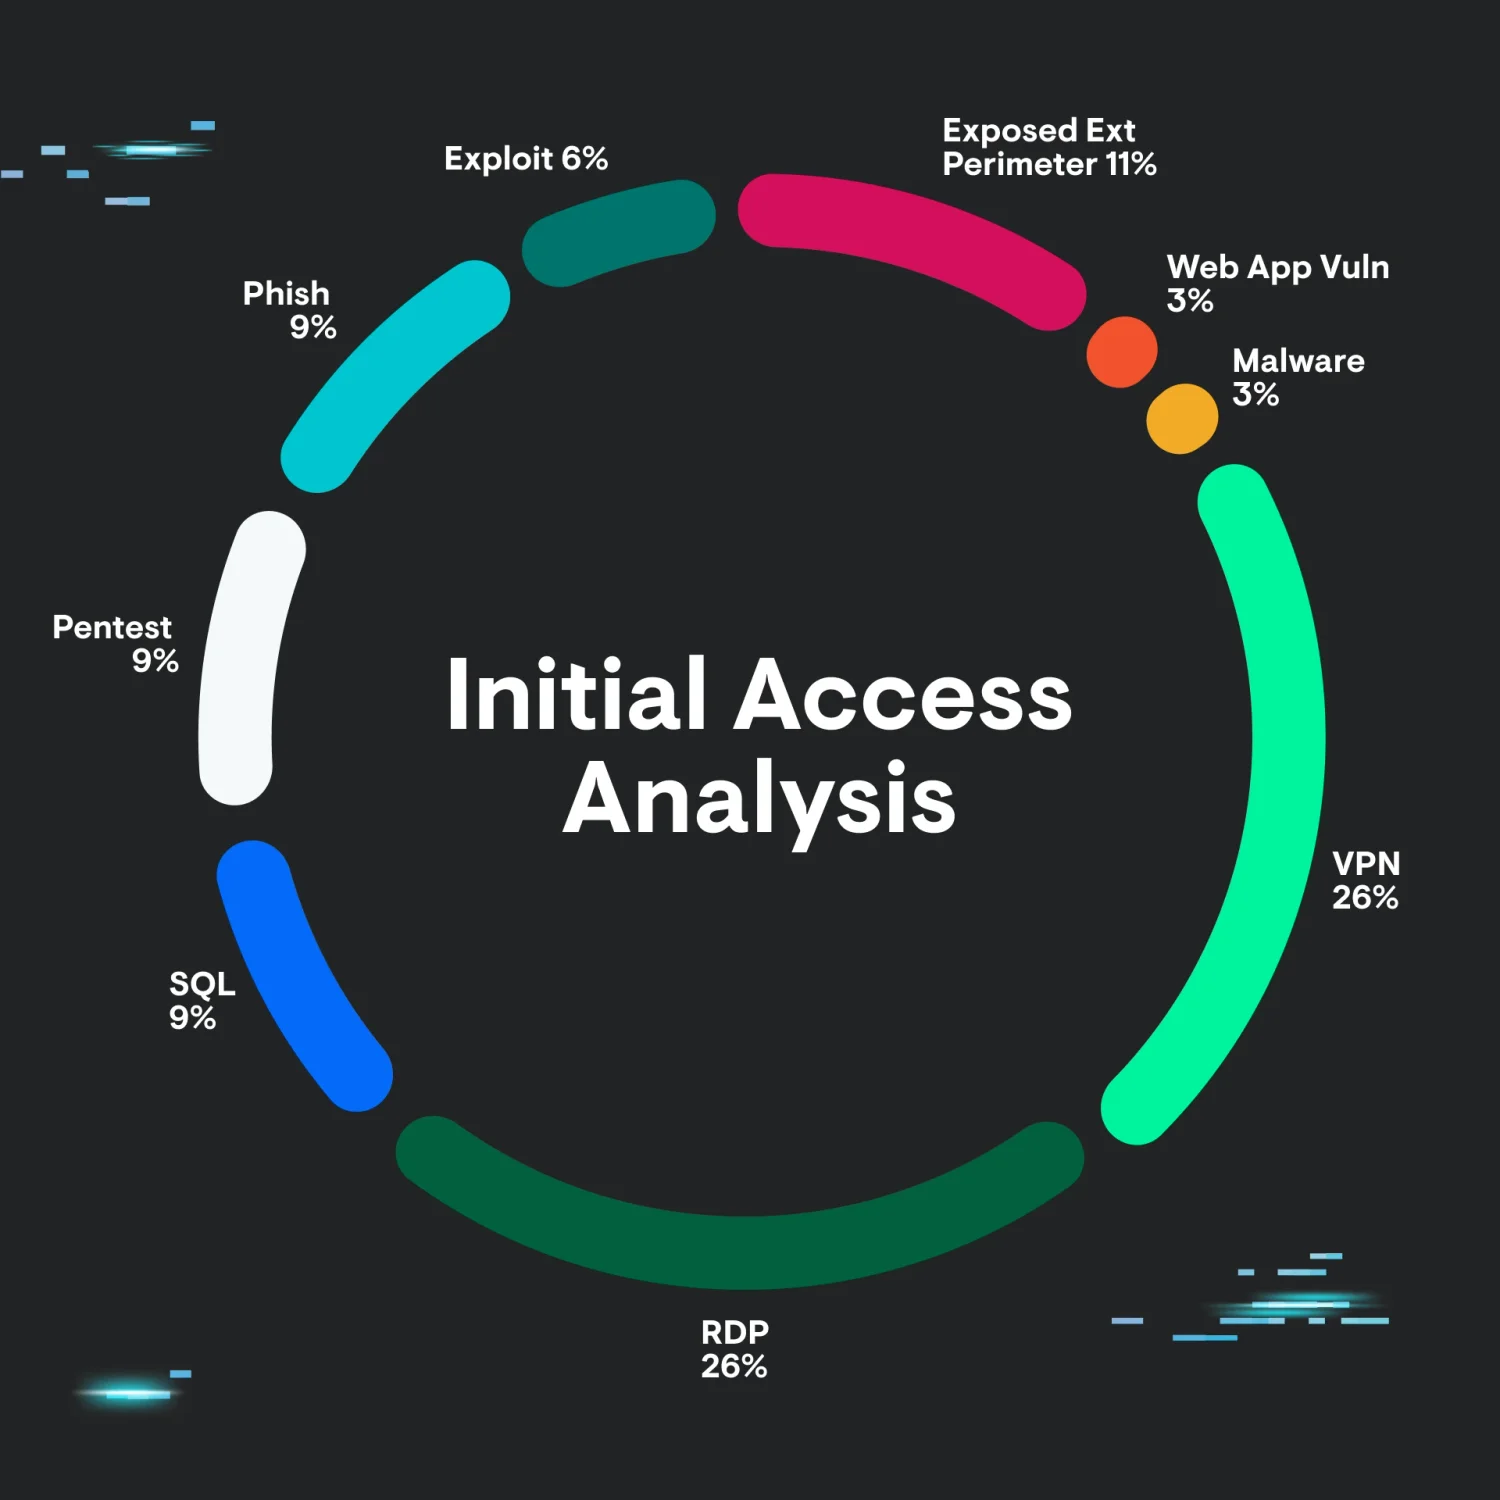
Podemos ver que los principales métodos de acceso inicial son el Escritorio Remoto (RDP) y VPN, con el perímetro externo expuesto muy cerca en segundo lugar.
Por supuesto, estas cifras tienen algunos matices. En concreto, no incluyen los casos en los que no pudimos determinar la vía de acceso inicial, ya sea por falta de telemetría u otras razones.
Además, en la categoría de VPN, no contamos ningún exploit aquí, solo los inicios de sesión mediante credenciales robadas o comprometidas de otra forma. Por lo tanto, esta muestra, y los datos resultantes, no deben considerarse representativos. Pero sí pintan un panorama muy interesante.
Dado el enorme y comprensible enfoque de la industria en los 0 days, la explotación de vulnerabilidades y el phishing, quizás sorprenda que estas categorías representen un porcentaje pequeño (o menor) de los vectores de intrusión detectados.
Podemos analizar esta dinámica desde el punto de vista de un actor de amenazas para entenderla mejor. Si se tiene la opción de explotar un dispositivo o usar credenciales válidas pero comprometidas, empezamos a ver por qué esta vía de ataque resulta más atractiva para un actor de amenazas. Los dispositivos pueden estar parchados, los exploits pueden ser poco confiables o difíciles de crear, y, en cambio, la autenticación mediante cuentas o credenciales válidas puede pasar más desapercibida.
La explotación de cuentas válidas también se presta más a un tipo de explotación oportunista, en la que los actores de amenazas tienen una lista de dispositivos perimetrales y nombres de usuario, e intentan ataques de fuerza bruta o password spraying contra estos dispositivos, buscando un punto de apoyo persistente en las redes corporativas.
Ahora que tenemos un buen panorama de los objetivos de acceso inicial más “populares” usados por los actores de amenazas, y dado lo que muestran los datos anteriores, centremos nuestra atención en las vías de VPN, RDP y perímetro expuesto. Están muy sobrerrepresentadas y constituyen la gran mayoría de los vectores de intrusión observados, por lo que vale la pena analizarlas en detalle.
Perímetro expuesto y RDP
Para los fines de este blog, tiene sentido agrupar RDP y perímetro expuesto, ya que estos vectores están estrechamente relacionados entre sí.
De hecho, el equipo de Respuesta Táctica trabajó en una gran parte de los casos relacionados con el acceso inicial a través de un perímetro expuesto.
En las intrusiones relacionadas con RDP, a menudo observamos intentos de fuerza bruta seguidos de un inicio de sesión exitoso:
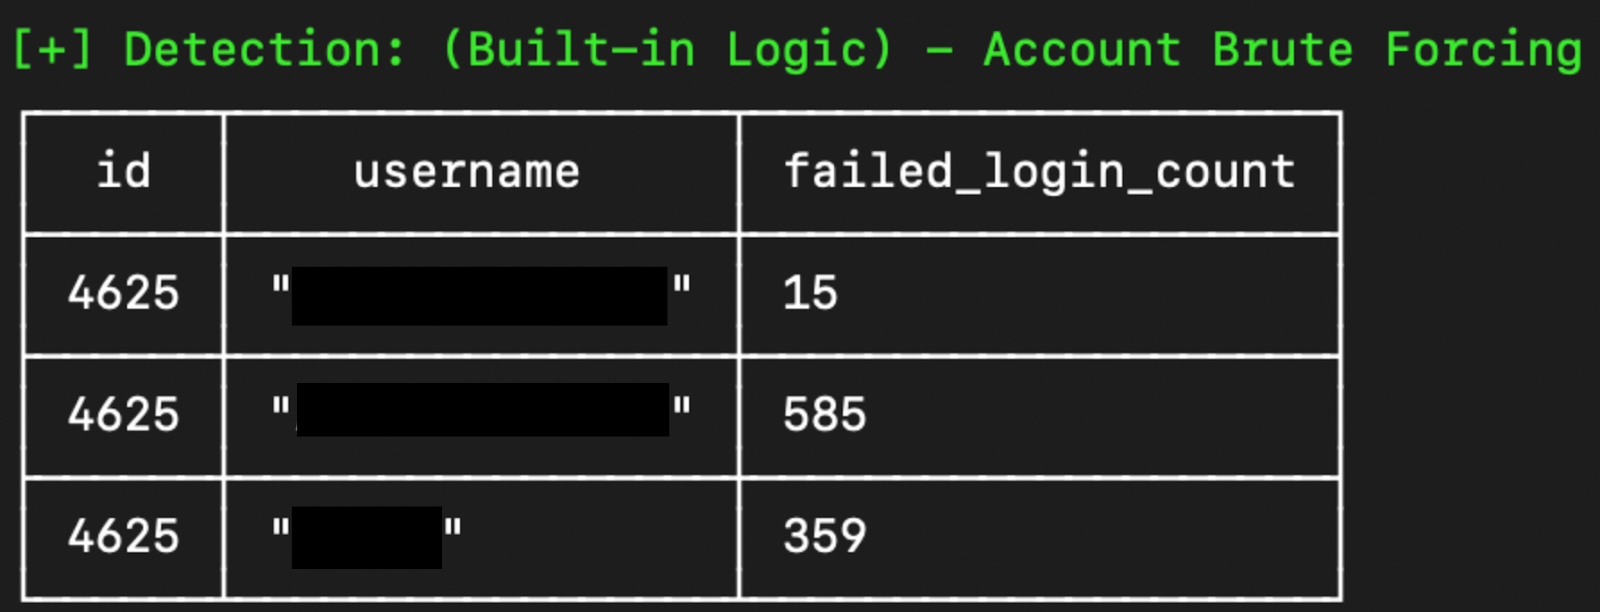
En otros casos, no observamos ninguna actividad de fuerza bruta, sino simplemente un inicio de sesión desde una cuenta que proviene de una dirección IP sospechosa. En estos casos, podemos concluir, quizás, que las credenciales del usuario se comprometieron previamente y se reutilizaron en un ataque de tipo credential stuffing. Cabe reconocer que esta hipótesis es difícil de comprobar solo con los registros de eventos.
Los servicios de Escritorio Remoto también se pueden exponer a través de una puerta de enlace de Escritorio Remoto (RDG). Los métodos de acceso a través de RDG son similares a los que apuntan directamente al servicio RDP; sin embargo, la telemetría usada para identificar dicha actividad difiere un poco.
Al investigar intrusiones relacionadas con RDP, es importante recordar ir más allá del registro de Security y revisar también los siguientes canales de registro:
Microsoft-Windows-TerminalServices-Gateway
Microsoft-Windows-TerminalServices-LocalSessionManager
Además, los servidores RDG contarán con un archivo de registro de IIS, que también puede usarse para detectar actividad maliciosa.
Aunque esto ocurre con menos frecuencia que la exposición de servicios RDP o RDG, algunas organizaciones lamentablemente exponen directamente a internet sus interfaces de server message block (SMB).
Se trata de un escenario extremadamente peligroso, ya que el protocolo SMB no admite ningún tipo de autenticación multifactor (MFA), por lo que cualquier actor de amenazas con credenciales válidas de una cuenta con los permisos adecuados podrá obtener un punto de apoyo persistente en el entorno con relativa facilidad.
Cómo proteger RDP/RDG y SMB
Ahora que entendemos mejor cómo los actores de amenazas explotan los perímetros expuestos, dediquemos tiempo a la parte importante: ¡qué puedes hacer al respecto!
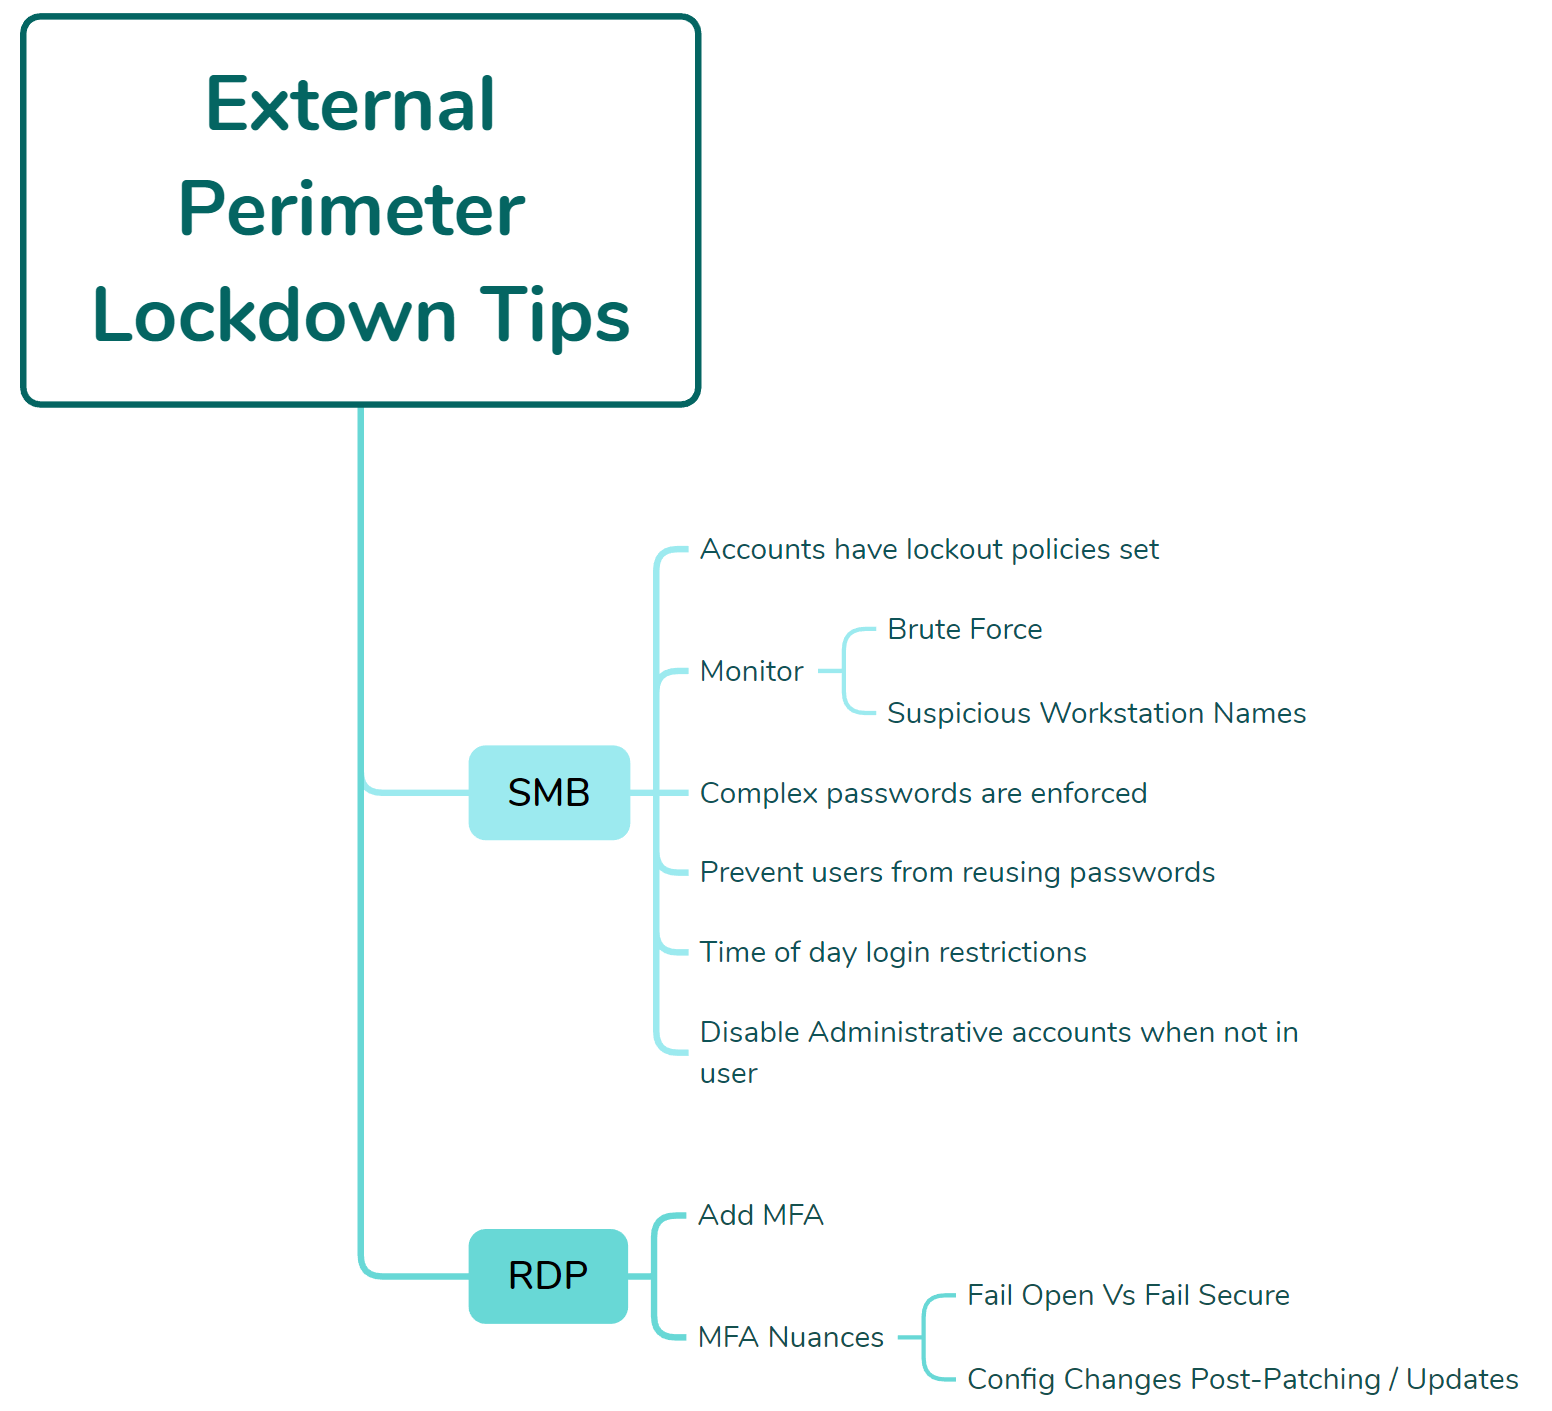
Si no tienes otra opción que exponer SMB directamente a internet por razones justificadas del negocio, asegúrate de que:
- Las cuentas tengan políticas de bloqueo configuradas
- Haya monitoreo implementado para ataques de fuerza bruta
- Haya monitoreo implementado para autenticación desde nombres de estación de trabajo sospechosos
- Se exijan contraseñas complejas
- Se haga todo lo posible para evitar que los usuarios reutilicen contraseñas
- Se agreguen restricciones de inicio de sesión por hora del día a las cuentas
- Las cuentas —particularmente aquellas con privilegios administrativos— se deshabiliten cuando no estén en uso
En algunos casos, hemos observado que un socio expone tanto SMB como RDP a internet, con MFA envolviendo el RDP. ¡Esto es fantástico! Sin embargo, hay una advertencia bastante importante aquí.
Un actor de amenazas con credenciales válidas no podría acceder con éxito al servicio RDP sin superar el desafío de MFA. Sin embargo, si esas credenciales pertenecían a una cuenta con los permisos adecuados, se podrían usar para autenticarse con éxito en el servicio SMB, el cual, como se mencionó antes, no tiene ningún concepto de MFA. Esta dinámica ilustra lo importante que es entender qué expones a internet y ajustar los controles en consecuencia.
En otro matiz, también hemos observado casos donde solo RDP estaba expuesto, con MFA envolviéndolo. Sin embargo, la aplicación encargada de presentar el desafío de MFA estaba configurada para “fallar abierta”. Esto significa que, si la aplicación fallaba o dejaba de responder, permitiría la autenticación sin un desafío de MFA.
Esta dinámica es totalmente comprensible para aplicaciones de negocio críticas que deben funcionar 24/7. Es posible que los socios no quieran bloquear todos los inicios de sesión de forma general si una aplicación falla. Sin embargo, es importante estar al tanto de esta dinámica y recibir una alerta cuando una aplicación falle o deje de funcionar normalmente, ya que esto podría significar que se elimina un control de seguridad crítico como MFA.
Un último “detalle” para asegurar los perímetros expuestos es probar tus flujos de autenticación después de ciclos de parches o actualizaciones de software. En algunos casos, trabajando con nuestros socios, pudimos determinar que la configuración del software de MFA había sido cambiada, actualizada o modificada de alguna manera, permitiendo la autenticación sin MFA después de aplicar parches o actualizaciones de software. Por lo tanto, recomendamos probar los flujos de autenticación, particularmente aquellos protegidos por MFA, después de cualquier parche o actualización de software. Aunque esto pueda implicar algo más de tiempo y esfuerzo, es insignificante comparado con el esfuerzo necesario para reconstruir una red completa tras un despliegue de ransomware.
Acceso inicial a través de dispositivo VPN
En segundo lugar entre los métodos de acceso inicial observados por el equipo de Respuesta Táctica está el acceso inicial a través de un dispositivo VPN. Esta categoría incluye inicios de sesión maliciosos a través del dispositivo mediante credenciales robadas o por fuerza bruta, y no la explotación del propio dispositivo VPN.
Hay un matiz aquí que puede sesgar los resultados. En muchos casos, la telemetría del dispositivo VPN no estaba disponible o no cubría el período de tiempo de una intrusión determinada. Es importante tener esto en cuenta al sacar conclusiones definitivas del análisis presentado aquí.
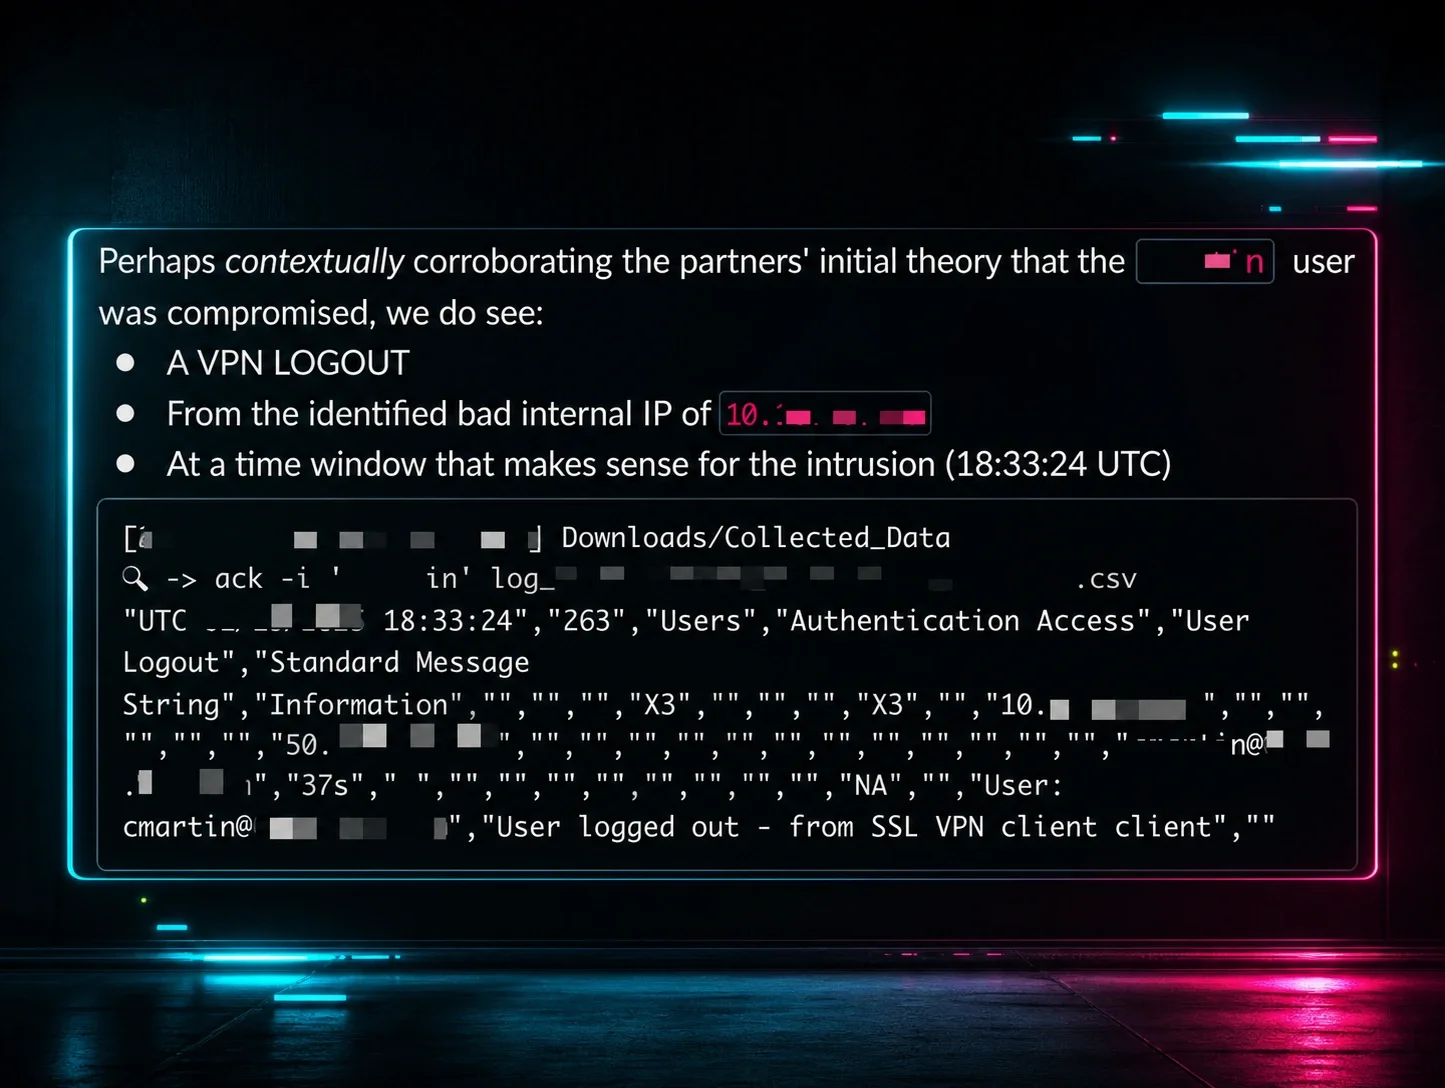
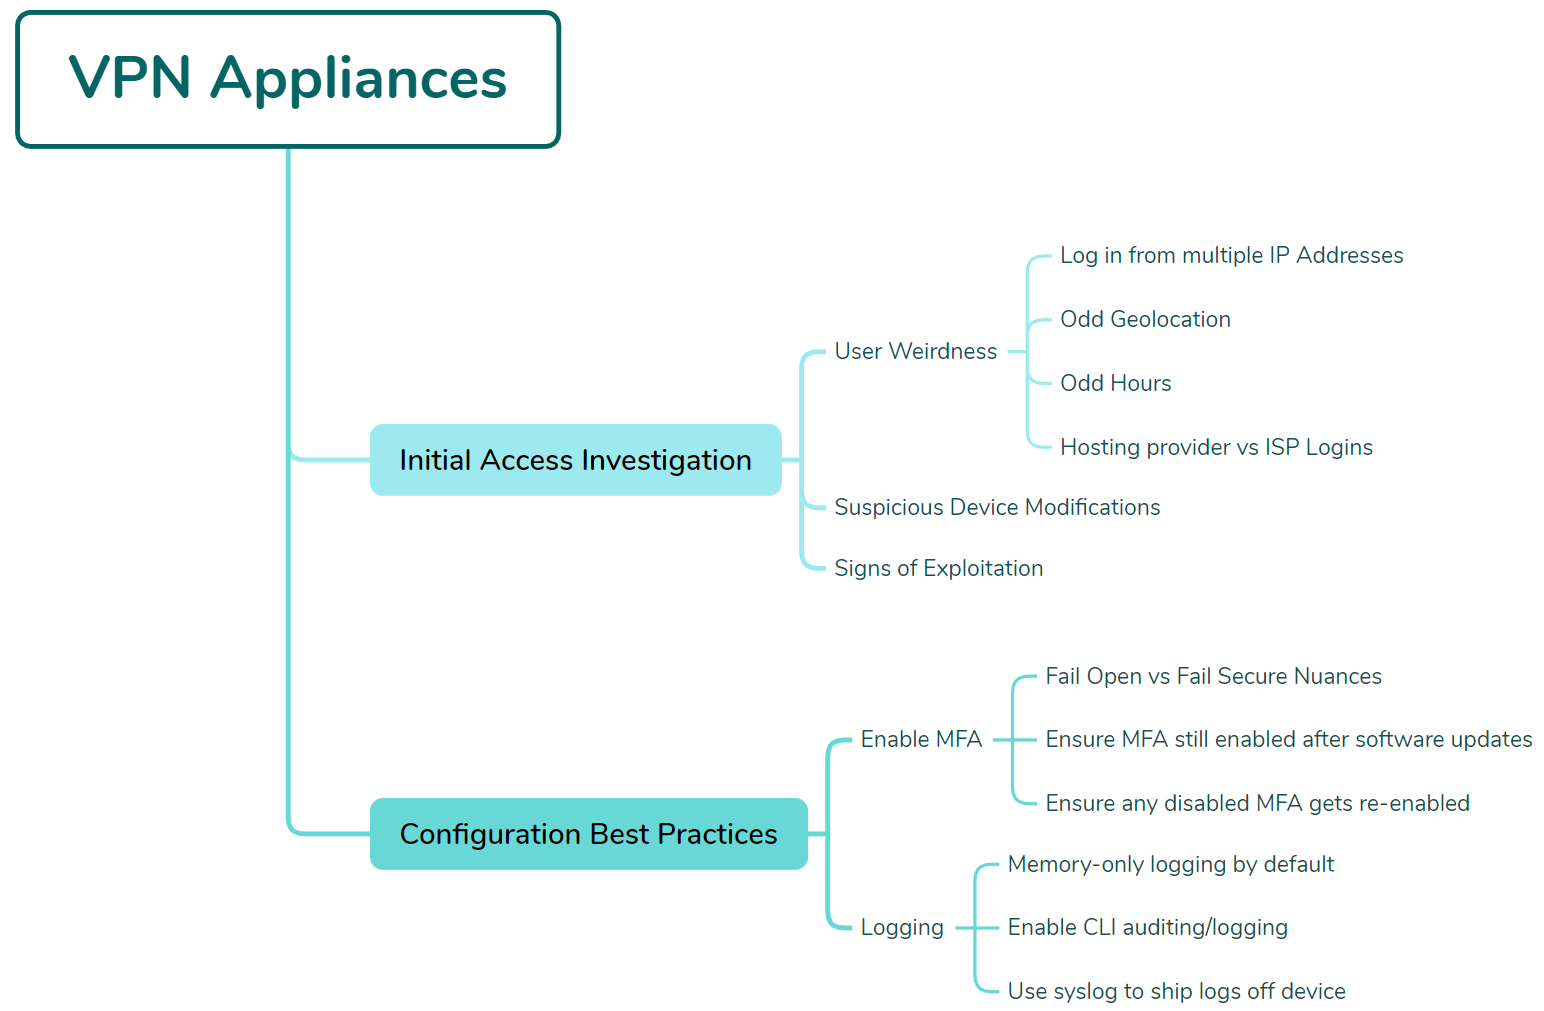
Al examinar la telemetría del dispositivo VPN, el equipo de Respuesta Táctica se enfoca en las siguientes áreas:
- Cualquier usuario que inicie sesión desde múltiples direcciones IP
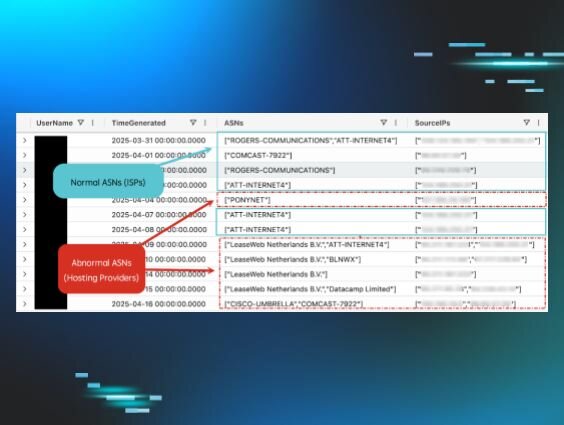
- Usuarios que inicien sesión desde geolocalizaciones inusuales
- Usuarios que inicien sesión en horarios inusuales del día
- Modificaciones sospechosas en la configuración del dispositivo
- Cualquier señal evidente de explotación
- Usuarios que inicien sesión desde proveedores de hosting y no desde ISP residenciales
Algunas dinámicas dificultan el análisis de los dispositivos VPN, particularmente en entornos con menos recursos.
Primero, debido a que los dispositivos VPN están, por naturaleza, expuestos a internet, suelen ser blanco de varios escaneos y sondeos; de hecho, internet es un lugar muy ruidoso.
Esta dinámica se agrava por la falta de una configuración de registro adecuada en los propios dispositivos. Esto a menudo significa que los registros se almacenan en la memoria del dispositivo y no se conservan por mucho tiempo, lo que, dado el ruido que recibe el dispositivo, significa que la telemetría relevante para la seguridad suele sobrescribirse con ruido de internet. En algunos casos observados, los datos de inicio de sesión de usuario solo estuvieron disponibles durante 40 minutos en un dispositivo que se sospechaba era el origen de una intrusión.
Dados estos desafíos, veamos algunas recomendaciones prácticas que puedes aplicar en tus propios dispositivos VPN para asegurarte de que el registro adecuado esté configurado y se conserve. Aquí usaremos un dispositivo Fortinet como ejemplo, pero los consejos aplican a cualquier tipo de dispositivo VPN.
Preparación para el éxito: configuración del dispositivo VPN
Como se mencionó en las secciones de RDP y perímetro externo de este blog, la autenticación multifactor es fundamental para todo lo que está expuesto a internet, y esta dinámica también aplica a los dispositivos VPN.
Los mismos matices sobre “fallar abierto” frente a cerrado, y sobre la aplicación de parches/actualizaciones, también se aplican a los dispositivos VPN. Hemos visto muchos casos de configuraciones de MFA de VPN modificadas o deshabilitadas de forma inadvertida.
Además, si se elimina el MFA de una cuenta con fines de solución de problemas, asegúrate de que esto quede registrado y de volver a activar el MFA cuando la cuenta vuelva a estar en funcionamiento.
Además de estas recomendaciones generales, también es importante examinar la configuración de registro y telemetría de tus dispositivos VPN.
Tomando un dispositivo Fortinet como ejemplo, podemos verificar hacia dónde está registrando el dispositivo mediante el comando get sys status:
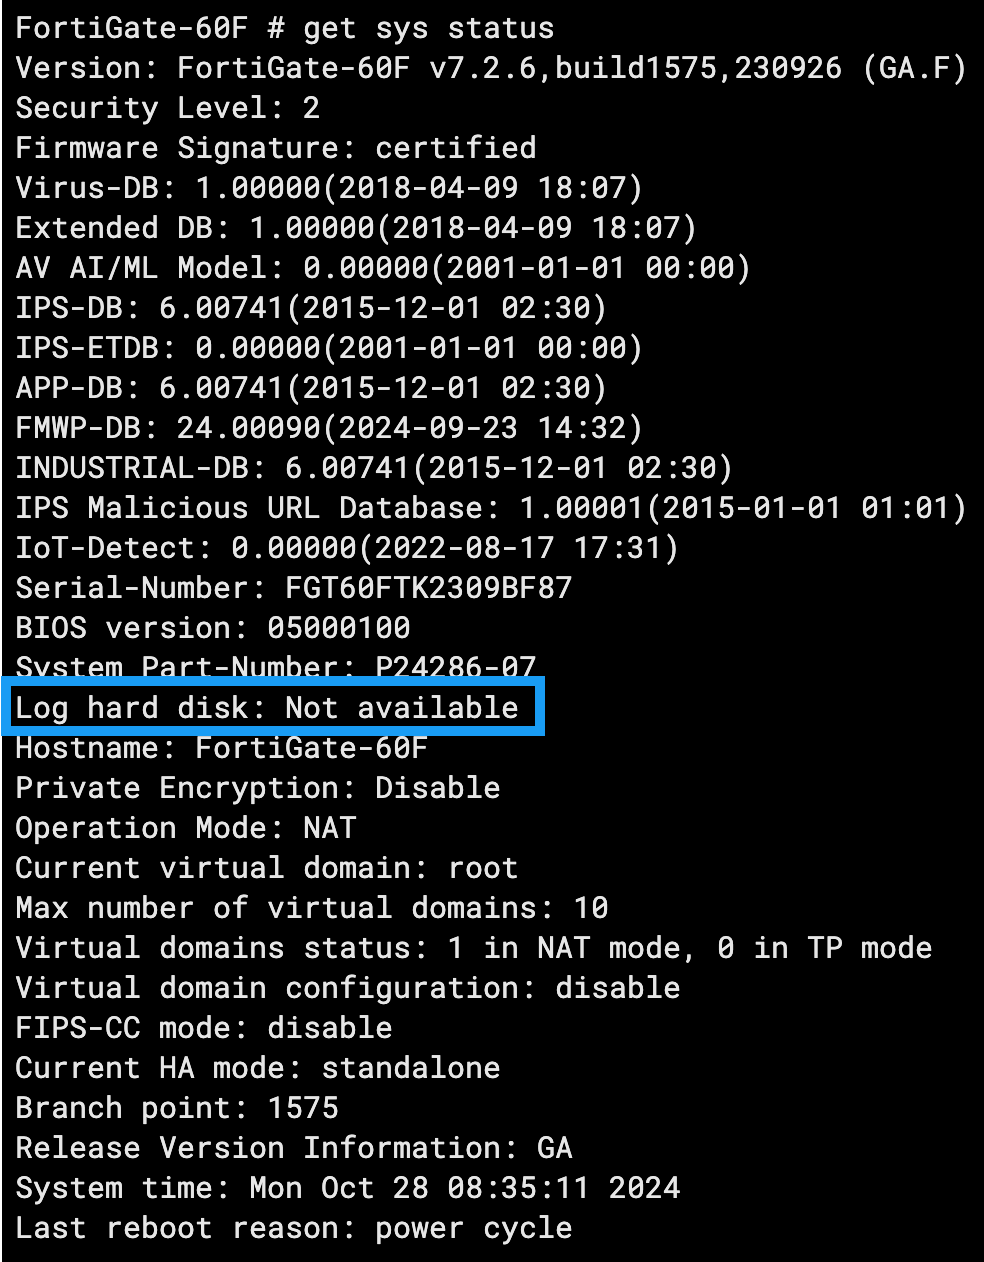
En este ejemplo, podemos ver que la configuración de Log hard disk aparece como Not available. Esto significa que el dispositivo solo registra en su memoria y es probable que sobrescriba la telemetría con bastante rapidez, dado que el dispositivo estará expuesto a internet y sujeto a varios escaneos y solicitudes de autenticación.
Por defecto, los dispositivos Fortinet no registran los comandos de línea de comandos (CLI). Esto significa que cualquier acción administrativa realizada en la línea de comandos a través de la consola virtual o física del dispositivo no quedará registrada.
Este registro se puede habilitar colocando el dispositivo en modo de configuración: config system global y luego habilitando la auditoría de CLI con set cli-audit-log enable:
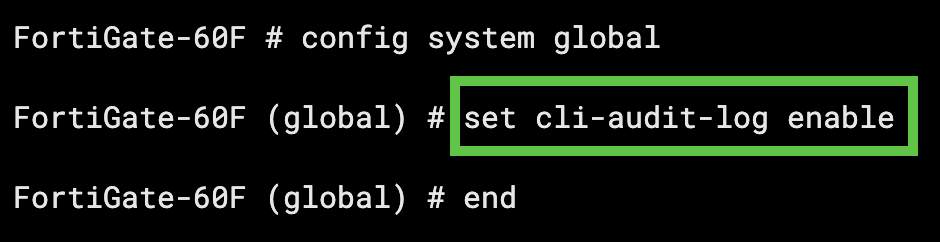
Con la auditoría CLI habilitada, si ejecutamos un comando simple como execute pingwww[.]google[.]ca, esto quedará registrado:
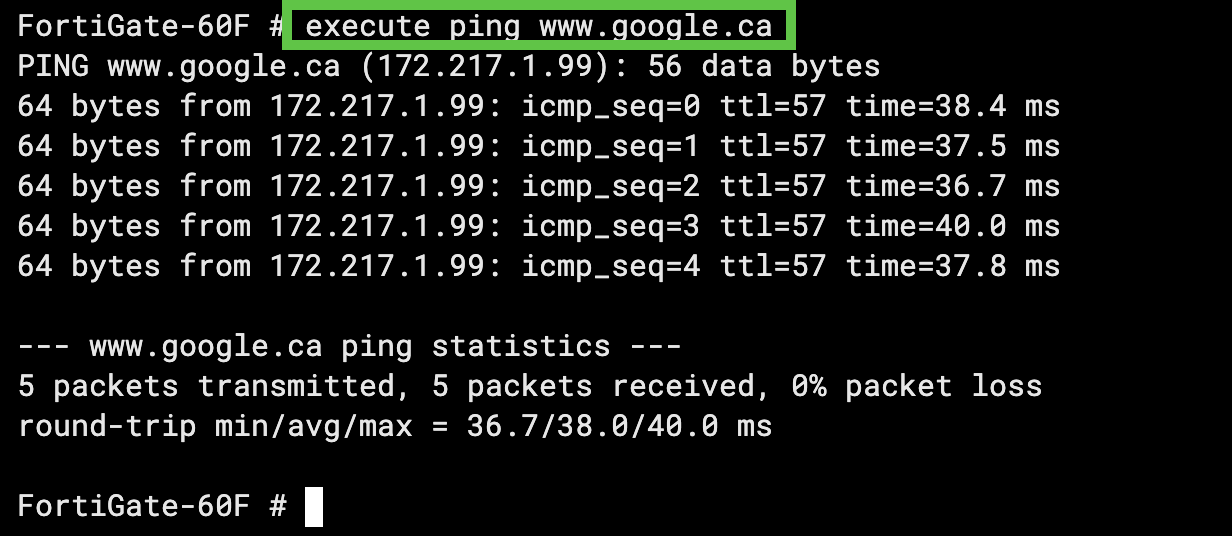
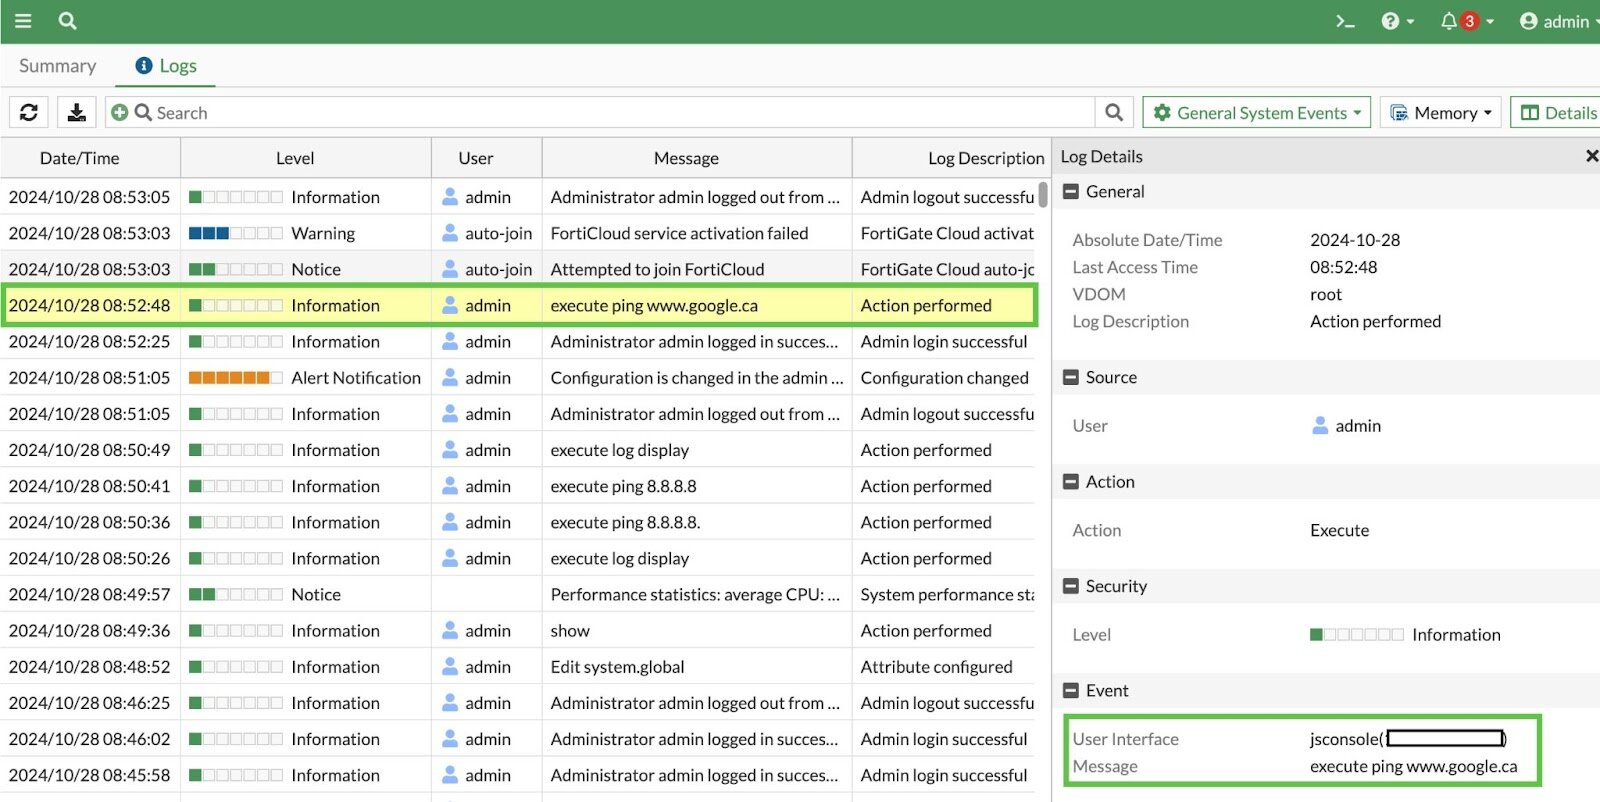
Muy bien, tenemos los registros habilitados en nuestro dispositivo, pero en este punto, todos estos registros se guardarán solo en memoria, como mencionamos antes.
Aunque el dispositivo se puede configurar para registrar en un disco local, no todos los modelos vienen con un disco duro instalado. Además, siempre es mejor enviar los registros fuera del dispositivo para evitar cualquier situación en la que un actor de amenazas pueda borrarlos o modificarlos.
Modificar esta configuración es relativamente simple:
- Primero, ingresamos a la configuración de
syslogd:config log syslogd setting - Luego habilitamos la configuración:
set status enable - Luego le indicamos al dispositivo adónde queremos enviar el syslog:
set server <syslog_server_ip> - Finalmente, configuramos el formato:
set format { default | cev | cef }
Con esta configuración, el dispositivo debería registrar los comandos CLI y estar configurado para enviar los registros a un servidor secundario donde se puedan ingerir y analizar. Esta dinámica le da a los equipos de seguridad una visibilidad relevante y preserva la integridad de la telemetría, impidiendo su modificación o eliminación.
Conclusión y puntos clave
En esta publicación compartimos datos e información obtenidos de muchos casos completados de Respuesta Táctica.
Descubrimos que la gran mayoría de las intrusiones comenzaron con un perímetro expuesto o controles de autenticación débiles en un dispositivo VPN.
¿Qué podemos hacer con estos datos? ¿Significa esto que el phishing, el malware o los vectores de acceso inicial impulsados por exploits son menos importantes? Desafortunadamente, los números a menudo cuentan una historia que no está arraigada en la realidad, en particular la realidad de empresas con recursos limitados.
Dicho de otra manera, si tu organización sufriera una brecha por un ataque de phishing, probablemente no te importaría si este método de acceso inicial en particular es más o menos común que otros. Solo querrías evitar que vuelva a ocurrir.
Esta es la realidad poco afortunada en la que existen las organizaciones de hoy: tener que cubrir más con menos.
Aunque las organizaciones grandes y pequeñas deben protegerse tanto contra exploits avanzados como contra técnicas más "básicas", como la fuerza bruta o el credential stuffing, quizás la principal conclusión de este análisis sea que tal vez no estemos haciendo bien lo básico, como quisiéramos o esperaríamos.
A pesar de la existencia de numerosos días cero, exploits y técnicas de phishing, los actores de amenazas están teniendo éxito con métodos de explotación probados y comprobados.
Depende de todos nosotros hacer que les cueste más trabajo.