


Los hipervisores son la columna vertebral de los entornos virtualizados modernos, pero cuando se ven comprometidos, pueden convertirse en un multiplicador de fuerza para los atacantes. Una sola brecha en esta capa puede poner en riesgo docenas o incluso cientos de máquinas virtuales de forma simultánea. A diferencia de los endpoints tradicionales, los hipervisores suelen operar con visibilidad y protecciones limitadas, lo que significa que las herramientas de seguridad convencionales pueden estar ciegas ante un ataque hasta que sea demasiado tarde.
Desde nuestra posición en el SOC y en el espacio de caza de amenazas en Huntress, vemos que los adversarios apuntan cada vez más a los hipervisores para desplegar ransomware a gran escala. Específicamente, en 2025, los datos de casos de Huntress revelaron un aumento sorprendente del ransomware en hipervisores: su papel en el cifrado malicioso se disparó de apenas un 3% en la primera mitad del año a un 25% en lo que va de la segunda mitad. El actor principal detrás de esta tendencia es el grupo de ransomware Akira. Este cambio subraya la importancia de aplicar el endurecimiento de la seguridad a la capa del hipervisor con el mismo rigor que se aplica a los endpoints y servidores.
En este artículo, describimos las amenazas que hemos observado en el mundo real y damos orientación práctica para proteger tu infraestructura de hipervisores, desde la aplicación de parches y el control de acceso hasta el endurecimiento de la seguridad en tiempo de ejecución y estrategias sólidas de recuperación.
Hipervisores: un nuevo campo de batalla en las operaciones de ransomware
En los últimos meses de 2025, Huntress ha observado que los adversarios apuntan a los hipervisores en un intento de evadir los controles de seguridad de endpoints y redes. Y esto tiene sentido: a medida que los defensores siguen aplicando el endurecimiento de la seguridad en endpoints y servidores, los adversarios desplazan cada vez más su enfoque hacia la capa del hipervisor, la base de la infraestructura virtualizada - . un hipervisor de Tipo 1 ("bare metal") es la base, instalado directamente en el hardware del servidor, mientras que un hipervisor de Tipo 2 ("alojado") es una aplicación que se ejecuta sobre el sistema operativo de tu computadora habitual.
Este cambio sigue un guion conocido. Lo hemos visto con los ataques a dispositivos VPN: los actores de amenazas se dan cuenta de que el sistema operativo base suele ser propietario o restringido, lo que significa que los defensores no pueden instalar controles de seguridad críticos como EDR. Esto crea un punto ciego importante. El mismo principio se aplica a los hipervisores de Tipo 1; son el objetivo definitivo para "aterrizar y expandirse", donde la seguridad tradicional de endpoints a menudo no puede llegar. También hemos observado varios casos en los que los operadores de ransomware despliegan cargas útiles de ransomware directamente a través de los hipervisores, evitando por completo las protecciones tradicionales de endpoints. En algunos casos, los atacantes aprovechan herramientas integradas como openssl para realizar el cifrado de los volúmenes de las máquinas virtuales, evitando así la necesidad de subir binarios de ransomware personalizados.
- Una vez dentro de una red, los atacantes suelen pivotar hacia los hipervisores usando credenciales de autenticación internas comprometidas en entornos donde la segmentación de redes no logró impedir el movimiento lateral hacia la página de administración del hipervisor. Este movimiento les otorga un control elevado sobre múltiples sistemas invitados desde una sola interfaz de administración.
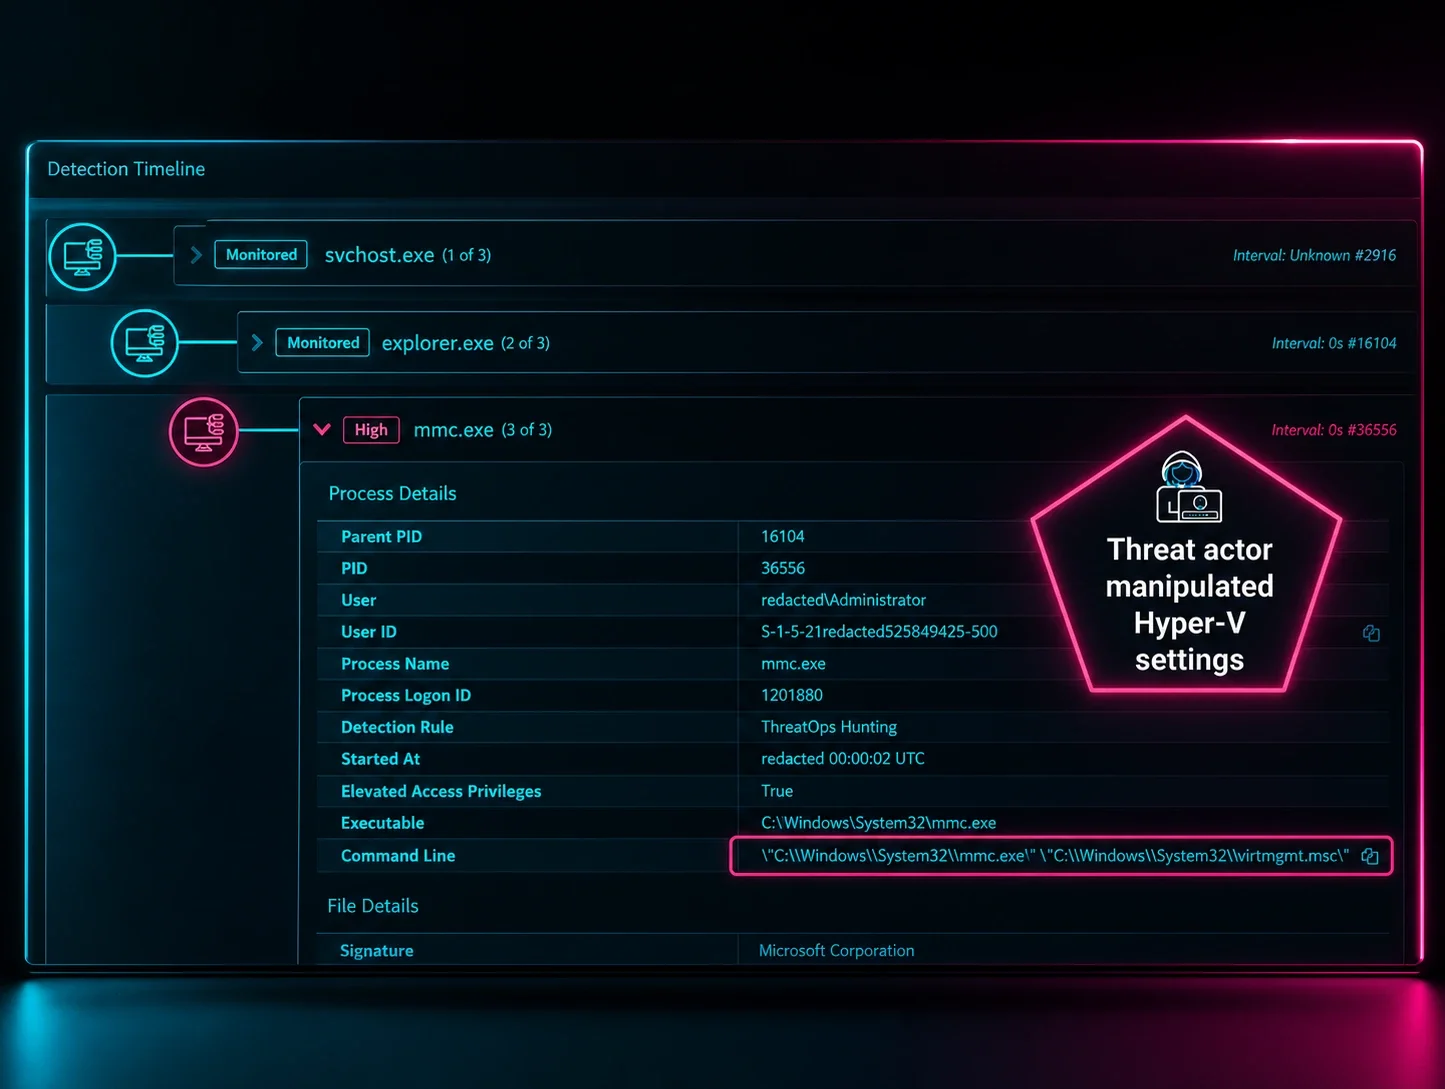
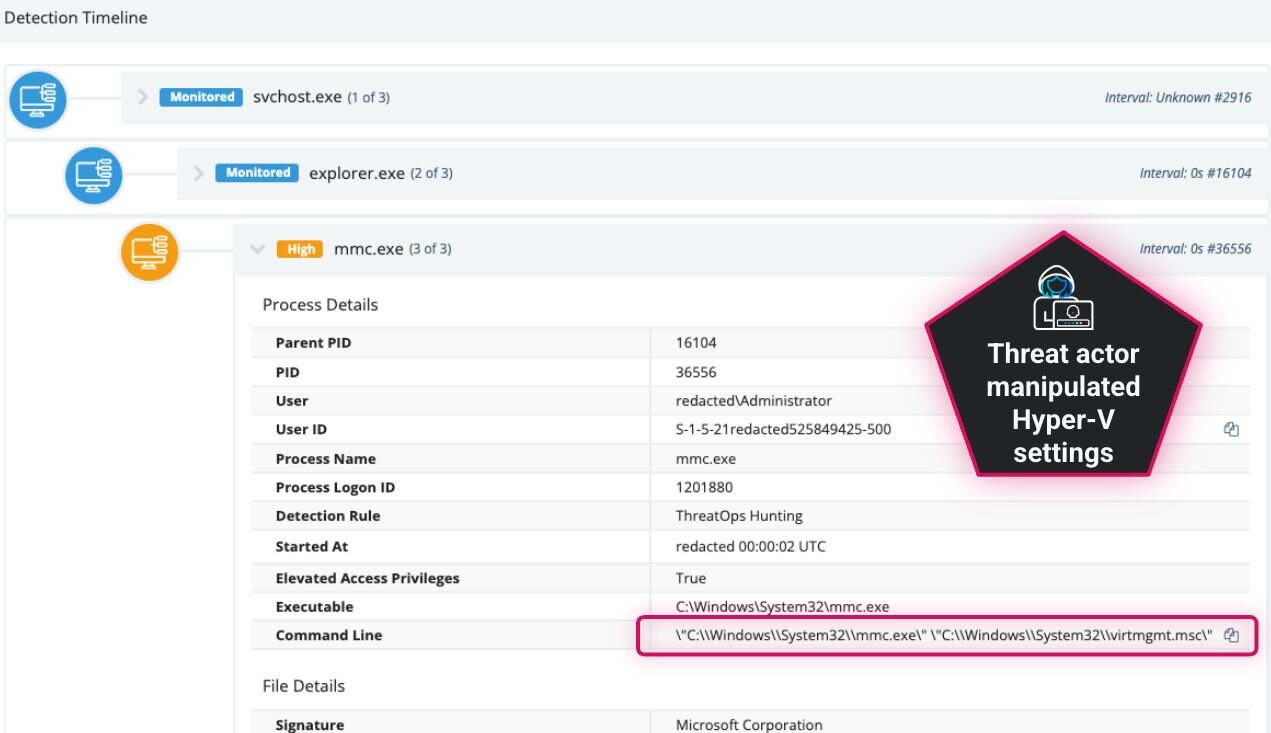
- Hemos visto el uso indebido de utilidades de administración de Hyper-V para modificar la configuración de las VM y socavar las funciones de seguridad. Esto incluye desactivar las defensas de endpoints, manipular los switches virtuales y preparar las VM para el despliegue de ransomware a gran escala.
Este cambio subraya una tendencia creciente e incómoda: los atacantes están apuntando a la infraestructura que controla todos los hosts, y con acceso al hipervisor, los adversarios amplifican drásticamente el impacto de su intrusión.
Asegura el acceso, aplica el principio de privilegio mínimo y separa el plano de administración
Si un atacante logra obtener credenciales administrativas para el hipervisor, puede desplegar cargas útiles de ransomware que afecten a todas las máquinas virtuales del hipervisor. Además, usar cuentas unidas al dominio (por ejemplo, cuentas de Active Directory (AD)) para ESXi aumenta el riesgo de movimiento lateral.
Qué hacer:
- Usa cuentas locales de ESXi. Evita usar cuentas de administrador de dominio de propósito general para la administración. En su lugar, crea cuentas locales dedicadas de ESXi o cuentas de dominio estrictamente limitadas y auditadas, con solo los permisos necesarios. Si se compromete una cuenta de administrador de dominio, esta separación evita el acceso no autorizado inmediato al hipervisor y a sus máquinas virtuales.
- Aplica la autenticación multifactor (MFA). Esto no es negociable para ninguna infraestructura crítica. Exige MFA para las interfaces de administración del hipervisor y el acceso a vCenter, para protegerte contra el robo de credenciales. Un atacante con un nombre de usuario y contraseña robados quedará bloqueado, lo que eleva significativamente el esfuerzo necesario para una vulneración exitosa. Este control ofrece una defensa sólida contra los ataques comunes de phishing y de fuerza bruta.
- Usa contraseñas sólidas guardadas en una bóveda de contraseñas segura. Las credenciales de ESXi deben ser extremadamente seguras y guardarse solo en una bóveda de contraseñas dedicada, nunca en documentos compartidos ni en ubicaciones menos seguras. Esto evita la exposición de credenciales a través de vectores de ataque comunes, como recursos compartidos comprometidos o prácticas de gestión de contraseñas poco seguras.
- Segrega la red de administración del hipervisor. Separa la red de administración del hipervisor de las redes de producción y de usuarios generales. Crea una VLAN o un segmento de red dedicado que esté separado lógica y/o físicamente. Al limitar la cantidad de endpoints que siquiera puedan intentar conectarse a la interfaz de administración del hipervisor, reduces drásticamente la superficie de ataque posible.
- Despliega un jump box o servidor bastión. Para garantizar que todo el acceso administrativo quede auditado y controlado, despliega un jump box o servidor bastión al que los administradores de TI deban acceder primero, antes de pasar al hipervisor. Esta configuración elimina las conexiones directas desde estaciones de trabajo de administradores potencialmente menos seguras. El jump box actúa como un punto de control supervisado, lo que permite grabar sesiones, registrar todos los comandos y aplicar políticas de seguridad antes de otorgar acceso a la infraestructura crítica.
- Aplica el principio de privilegio mínimo (PoLP). Limita estrictamente el acceso al plano de control (vCenter y cada hipervisor individual). Otorga solo los roles mínimos necesarios para las funciones administrativas requeridas, como la gestión de recursos o la aplicación de parches, tanto a administradores humanos como a cuentas de servicio. Aplicar PoLP garantiza que el posible compromiso de una sola cuenta no pueda aprovecharse para hacer cambios generalizados en todo el entorno virtualizado.
- Restringe el acceso de administración a dispositivos de administrador dedicados. Limita el acceso a la interfaz de administración de ESXi a dispositivos administrativos específicos con direcciones IP estáticas. Esto crea una barrera adicional, ya que solo endpoints conocidos y autorizados pueden intentar conectarse al hipervisor, lo que reduce aún más la superficie de ataque.
Bloquea el entorno de ejecución del hipervisor y aplica controles de código y ejecución
Uno de los riesgos exclusivos del ransomware a nivel de hipervisor es que, una vez que el atacante está dentro, puede ejecutar código a nivel del hipervisor, evadiendo los controles del sistema operativo invitado. Debes reforzar el hipervisor para que solo ejecute código esperado, firmado y módulos confiables.
Qué hacer:
- Habilita la configuración avanzada VMkernel.Boot.execInstalledOnly = TRUE para que solo se puedan ejecutar los binarios instalados mediante VIB firmados, lo que evita que binarios maliciosos personalizados se ejecuten en el servidor.
- Deshabilita o cierra los servicios innecesarios, como SSH o ESXi Shell, cuando no se usen; habilita el modo de bloqueo.
Mantén el hipervisor parchado, actualizado y con las superficies expuestas minimizadas
Los atacantes apuntan activamente a servidores ESXi a través de vulnerabilidades conocidas para realizar operaciones de cifrado masivo. Es poco probable que los días cero y las CVE sean la causa más común o real de un compromiso; es más probable que se trate de fallas en la segmentación de seguridad. Sin embargo, mantener los parches al día es fundamental.
Por ejemplo, CVE-2024-37085 ilustra perfectamente este riesgo del hipervisor. Esta vulnerabilidad permite que atacantes con permisos adecuados en AD eludan la autenticación y tomen de inmediato el control administrativo total de un servidor ESXi, lo que lleva al cifrado masivo de todas las VM en segundos. El exploit funciona porque los servidores ESXi vulnerables otorgan automáticamente privilegios de administrador completos al grupo de AD "ESX Admins". Los actores de amenazas simplemente recrean ese grupo para apoderarse de inmediato de las llaves del reino. Estos compromisos iniciales suelen comenzar con interfaces de administración sin parchar o protocolos expuestos, como Service Location Protocol (SLP), que ofrecen un punto de entrada de bajo esfuerzo.
Qué hacer:
- Mantén un inventario de todos los servidores ESXi (y componentes de administración asociados, como vCenter) junto con su nivel de parches.
- Prioriza los parches de seguridad y las actualizaciones del proveedor, en especial para las CVE relacionadas con el hipervisor.
- Deshabilita o restringe los servicios que no necesites, o asegúrate de que no estén expuestos externamente. Service Location Protocol (SLP/puerto 427) ha sido explotado por grupos de ransomware como ESXArgs y debe deshabilitarse. Sigue la guía oficial de remediación de VMware.
- Asegúrate de que los servidores ESXi no estén expuestos directamente a internet para su administración. Usa VPN, bastiones o redes de administración aisladas.
Estrategia de respaldo, instantáneas inmutables y capacidad de recuperación rápida
Incluso con una buena prevención, el riesgo persiste. La capa del hipervisor tiene un alto impacto; contar con un respaldo es obligatorio. Muchas guías destacan que la recuperación es la última línea de defensa. El ransomware que apunta a ESXi suele buscar cifrar los VMDK y los archivos del sistema; sin buenos respaldos, podrías verte obligado a pagar.
Qué hacer:
- Adopta la regla de respaldo “3-2-1”: ten al menos tres copias de los datos, en dos medios diferentes, y una copia fuera del sitio o fuera de la red del hipervisor.
- Usa repositorios de respaldo inmutables o instantáneas para que, una vez escritos, el ransomware no pueda modificarlos ni eliminarlos.
- No conectes tu repositorio de respaldo a Active Directory ni a ningún sistema centralizado de gestión de identidad. En su lugar, usa cuentas locales dedicadas, separadas y que no estén unidas al dominio, para evitar que una credencial de AD comprometida permita que el ransomware se propague directamente a tu ubicación de respaldo crítica.
- Asegúrate de que los respaldos incluyan imágenes completas de las VM y el estado del hipervisor asociado, para que puedas reconstruir rápidamente.
- Prueba tus respaldos con regularidad. No te limites a confirmar que puedes montar un respaldo y acceder a los archivos; asegúrate de que el sistema operativo inicie por completo y de que puedas iniciar sesión con credenciales conocidas.
- Realiza simulacros de recuperación completa al menos una vez al año. Las suposiciones provocan períodos más largos de inactividad. Aquí tienes algunas consideraciones adicionales:
- ¿Has hecho pruebas en tus ubicaciones externas o de conmutación por error?
- ¿Puedes confirmar que tus servidores tienen la conectividad y configuración de red correctas? ¿Puedes acceder a estos servidores de conmutación por error desde endpoints de producción?
- ¿El firewall del sitio de respaldo o de la ubicación de conmutación por error ya cuenta con las reglas de inclusión en la lista de aceptados y de firewall necesarias para garantizar la comunicación adecuada desde herramientas críticas, como EDR, RMM y clientes VPN?
Monitorea, detecta anomalías y asume que hay una brecha (defensa en profundidad)
Dado que la capa del hipervisor suele ser menos visible para las herramientas tradicionales de seguridad de endpoints, como EDR, necesitas una estrategia de detección alternativa. Los atacantes a menudo realizan acciones como cambiar el nivel de aceptación de VIB, activar SSH, desactivar el modo bloqueo o crear nuevas cuentas de administrador, como pasos previos a la implementación del payload de ransomware. Sin monitoreo, es posible que solo detectes el evento después de que el cifrado haya finalizado.
Qué hacer:
- Reenvía los registros de ESXi a tu SIEM y crea alertas para eventos sospechosos clave (como nuevos inicios de sesión root, habilitación de servicios, cambios en la aceptación de VIB, desmontajes de datastores).
- Monitorea las configuraciones para detectar desviación de configuración. Si algún servidor ESXi tiene el modo de bloqueo deshabilitado, SSH habilitado o execInstalledOnly desactivado, márcalo para revisión.
- Gestión de registros del tráfico de red. ¿Recuerdas que antes recomendamos poner ESXi y otros planos de control de infraestructura crítica en su propia VLAN o segmento de red? Ahora es momento de buscar direcciones IP de origen inusuales que accedan a la interfaz de gestión del hipervisor (lo ideal es que solo permitas tráfico desde tu servidor de salto), intentos de movimiento lateral o patrones de E/S de datastores a gran escala, consistentes con el cifrado de VM.
- Usa una mentalidad de confianza cero para la gestión del hipervisor, asume que las credenciales podrían estar comprometidas y crea alertas en función de eso.
- A diferencia de los formatos tradicionales de syslog, ESXi separa los registros por actividades específicas en archivos distintos. Los siguientes son los archivos de registro más críticos para detectar e investigar compromisos del hipervisor: /var/log/auth.log (eventos de autenticación), /var/log/hostd.log (actividad del agente del servidor ESXi), /var/log/shell.log (comandos de shell de ESXi) y /var/log/vobd.log (demonio observador de VMware). Para obtener orientación sobre la configuración de registros, consulta la documentación de Broadcom y las estrategias de defensa de ESXi de Sygnia.
Al asociarte con un SOC externo o un proveedor de MDR, considera establecer un modelo de responsabilidad compartida. Tu socio de seguridad externo no tendrá el contexto empresarial necesario para distinguir el mantenimiento interno de rutina de un atacante que entra a las 2 a. m. Esta distinción es fundamental: el SOC externo está mejor posicionado para detectar el mal universal, como la ejecución del ransomware en sí. Para complementar esto, recomendamos que tu equipo de seguridad interno se enfoque en monitorear amenazas internas y acciones que solo ellos pueden contextualizar, como un inicio de sesión nocturno seguido de la habilitación de SSH. Para que este modelo funcione, los equipos de TI deben seguir estrictamente los procedimientos de control de cambios y comunicar todos los cambios esperados del hipervisor al equipo de seguridad interno. Esto garantiza que el SOC esté al tanto de toda la actividad prevista, lo que permite a todas las partes concentrar sus esfuerzos donde son más efectivos.
Conclusión
Proteger hipervisores bare-metal como ESXi del ransomware requiere un enfoque proactivo y en capas. Desde la aplicación de parches y el control de acceso, pasando por el endurecimiento de la seguridad en tiempo de ejecución y la preparación para la recuperación, hasta la detección y los registros, necesitas cubrir todos los ángulos. Si necesitas una guía más completa para prepararte para lo peor, revisa nuestra guía de planificación de recuperación ante desastres. Ahora es el momento de que tu organización se pregunte: ¿cuándo fue la última vez que actualizamos y probamos por completo nuestros IRP y DRP, confirmando específicamente la capacidad de restaurar y ejecutar todas las máquinas virtuales invitadas?
A pesar de nuestros mejores esfuerzos de prevención y detección, las organizaciones también deben prepararse para la posibilidad de un compromiso exitoso. Si te encuentras respondiendo a un entorno ESXi comprometido, te recomendamos revisar esta completa guía de IR para ESXi. La guía ofrece procedimientos detallados de respuesta a incidentes y artefactos forenses, diseñados específicamente para entornos ESXi.
Al usar Huntress, es posible que ya apliques muchas de estas medidas en la capa de SO/endpoint; pero el hipervisor exige el mismo rigor (y a menudo más) debido a su potencial de impacto masivo. Si incorporas la orientación de defensa de este artículo en tu entorno y procesos de seguridad, elevas significativamente la barrera para los actores de ransomware.