

Antecedentes
El 29 de marzo de 2023, CrowdStrike publicó una publicación en redes sociales y luego un blog de seguimiento que describe una vulneración de la cadena de suministro relacionada con el software softphone 3CXDesktopApp. El posterior análisis e investigación indicó una intrusión compleja y de múltiples etapas en la cadena de suministro, de duración indeterminada e impacto desconocido. Como se muestra a continuación, la preparación de este evento (en particular, la creación de infraestructura de red asociada con la cadena de infección) se remonta a principios de 2022 en algunos casos, con una acción más extensa que comenzó a principios de diciembre de 2022.
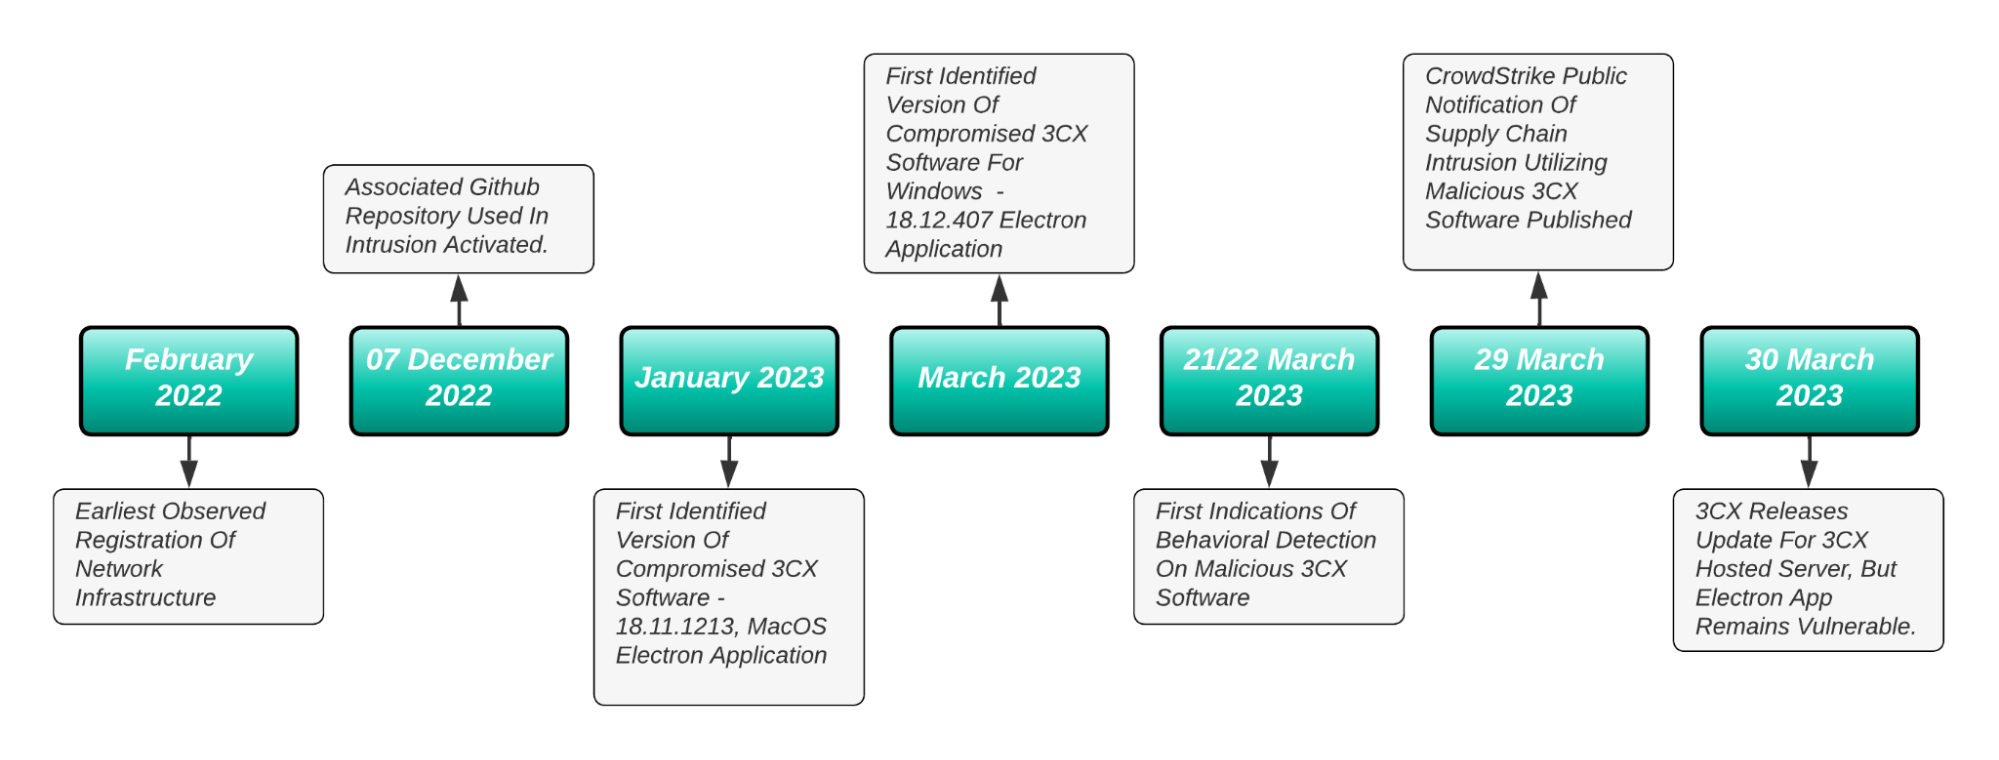
Línea de tiempo de eventos relacionados con 3CX
Los primeros informes indican detección basada en comportamiento de actividad sospechosa en torno a 3CXDesktopApp en entornos Windows a partir del 21 y 22 de marzo de 2023. Sin embargo, el posterior informe de 3CX indica que las primeras versiones vulnerables del software aparecieron en enero de 2023 con la aplicación Electron para macOS 18.11.1213. Por lo tanto, la actividad real basada en versiones vulnerables podría remontarse a enero de 2023, al menos en entornos macOS, con acciones posteriores en entornos Windows en marzo de 2023 que resultaron en su identificación.
Como indicó el director ejecutivo de 3CX en una entrevista con CyberScoop,
“La versión para macOS solo tiene un par de miles de usuarios”.
Por lo tanto, una posibilidad es que el acceso inicial y la modificación comenzaran con la versión menos extendida de macOS, lo que generó una actividad mucho menor en un sistema operativo que típicamente presenta un menor grado de monitoreo, antes de que se implementara una variante para Windows con las actualizaciones de marzo (18.12.407 y 18.12.416). En ese momento, la extensión a una base de instalación mucho más grande (que también suele contar con un mayor grado de monitoreo por herramientas de seguridad) dio lugar a la identificación y las tareas de mitigación posteriores.
Al momento de escribir esto, queda mucho por aprender sobre este evento, entre otras cosas, cuál fue el propósito de esta intrusión en la cadena de suministro. La entidad identificada por CrowdStrike como responsable, Labyrinth Chollima (también referida de manera más general, amplia y potencialmente problemática como “Lazarus Group”), está vinculada a operaciones cibernéticas que van desde el espionaje tradicional hasta el robo de criptomonedas y los ataques destructivos. Como resultado, el posible desenlace de esta intrusión podría variar ampliamente, y dado el gran número de clientes de 3CX, es fácil plantear un caso de uso para cada uno en un conjunto de objetivos tan grande y variado.
Curiosamente, la función inicial principal del payload distribuido con la actualización maliciosa de 3CXDesktopApp parece ser la recopilación de información del navegador. Si bien esto podría aprovecharse para recolectar elementos como contraseñas guardadas, tokens de acceso e información similar, el análisis actual indica que este robo de información se centra en recopilar el historial de navegación. Como señalaron los investigadores de Volexity, es posible que este mecanismo se use para “tomar la huella digital” de los endpoints infectados y así permitir la clasificación y selección de cuáles ameritan operaciones adicionales.
Independientemente de la atribución, la motivación y el propósito, el incidente en cuestión contiene múltiples lecciones en cuanto a intrusiones en la cadena de suministro, posibilidades defensivas y operaciones de respuesta de las organizaciones. Si bien anticipamos que en las próximas semanas y meses surgirá información adicional sobre esta campaña, ya hay suficientes elementos disponibles para orientar a los defensores sobre qué posibilidades existen para contrarrestar una actividad como la de este incidente y garantizar la continuidad de las operaciones frente a las ciberamenazas basadas en la cadena de suministro.
Contextualización de las intrusiones en la cadena de suministro
Las intrusiones en la cadena de suministro tienen cierta mística dentro de los círculos de seguridad de la información. Incidentes de cadena de suministro, como el que involucró al software SolarWinds Orion en 2020, acaparan titulares importantes y mantienen un aire de invencibilidad. Si un adversario logra inyectar una capacidad en una aplicación legítima, la imaginación popular supone que tales intrusiones se vuelven casi imposibles de detectar o mitigar, otorgando a los adversarios una ventaja casi inatacable.
Sin embargo, como se señaló en investigaciones previas, las intrusiones en la cadena de suministro son más matizadas de lo que muchos creen. Los intrusos deben completar dos intrusiones: una en la organización o entidad que servirá como “vector”, y luego otra a través de esa entidad hacia los objetivos reales de interés. Además, si bien la implementación desde el mecanismo de la cadena de suministro hacia las víctimas puede ser automatizada o relativamente sencilla, una explotación generalizada puede terminar “alertando” a los analistas y defensores. Los enfoques más sutiles de selección y entrega, mediante diversas verificaciones y otros elementos, pueden ser más sigilosos, pero como se observó en el payload SUNBURST inyectado en SolarWinds Orion, incluso estos dejarán artefactos para su seguimiento, como las conexiones de red anómalas usadas para la identificación de víctimas en esa campaña.
Las intrusiones en la cadena de suministro, aunque difíciles de identificar, no son inmunes a la identificación por parte de los defensores. Más interesante aún, tales intrusiones pueden ser tan difíciles de convertir en armas exitosas por parte de los adversarios como lo es para los defensores identificar su presencia inicial.
En este caso, nos enfocamos en las dependencias del adversario. Un mecanismo de intrusión en la cadena de suministro entrega un implante o algún mecanismo de acceso a una entidad dentro de la red de la víctima. Para que ese punto de acceso sea útil o procesable, el adversario debe cumplir una de dos posibilidades: desarrollar una forma de comunicarse con éxito con ese nuevo punto de acceso para garantizar el comando y control (C2); o crear una capacidad que pueda operar casi de forma autónoma dentro de los entornos de la víctima para evitar la necesidad de un control directo. La primera opción implica que los mecanismos clásicos de monitoreo de actividad de C2, como identificar dominios nuevos o anómalos o el análisis y monitoreo del tráfico de red, pueden identificar el punto de acceso y la actividad relacionada. La segunda, aunque potencialmente muy poderosa, es muy difícil de desarrollar y puede resultar en que dicha herramienta sea "demasiado agresiva" (y así se propague en exceso y revele su presencia), o "no lo suficientemente agresiva" (lo que lleva a una misión fallida).
A medida que seguimos profundizando en las dependencias y los requisitos del ciclo de vida del intruso para lograr sus objetivos, surgen cada vez más puntos de contacto, como los descritos anteriormente, para identificar, mitigar o incluso prevenir dicha actividad. Al considerar estas opciones, la balanza comienza a inclinarse de manera significativa, pasando de una percepción inicial de ventaja abrumadora del intruso a una posible equivalencia, o incluso a identificar una clara superioridad del defensor en entornos bien diseñados e instrumentados.
Orientar las acciones del adversario en el espacio y el tiempo
Con base en lo anterior, un compromiso en la cadena de suministro, salvo en el raro caso en que dicha capacidad sea totalmente autónoma y esté diseñada para afectar directamente el dispositivo, software u otro elemento que también se aprovecha para el acceso, se vuelve inútil sin cumplir su propósito de lograr los objetivos del adversario. Como se destaca a continuación, las operaciones del adversario ocurren a través del tiempo y del "espacio" de la red. Toda intrusión requiere avanzar por varios pasos, generalmente definidos en la Cyber Kill Chain, desde la recopilación inicial de información hasta las acciones finales sobre los objetivos.
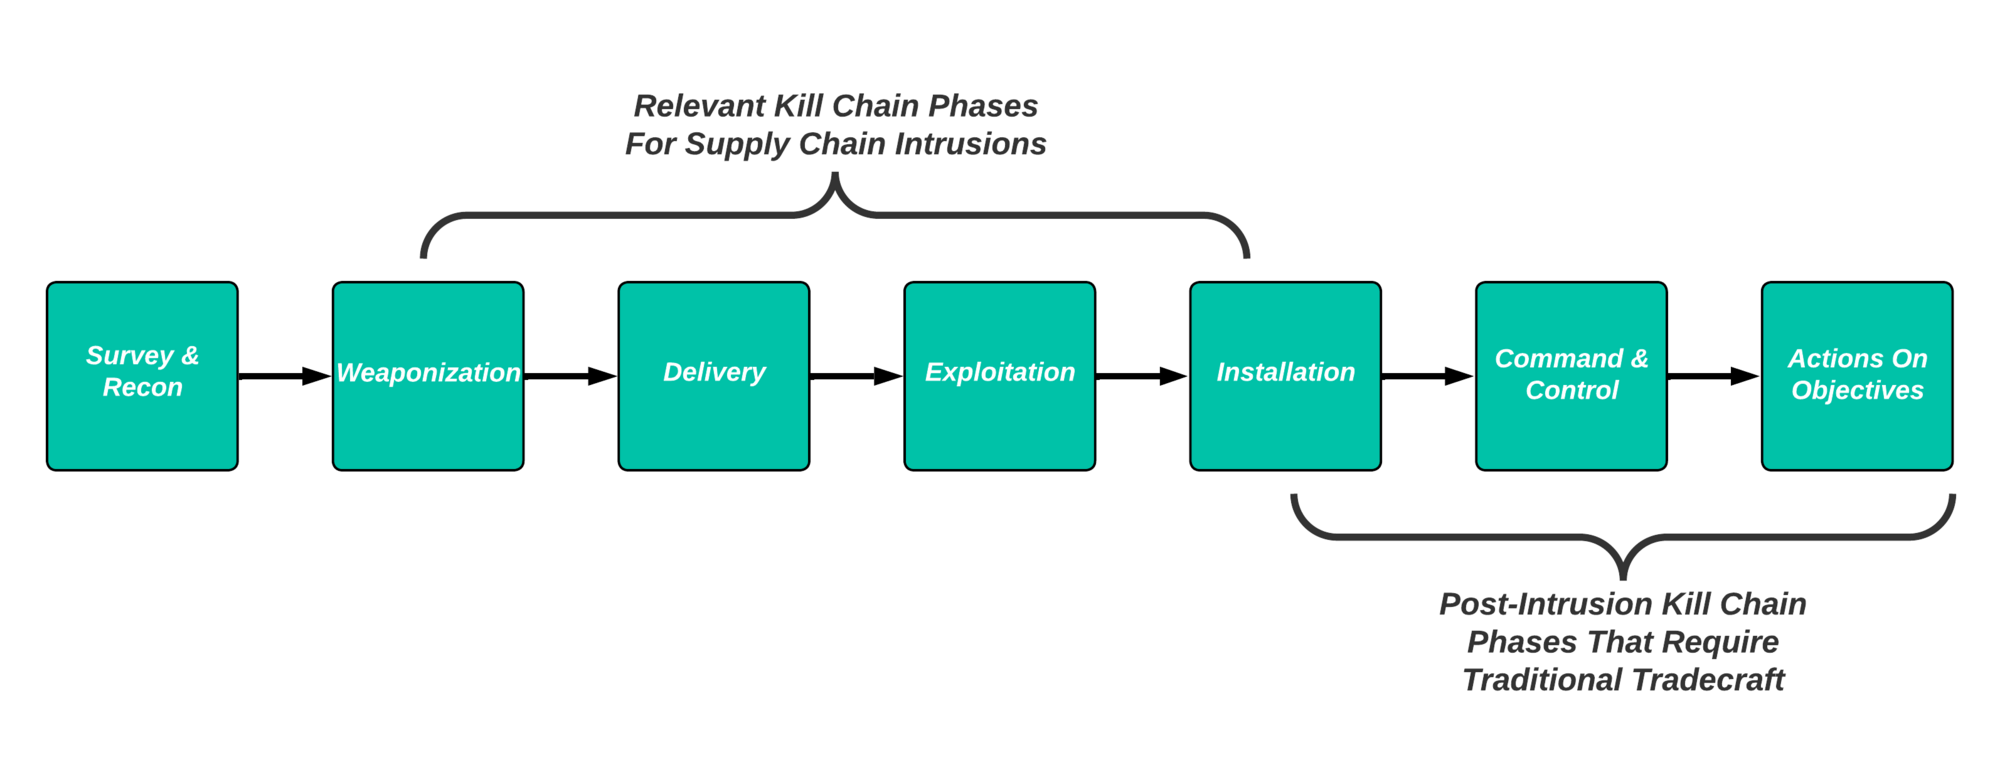
Mapeo de intrusiones en la cadena de suministro según la Cyber Kill Chain
Al observar lo anterior, las intrusiones en la cadena de suministro ciertamente forman parte de esta secuencia de eventos, y en algunos casos pueden resultar en mecanismos muy efectivos y difíciles de detectar para cumplir con las etapas preliminares de las operaciones. Sin embargo, sin capacidades autónomas que no requieran más intervención del operador, ese implante necesitará comunicación posterior. Incluso en el caso de una capacidad autónoma, esta necesitará moverse a través de la red de la víctima para alcanzar los objetivos finales y lograr sus metas.
Todas estas acciones transforman la intrusión de una evasión sigilosa y difícil de detectar de múltiples capas defensivas en un compromiso más típico de post-explotación. Incluso en casos de alto perfil anteriores, como la intrusión en la cadena de suministro de SolarWinds Orion, los intrusos pasaron de un punto de acceso inicial logrado a través del vector de la cadena de suministro al uso de Cobalt Strike Beacon para actividades de post-explotación. Otros mecanismos, como la recolección de credenciales para abusar de inicios de sesión remotos, tareas programadas remotas, mecanismos basados en PowerShell y WMI, y otras técnicas estándar de movimiento lateral, son igual de relevantes. Los defensores pueden perder algo de iniciativa en el sentido de que las "defensas perimetrales" se evaden mediante una intrusión en la cadena de suministro, pero las defensas en capas, incluida la visibilidad interna de la red y los equipos, seguirán siendo efectivas para identificar la actividad posterior al compromiso.
Cabe destacar que existen excepciones a lo anterior. Por ejemplo, el compromiso en la cadena de suministro de Kaseya en 2021 resultó en un movimiento directo y cronometrado desde el acceso inicial a los servidores locales de Kaseya VSA hasta afectar a los clientes con ransomware. En efecto, esto representa un caso de un payload casi autónomo que afecta directamente a los mismos sistemas en los que está instalado el software comprometido. En estos casos, la defensa se vuelve significativamente más difícil, especialmente dados los permisos y la inclusión en la lista de aceptados generalizada asociada con herramientas de gestión y mantenimiento remoto (RMM) como Kaseya VSA. Las operaciones defensivas aquí se vuelven más limitadas y requieren decisiones difíciles respecto a hasta qué punto se debe confiar en dichas aplicaciones y cuánto poder se debe otorgar a los productos de seguridad que puedan identificar el abuso de estos productos, pero que, en el proceso, también podrían afectar operaciones legítimas al actuar de forma preventiva.
Diseñar e implementar la defensa
Si bien existen excepciones como el evento de Kaseya, en general los compromisos en la cadena de suministro requieren que los adversarios cumplan múltiples requisitos interconectados e interdependientes para lograr el éxito de su misión. El énfasis en la visibilidad, las defensas en capas y la implementación de planes de emergencia para la continuidad del negocio son factores clave para prepararse y responder ante compromisos de cualquier tipo, incluidos los vectores de la cadena de suministro.
La defensa en profundidad centrada en posibles desafíos de la cadena de suministro comienza por entender el entorno defendido:
- ¿Qué software está instalado?
- ¿Qué versiones se usan actualmente?
- ¿Qué funciones cumplen estos elementos?
Desarrollar y mantener un inventario razonable de activos y aplicaciones puede agilizar la respuesta y la recuperación en caso de un incidente en la cadena de suministro. Poder determinar rápidamente si la organización se ve afectada, y en qué medida, puede generar eficiencias significativas en el proceso de respuesta, mitigación y recuperación, ayudando en todos los pasos siguientes. En muchos casos, las organizaciones dedican tiempo valioso a intentar determinar si siquiera se vieron afectadas en escenarios como el evento de 3CX, tiempo que podría usarse mejor para aislar activos y comenzar la recuperación.
Una vez determinados la aplicabilidad y el alcance, los defensores pueden avanzar hacia los pasos de mitigación y respuesta. Esto incluye poder realizar un análisis de causa raíz (RCA) sobre cualquier actividad identificada que pueda estar asociada con la instalación de software modificado o vectores similares de la cadena de suministro. Por ejemplo, los defensores deben poder identificar cualquier intento de "escapar" y moverse lateralmente desde el activo potencialmente comprometido, lo que indicaría que una intrusión "con manos en el teclado" ha ocurrido o está ocurriendo actualmente. De manera similar, revisar los registros de red del activo potencialmente comprometido puede identificar posibles canales de C2 o exfiltración que indiquen el éxito del adversario.
Los entornos maduros y bien instrumentados pueden aplicar algunos de estos mecanismos para identificar intrusiones en la cadena de suministro a medida que ocurren, siempre que se lleve a cabo una investigación adecuada. Por ejemplo, un entorno con una clasificación de activos adecuada podría identificar actividad de red externa irregular o intentos de autenticación (o actividad de movimiento lateral similar) desde un servidor hacia clientes u otros dispositivos, lo que indicaría acciones inesperadas desde ese dispositivo, como en el escenario de SolarWinds SUNBURST. Para circunstancias como las de los usuarios de 3CXDesktopApp, identificar cadenas de procesos anómalas, relaciones de procesos padre-hijo o similares, aunque sea difícil, puede señalar actividad potencialmente maliciosa de interés para una investigación más profunda.
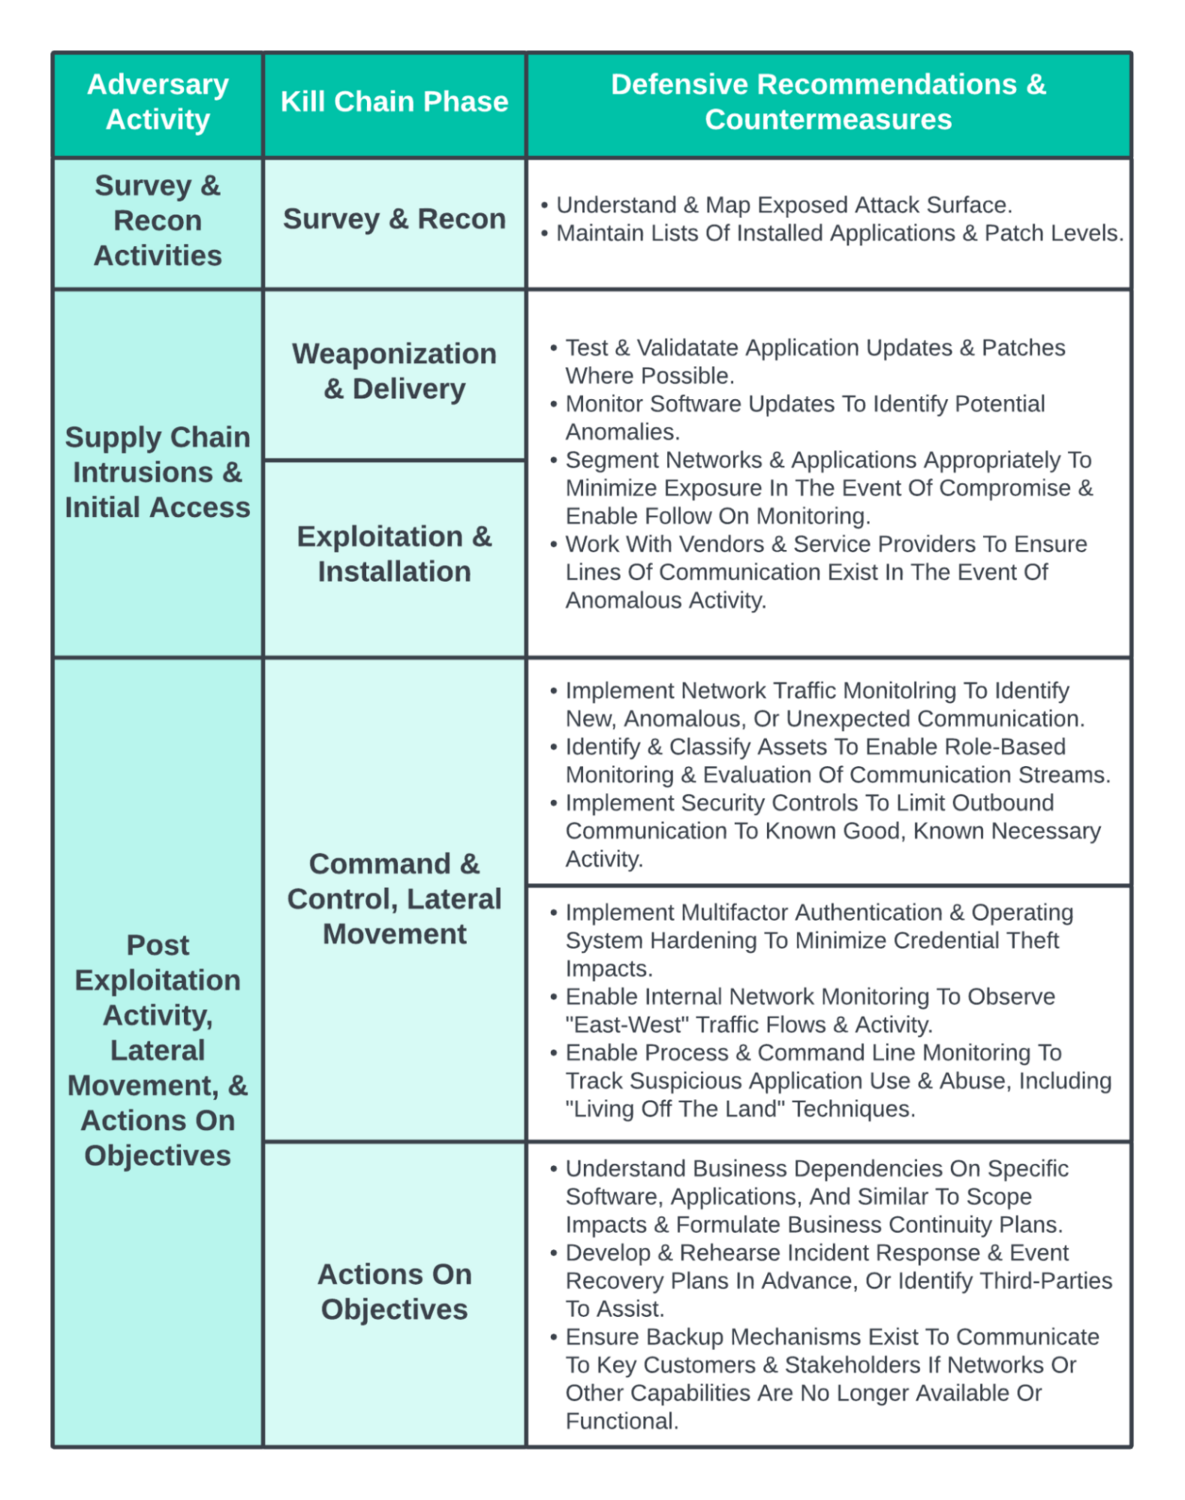
Revisión de los pasos defensivos a través de las fases del adversario y la cadena de eliminación
Una advertencia importante sobre las recomendaciones anteriores es que nada de esto es fácil. Si bien las organizaciones maduras con recursos de seguridad significativos pueden (y deben) esforzarse por implementar lo anterior, no es el caso de las organizaciones más pequeñas o las entidades con recursos limitados. Para ejemplos como los servicios de telefonía de 3CX, estas aplicaciones tienen un uso generalizado tanto en entornos empresariales como de pequeñas empresas, lo que significa que la capacidad de respuesta ante tales eventos variará mucho. Las organizaciones con recursos limitados deberían priorizar la gestión de la superficie de ataque para minimizar y comprender el riesgo residual, e identificar socios comerciales y públicos que puedan ayudar en caso de que se produzca un compromiso, cuando sea posible. Pero lo más importante para todas las entidades es extender la planificación y ejecución de la respuesta hacia la continuidad y recuperación del negocio.
Equilibrio entre seguridad y funcionalidad del negocio
Si se identifica una vulneración y se delimita adecuadamente su alcance, la remediación requiere no solo recuperar los sistemas afectados y restaurar las operaciones, sino hacerlo de una manera que mantenga la funcionalidad y continuidad del negocio en la mayor medida posible. En el caso del software de 3CX, esta aplicación representa un componente crítico de la funcionalidad empresarial principal: la comunicación telefónica. Aunque la evidencia es incompleta por el momento, la revisión preliminar de las respuestas iniciales a los servicios antimalware que pusieron en cuarentena las aplicaciones de 3CX el 21 y 22 de marzo, sin dar una explicación o contexto significativo sobre por qué se tomó esta acción, resultó en que las organizaciones optaran por la inclusión en la lista de aceptados de la aplicación para garantizar la continuidad de las operaciones.
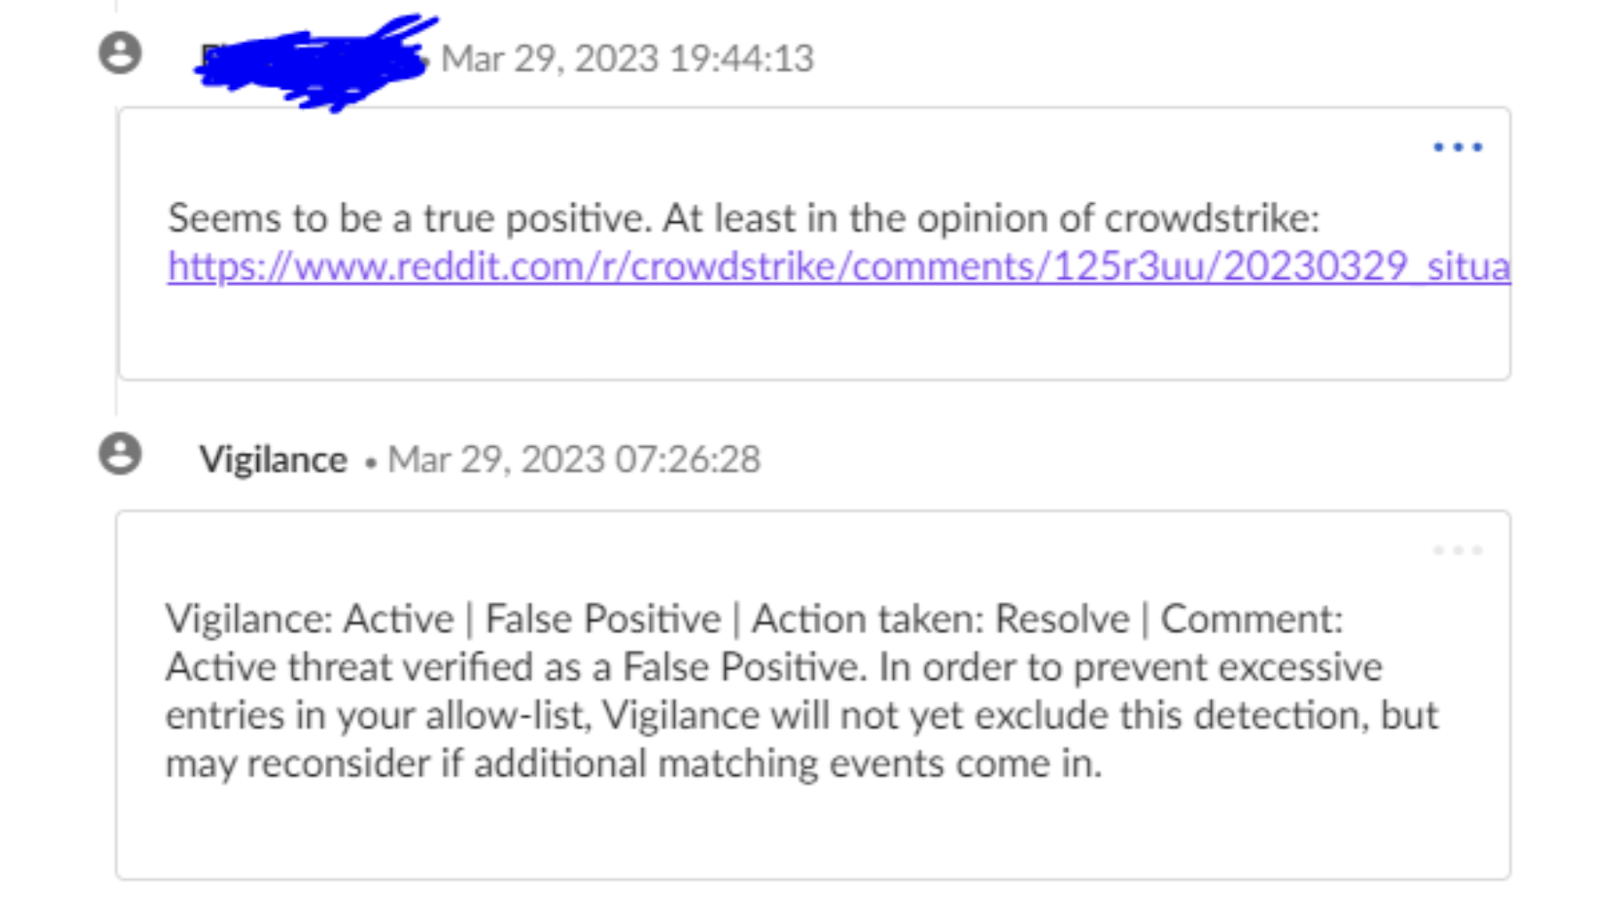
Ejemplo de comunicaciones sobre la identificación de antimalware en 3CXDesktopApp
Muchos quizás deseen realizar una evaluación posterior al incidente, tipo "lecciones aprendidas", ya que muchas organizaciones, incluidas entidades externas de organizaciones de seguridad y administradores de plataformas de sistemas, fallaron en este caso al permitir que la situación continuara durante varios días desde la identificación inicial. Algunos incluso podrían sentirse tentados a culpar a las víctimas por permitir que esta actividad ocurriera después de las notificaciones de seguridad iniciales y ambiguas. Sin embargo, los analistas, los propietarios de activos y los usuarios finales deben entender la necesidad de equilibrar la continuidad de las operaciones con la seguridad organizacional. Sin un análisis de causa raíz exhaustivo y documentado como se describió anteriormente, algo que varias partes no lograron hacer durante varios días, este tipo de eventos seguirán ocurriendo, y sin el contexto adecuado debemos asumir que los dueños del negocio optarán por mantener la disponibilidad de las aplicaciones críticas.
Dicho esto, las organizaciones deben planificar la pérdida o degradación de dichos servicios para permitir una toma de decisiones adecuada, basada en el riesgo, en el futuro, como parte de su plan de respuesta ante incidentes de seguridad identificados (o sospechados). En el caso de 3CX, los clientes tienen la opción de cambiar de la aplicación de escritorio a versiones basadas en el navegador para garantizar la continuidad operativa.
En este caso, las opciones de 3CX pueden minimizar la posible interrupción. Pero las organizaciones deben evaluar el alcance de los servicios críticos y planificar su pérdida o degradación con anticipación, en múltiples sistemas y funciones. No hacerlo significa que un incidente de seguridad se convierta de un evento de TI en un evento que podría afectar la supervivencia continua de la organización.
Conclusiones
Las intrusiones en la cadena de suministro son problemas difíciles, pero no imposibles de contrarrestar o identificar. Si bien el incidente de 3CXDesktopApp sigue desarrollándose y queda mucho por aprender sobre este evento, incluyendo cómo se vio comprometido el propio 3CX y cuáles eran las intenciones del adversario con esta intrusión, los defensores pueden adoptar un conjunto de controles, acciones y sugerencias de planificación comunes para minimizar el impacto de este y futuros eventos en la cadena de suministro.
Más importante aún, comprender las relaciones entre las aplicaciones y sus implicaciones para las operaciones puede ser vital en la planificación avanzada y la acción defensiva para minimizar el daño y la interrupción potenciales. Históricamente, algunos eventos en la cadena de suministro, como el incidente de Kaseya, resultaron en impactos casi inmediatos en términos de implementación de ransomware. En el caso de 3CXDesktopApp, el rápido movimiento desde la acción inicial hasta los efectos podría haber llevado a resultados que van desde ransomware hasta la implementación de un wiper destructivo.
Afortunadamente, una vez que la comunidad en general tomó conciencia de los eventos y pudo contextualizarlos adecuadamente tras la divulgación de CrowdStrike, múltiples entidades pudieron trabajar juntas para investigar, evaluar y potencialmente contener esta amenaza antes de que se pudieran cumplir sus objetivos. Queda mucho trabajo por hacer, y se recomienda encarecidamente a los clientes de 3CX seguir las indicaciones actuales de la empresa para migrar sus operaciones a su plataforma basada en navegador. Pero en ausencia de interrupciones inmediatas y dislocaciones del negocio, este y otros eventos similares ofrecen ejemplos de cómo y por qué las organizaciones deben invertir en la visibilidad y las capacidades defensivas necesarias para identificar, contener y responder a futuras intrusiones en la cadena de suministro.