

El incidente de Stryker de marzo de 2026 no fue solo otro titular para ojear con el café de la mañana. Como alguien que dedica su tiempo a ayudar a líderes a navegar las consecuencias de desastres digitales, puedo decirte que este es un momento decisivo.
Durante años, hemos hablado del ransomware como el "jefe final" del riesgo corporativo. Stryker nos ha demostrado que existe algo más rápido, más permanente y mucho más difícil de recuperar: el borrado remoto convertido en arma.
Primero, ¿qué es Stryker?
Stryker es un gigante de la tecnología médica valuado en $25 mil millones, con más de 56.000 empleados en más de 60 países. Son el pilar de la atención médica moderna y proveen desde robótica quirúrgica hasta desfibriladores.
Cuando una empresa de esta magnitud queda fuera de línea, no es solo un "problema de TI". Es una crisis de seguridad del paciente. Si los hospitales no pueden recibir clavos quirúrgicos o piezas de repuesto, las cirugías se posponen. Este incidente se ubica en la intersección volátil entre la ciberseguridad, la logística global y la salud humana real.
El ataque: cuando tu escudo se convierte en espada
Aunque Stryker aún no ha confirmado los detalles técnicos exactos, lo reportado sugiere una "tormenta perfecta". Los atacantes (vinculados al grupo pro-Irán Handala) no necesitaron evadir su firewall con malware complejo. En cambio, según los reportes, evadieron el plano de identidad.
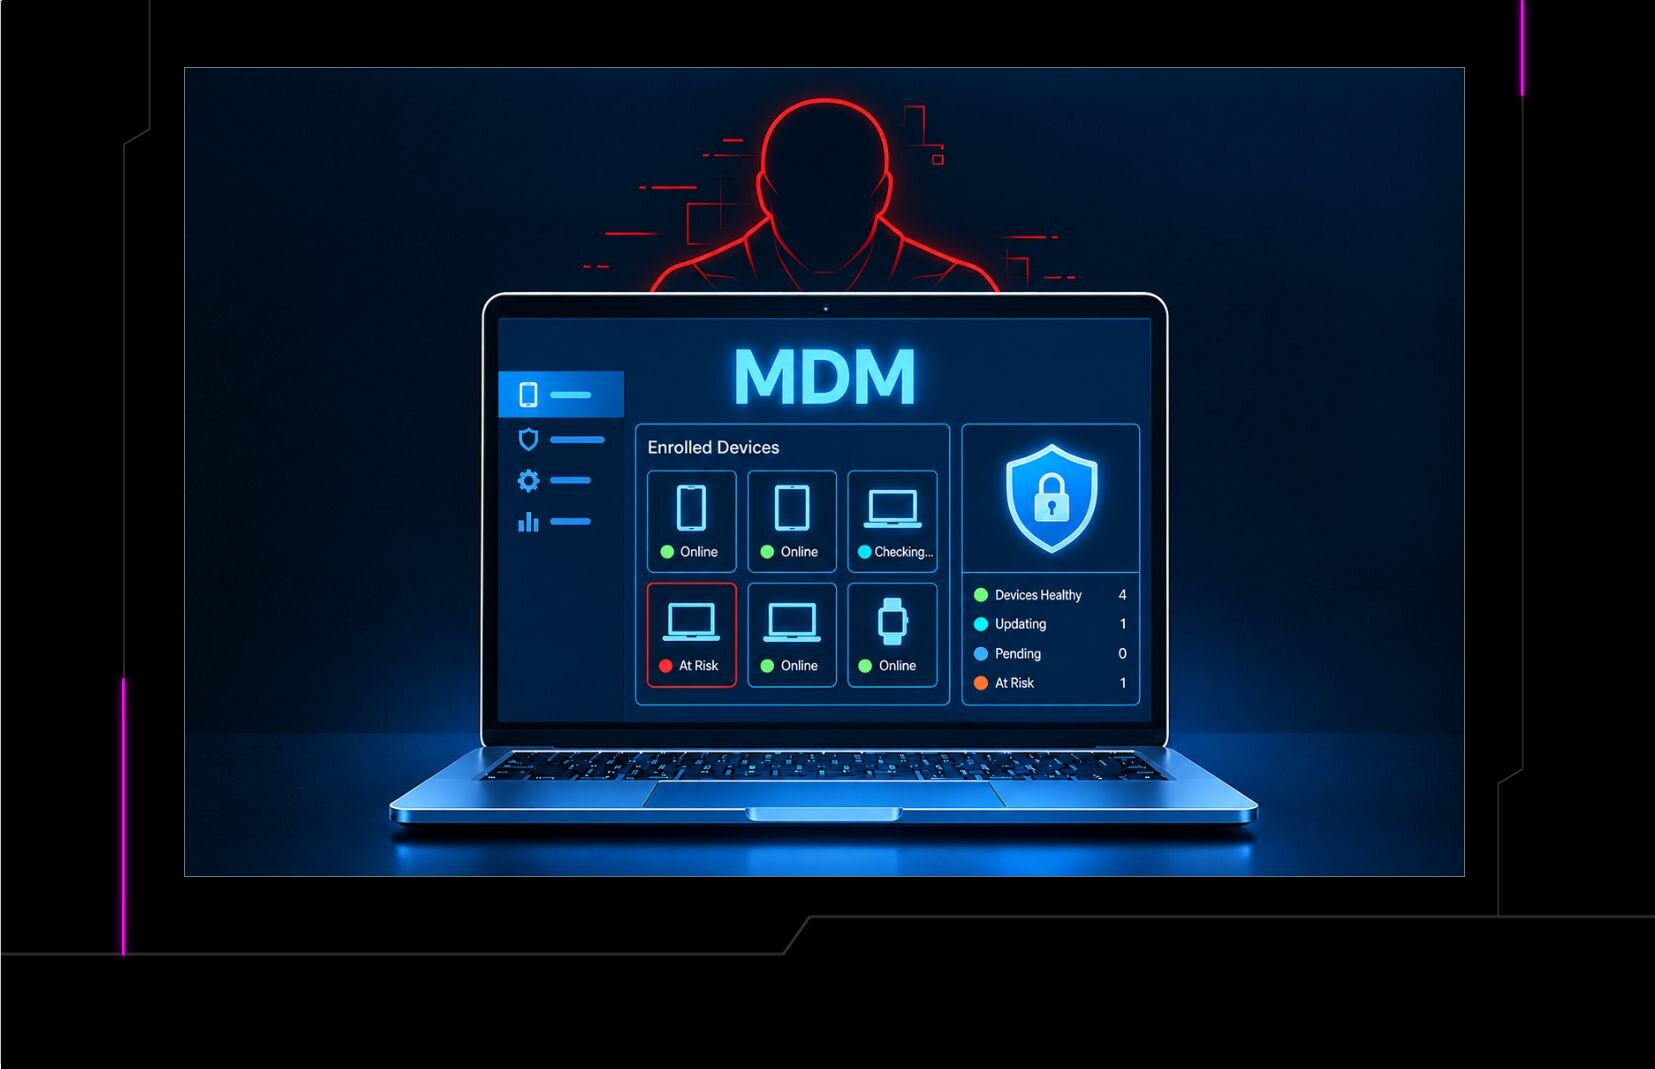
- El secuestro: Es probable que los atacantes obtuvieran acceso privilegiado al entorno de Microsoft Intune/MDM de Stryker, la misma herramienta usada para gestionar y proteger su flota global.
- El borrado: Emitieron un comando de "borrado remoto" a una escala sin precedentes. Los reportes sugieren que hasta 200.000 dispositivos, desde laptops corporativas hasta iPhones de propiedad de los empleados, fueron restaurados a configuración de fábrica en minutos.
- El robo: Mientras se borraban los sistemas, los atacantes afirmaron haber exfiltrado 50 terabytes de I+D, planos y tecnología médica propietaria.
Esto es una falla estructural de confianza. Las herramientas que tratamos como medidas de seguridad rutinarias se convirtieron en un botón de destrucción masiva.
Por qué esto es significativo
Este es el primer caso de alto perfil donde tres fuerzas se alinearon de forma tan visible:
- Guerra geopolítica "híbrida": Esto no fue por un rescate. Fue un ataque de represalia vinculado a tensiones en Medio Oriente. El Centro Nacional de Seguridad Cibernética (NCSC) del Reino Unido ya advirtió que las redes corporativas ahora son daño colateral en conflictos internacionales.
- No es una "restauración" sino una "reconstrucción": Esto no es una recuperación de ransomware donde ingresas una clave para descifrar. Una restauración de fábrica significa que los datos, las apps y las configuraciones desaparecen. Ahora estás "inutilizado".
- El costo humano: Debido a que los teléfonos personales estaban inscritos en el MDM corporativo, los empleados reportaron haber perdido años de fotos personales y mensajes privados. Esto crea una responsabilidad legal y de recursos humanos inmediata y masiva.
Las consecuencias: clientes, socios y pacientes
El impacto aquí es existencial a corto plazo y reputacional a largo plazo.
- Parálisis en la cadena de suministro: El Servicio Nacional de Salud del Reino Unido (NHS) ya confirmó que Stryker actualmente no puede recibir pedidos. Los sistemas cotidianos están caídos, se pierden millones en ingresos y componentes médicos críticos quedan atrapados en almacenes.
- La montaña de la recuperación: Estabilizar las operaciones tomará semanas. ¿Una restauración completa de una flota de 200.000 dispositivos? Ese es un trayecto de tres a seis meses. No puedes transferir físicamente esa cantidad de datos por internet a cada oficina en casa y hospital al mismo tiempo sin saturar la red.
- El martillo regulatorio: Con 50 TB de datos confidenciales potencialmente vulnerados, Stryker enfrenta un escrutinio regulatorio global bajo ciertas regulaciones, lo que podría generar multas de hasta el 4% de su facturación global.
Cinco pasos concretos para tomar ahora
Estas son acciones que puedes empezar a implementar de inmediato, sin importar tu tamaño o sector.
1. Trata tus plataformas de gestión como joyas de la corona
Todo lo que pueda implementar software, aplicar configuraciones o borrar dispositivos debe protegerse como un activo de alto valor.
- Bloquea las consolas de Intune / MDM / RMM / EDR y los portales de administración en la nube
- Usa MFA resistente a phishing (llaves de seguridad FIDO2) para todas las identidades con privilegios altos; el SMS y el MFA básico basado en apps no bastan contra el secuestro de sesión y los actores alineados con estados
- Aplica una separación estricta de roles:
- Separa a los administradores del día a día de los roles de "romper el vidrio" o destructivos
- Evita las cuentas de administrador compartidas
2. Pon frenos a las acciones destructivas
Asume que cualquier cuenta individual puede verse comprometida. Tu trabajo es dificultar que una sola credencial comprometida destruya el entorno.
Para Intune y plataformas similares:
- Habilita la Aprobación de Múltiples Administradores (MAA) o su equivalente:
- Exige un segundo aprobador independiente para acciones de alto impacto (por ejemplo, borrar más de N dispositivos)
- Establece umbrales para que "ninguna persona por sí sola pueda eliminar la empresa".
- Monitorea y genera alertas sobre:
- Borrados masivos, cambios masivos de perfil o implementaciones de políticas a gran escala
- Creación de nuevos roles de alto privilegio o entidades de servicio
3. Arregla tu enfoque de BYOD y MDM
Según los informes, el caso de Stryker involucró el borrado de teléfonos personales porque estaban inscritos como dispositivos totalmente administrados. Eso representa un enorme riesgo de recursos humanos, privacidad y legal.
- Audita ahora mismo tus perfiles de BYOD e Intune/MDM
- ¿Dónde estás aplicando el control total del dispositivo en teléfonos de propiedad personal?
- ¿Qué aviso de consentimiento o política vieron realmente los usuarios?
- Donde sea posible, cambia a la Gestión de Aplicaciones Móviles (MAM):
- Administra solo las aplicaciones y los datos de trabajo
- Conserva la capacidad de borrar datos corporativos sin restablecer de fábrica el contenido personal
4. Crea y practica un plan de comunicación fuera de banda
No esperes a que tu inquilino principal quede fuera de línea para descubrir que no tienes forma de coordinar una respuesta.
Como mínimo:
- Crea un grupo de comunicación pequeño y confiable para tus líderes de respuesta a incidentes:
- Grupo de Signal o WhatsApp
- Lista de distribución de correo personal
- Guarda los datos de contacto personales de los respondedores clave fuera de TI corporativo (por ejemplo, impresos o en un administrador de contraseñas separado que no esté vinculado al SSO principal)
- Realiza un simulacro de 30 minutos:
- Simula que "Microsoft 365 está caído"
- Obliga al equipo a restablecer la comunicación mediante el canal fuera de banda
- Identifica las brechas y corrígelas
5. Practica la restauración de "día cero" a una escala realista
La mayoría de las organizaciones han probado restaurar una base de datos o una sola aplicación. Muy pocas han ensayado reconstruir toda una flota de dispositivos.
Toma como referencia la escala del incidente de Stryker:
- Diseña un ejercicio de "Día Cero" donde asumas que:
- Tu plataforma de administración principal no es confiable
- Varios miles de dispositivos están borrados o necesitan reinstalarse
- Trabaja en lo siguiente:
- Cómo organizarías y controlarías el ritmo de reaprovisionamiento (no es realista que 200.000 máquinas descarguen imágenes al mismo tiempo)
- Qué sitios y roles tienen prioridad
- Cómo restablecerás la confianza en las identidades, los dispositivos y las copias de seguridad
- Presta especial atención a tus consolas de administración de copias de seguridad:
- Si viven en el mismo ecosistema de identidad o MDM que los dispositivos, podrías verte obligado a recurrir a modos de recuperación lentos y fuera de línea
Reflexiones finales
El incidente de Stryker es un momento decisivo porque reúne:
- Presión geopolítica
- Compromiso de identidad y del plano de administración
- Impacto real en las cadenas de suministro de atención médica y la seguridad del paciente
No necesitas ser un gigante de tecnología médica de $10 mil millones para aprender de esto. Si operas alguna consola de administración centralizada, ya sea como empresa, MSP o proveedor, esto es un adelanto de lo que puede pasar cuando esas herramientas se usan en tu contra.
Usa esto como un impulso para:
- Reevaluar las protecciones de tu plano de administración
- Fortalecer la higiene de BYOD y MDM
- Practicar cómo te comunicarás y operarás cuando tus plataformas principales estén caídas
Cuando llegue la crisis, no será una PowerPoint ingeniosa lo que salve a tu organización. Serán los fundamentos aburridos y bien ensayados que decidas implementar hoy.
Puedes seguir las actualizaciones en vivo de Stryker aquí.