

Oye, tú. Tengo una pregunta para ti. No pienses demasiado antes de responder. ¿Listo? Aquí va.
¿De dónde vienen los ataques de identidad?
Tal vez tu reacción instintiva a esa pregunta sea responder con un país, estado, ciudad o continente. Tendrías razón, pero solo a veces. De hecho, si solo consideras la ubicación geográfica de un ataque como la ubicación relevante, Estados Unidos en realidad representa la mayoría de los puntos de origen de los ataques de identidad.
Tal vez tu reacción instintiva sea que vienen de VPN, nodos de salida de TOR y proxies. De nuevo, tendrías razón, pero solo a veces. Más adelante en este artículo, verás las cifras de cuántos ataques de identidad se originan en estas tecnologías (spoiler: es más del doble de la tasa de orígenes geográficamente relevantes).
Pero incluso si respondes “a veces vienen de ubicaciones, como un país o ciudad, y a veces de una tecnología, como una VPN”, entonces estás mayormente en lo correcto, pero aún equivocado. Esta fue exactamente la situación en la que me encontré al comienzo de los eventos que precipitaron este artículo.
El punto al que quiero llegar es que el espacio de identidad es multidimensional. Si solo consideras los dos ejes de ubicación geográfica y tecnologías como las VPN, estás jugando a las damas. El adversario moderno de identidad no juega a las damas. Tampoco juega ajedrez. Juega Go. Si no nos movemos rápido, nos rodean.
Figura 1: El juego que juega el adversario de identidad
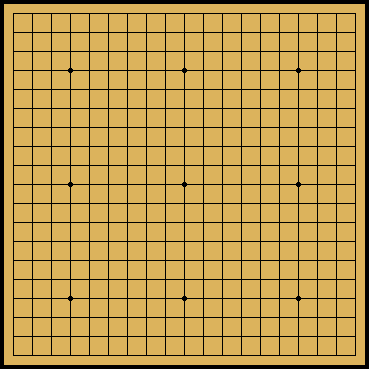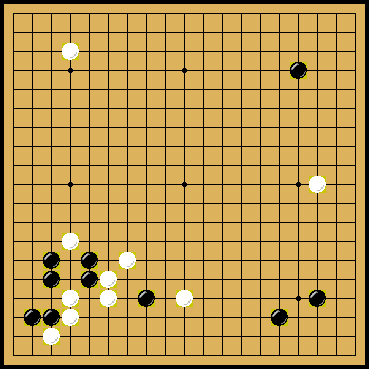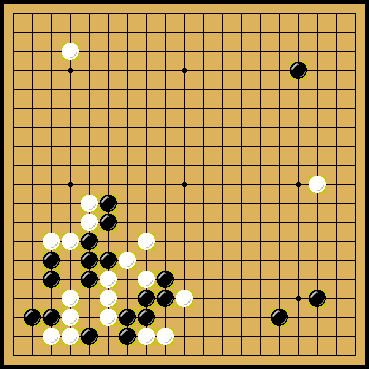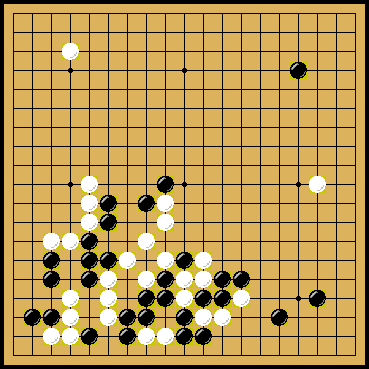
Así que, para nivelar el campo de juego, quiero transmitir algo de sabiduría ganada con esfuerzo sobre de dónde realmente vienen los ataques de identidad. Déjame contarte una de las lecciones más difíciles que hemos aprendido al intentar definir las dimensiones del campo de juego de los ataques de identidad y cómo recuperamos la ventaja. Todo comienza con una tendencia preocupante que noté y un desafío profundo a mis suposiciones previas.
Co-ocurrencia y el arte del espacio negativo de detección
Analizo rutinariamente los datos del producto Huntress Managed Identity Threat Detection and Response (ITDR) como parte de mis tareas diarias como investigador de productos. Soy responsable de la innovación y eficacia de ITDR, y es crucial seguir los datos del producto para responder a ambas responsabilidades. Fue a principios de este año, mientras ejecutaba algunos análisis de datos rutinarios, que noté algo bastante extraño. Pero todavía no puedo contarte lo extraño. (Quédate conmigo.)
Para explicar esto extraño, primero debo explicar el concepto de co-ocurrencia de señales. Co-ocurrencia de señales es el término que uso para describir cuando sistemas de detección individuales se activan para la misma identidad en partes dispares de la cadena de ataque. Examinar qué detectores se activan junto con otros detectores, especialmente cuando los dos detectores no están en la misma área de la cadena de ataque, puede ser extremadamente útil para medir la eficacia del sistema de detección.
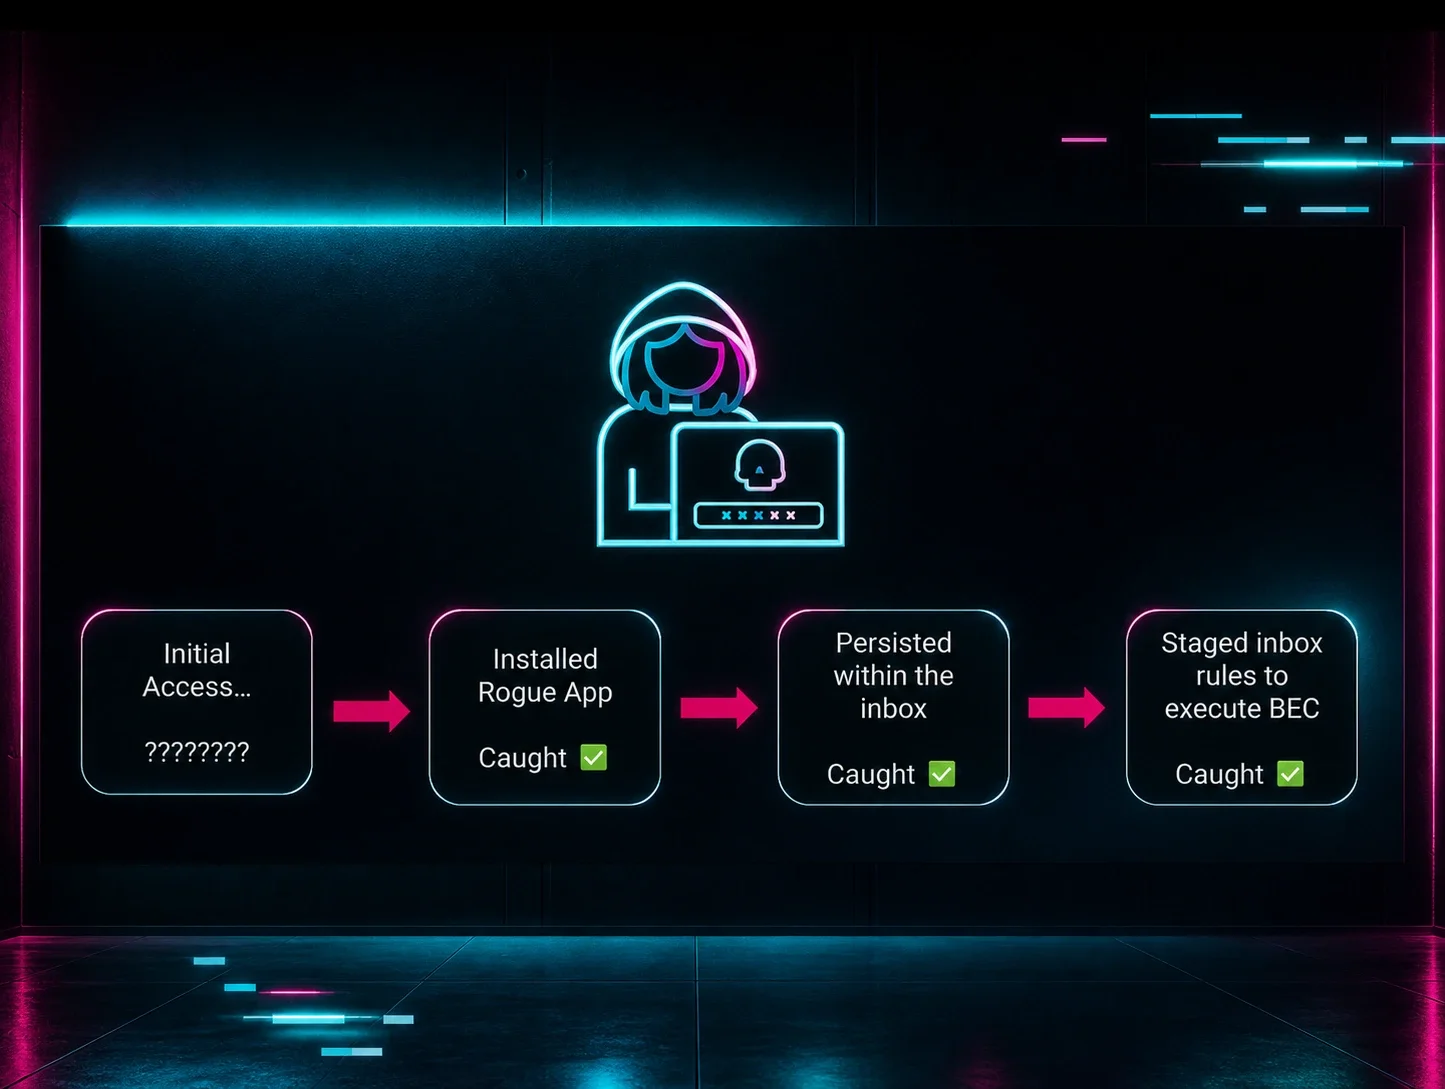
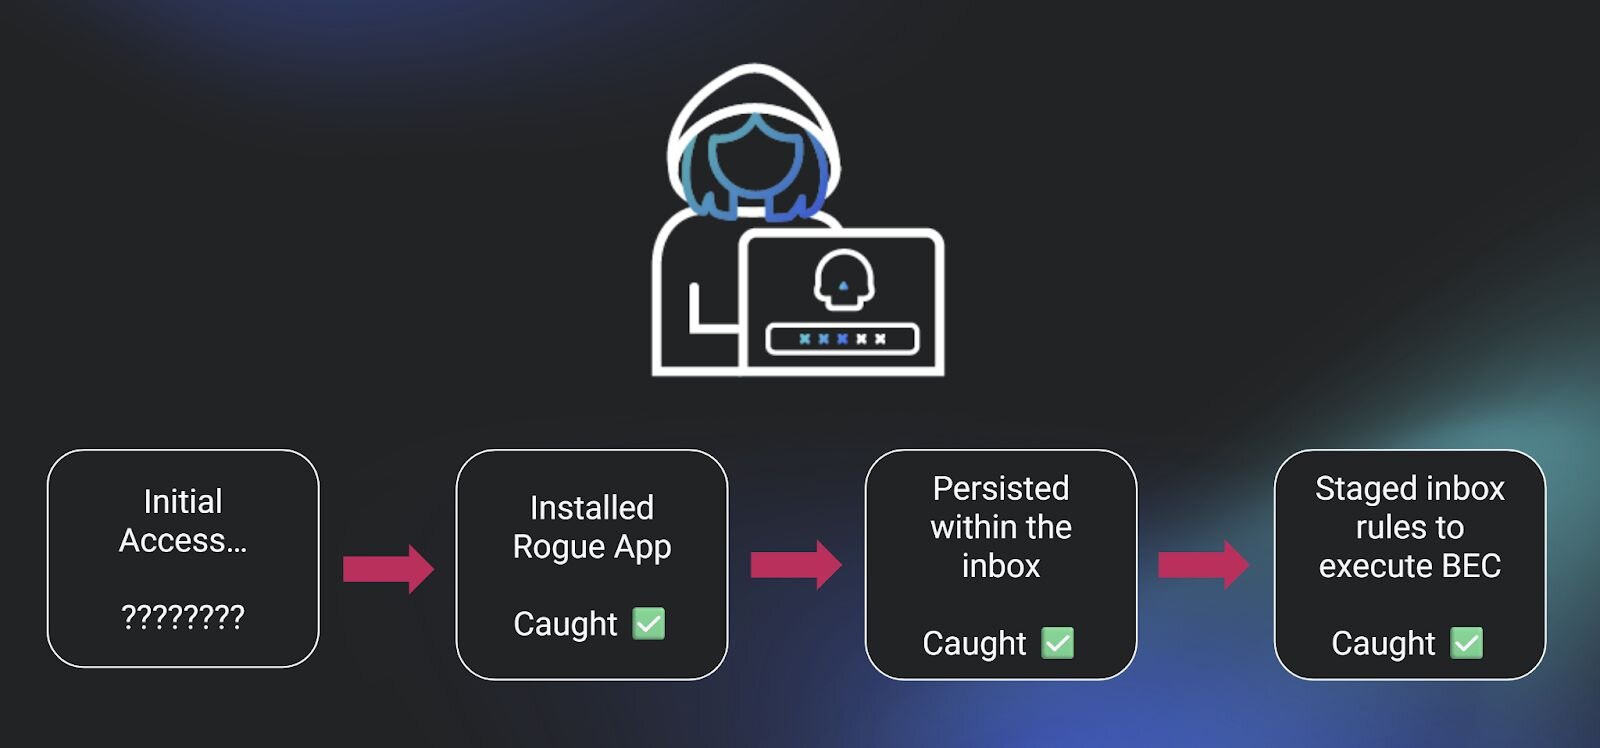
Si tres alertas se activan para la misma identidad dentro del mismo marco temporal en diferentes partes de la cadena de ataque, ¿cuál es el resultado? Podemos concluir razonablemente que nuestro sistema de detección funciona bien en capas. Una alerta por un inicio de sesión sospechoso, seguida de una alerta por la instalación de una aplicación, seguida de una alerta por una regla de bandeja de entrada sospechosa, significa que las capas que corresponden a diferentes partes de la cadena de ataque están funcionando para resaltar cada paso en un ataque de identidad. Esto es la co-ocurrencia de señales en acción.
Figura 2: Representación de tres etapas de una cadena de ataque, donde alertamos en cada etapa
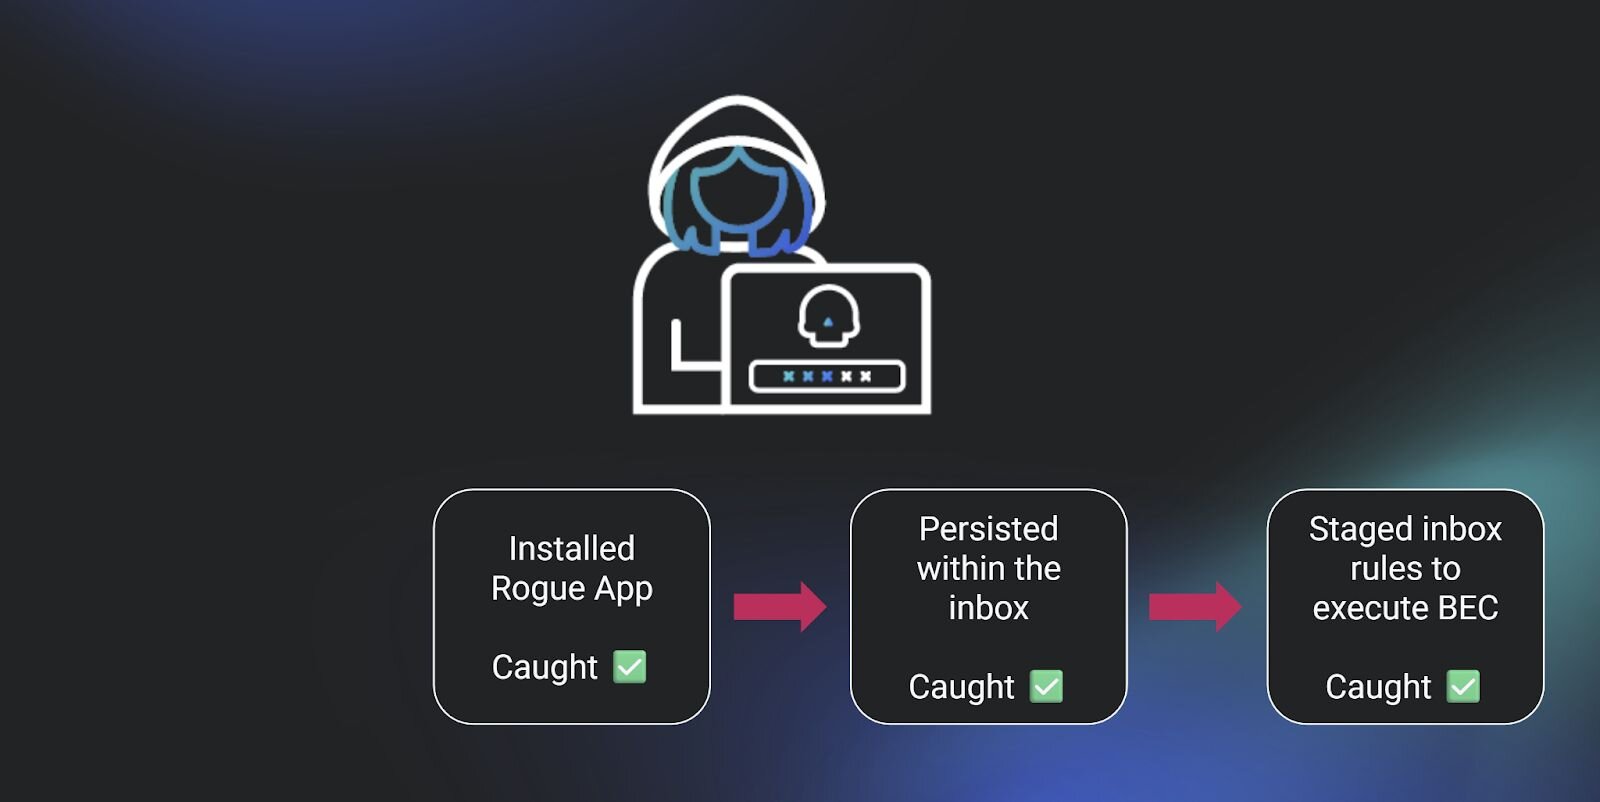
Estudiar la co-ocurrencia para determinar la eficacia del producto es un uso de este concepto. Pero el uso más interesante es determinar el espacio negativo de la detección. ¿Dónde nuestro producto se queda corto al identificar las tácticas de los actores de amenazas? ¿Qué no estamos viendo junto a las alertas confirmadas dentro del mismo ataque?
Con el contexto del espacio negativo de detección, la imagen anterior adquiere un significado totalmente diferente. Un lector perspicaz podría preguntarse: “¿No debería también haber algún tipo de acceso inicial en el ejemplo gráfico anterior?”
Tienes razón. ¿Ves ese espacio vacío grande y agradable a la izquierda de “Aplicación fraudulenta instalada” en ese gráfico? Creo que es hora de explicar lo “extraño” a lo que me refería antes.
A principios de este año, un número creciente de ataques positivos confirmados que eran co-ocurrentes entre identidades protegidas por Huntress carecían de una alerta de acceso inicial. Comenzamos a ver una cantidad alarmante de alertas verdaderas positivas, que incluían la creación de reglas de bandeja de entrada, la instalación de una aplicación fraudulenta, la ejecución de un ataque masivo de spam saliente, y otras tácticas posteriores a la explotación. Cada instancia de estas señales co-ocurrentes se atribuyó a una identidad, dentro de la misma sesión, en aproximadamente el mismo marco temporal. Y para cada una de ellas, no teníamos idea de cómo el atacante obtuvo acceso inicial.
Figura 3: Aquí retratada, mi pesadilla real
En todos estos ejemplos, igual atrapamos al actor de amenazas durante su fase posterior a la explotación. Algunos dirían que solo se necesita una buena alerta para detener un ataque en progreso, así que quizás podríamos interpretar esto como un éxito a pesar de perder el método de acceso inicial.
Yo no.
Figura 4: Yo, cuando esto estaba pasando
Sí, me alegra que atrapáramos al actor de amenazas, pero en realidad interpreto esto como un fallo de detección. Si perdiste el punto de acceso inicial en una instancia de un ataque, no puedes asumir que esa fue la única instancia en la que lo perdiste. Tu sistema de detección tiene brechas si no puedes reconstruir la cadena de ataque en cada una de sus fases. Quizás esto signifique que los atacantes están cambiando sus tácticas. Quizás signifique que tus sistemas de detección carecen de telemetría. Es difícil saberlo con exactitud hasta que te arremangas y te sumerges en los datos.
Así que a principios de este año, me puse a trabajar para responder la pregunta: ¿Qué métodos de acceso inicial estábamos pasando por alto, y por qué nuestro sistema de detección establecido para el acceso inicial nos estaba fallando?
Ubicación en el espacio de identidad
La telemetría de identidad es escasa. Generalmente tenemos que llegar lejos con poca información cuando se trata de probar malicia durante los ataques de identidad. Y quizás el mejor indicador de interés para la telemetría de identidad es el punto de origen de la actividad de identidad: nada menos que la dirección IP. Pero usar direcciones IP para probar malicia es mucho más complicado de lo que parecería inicialmente.
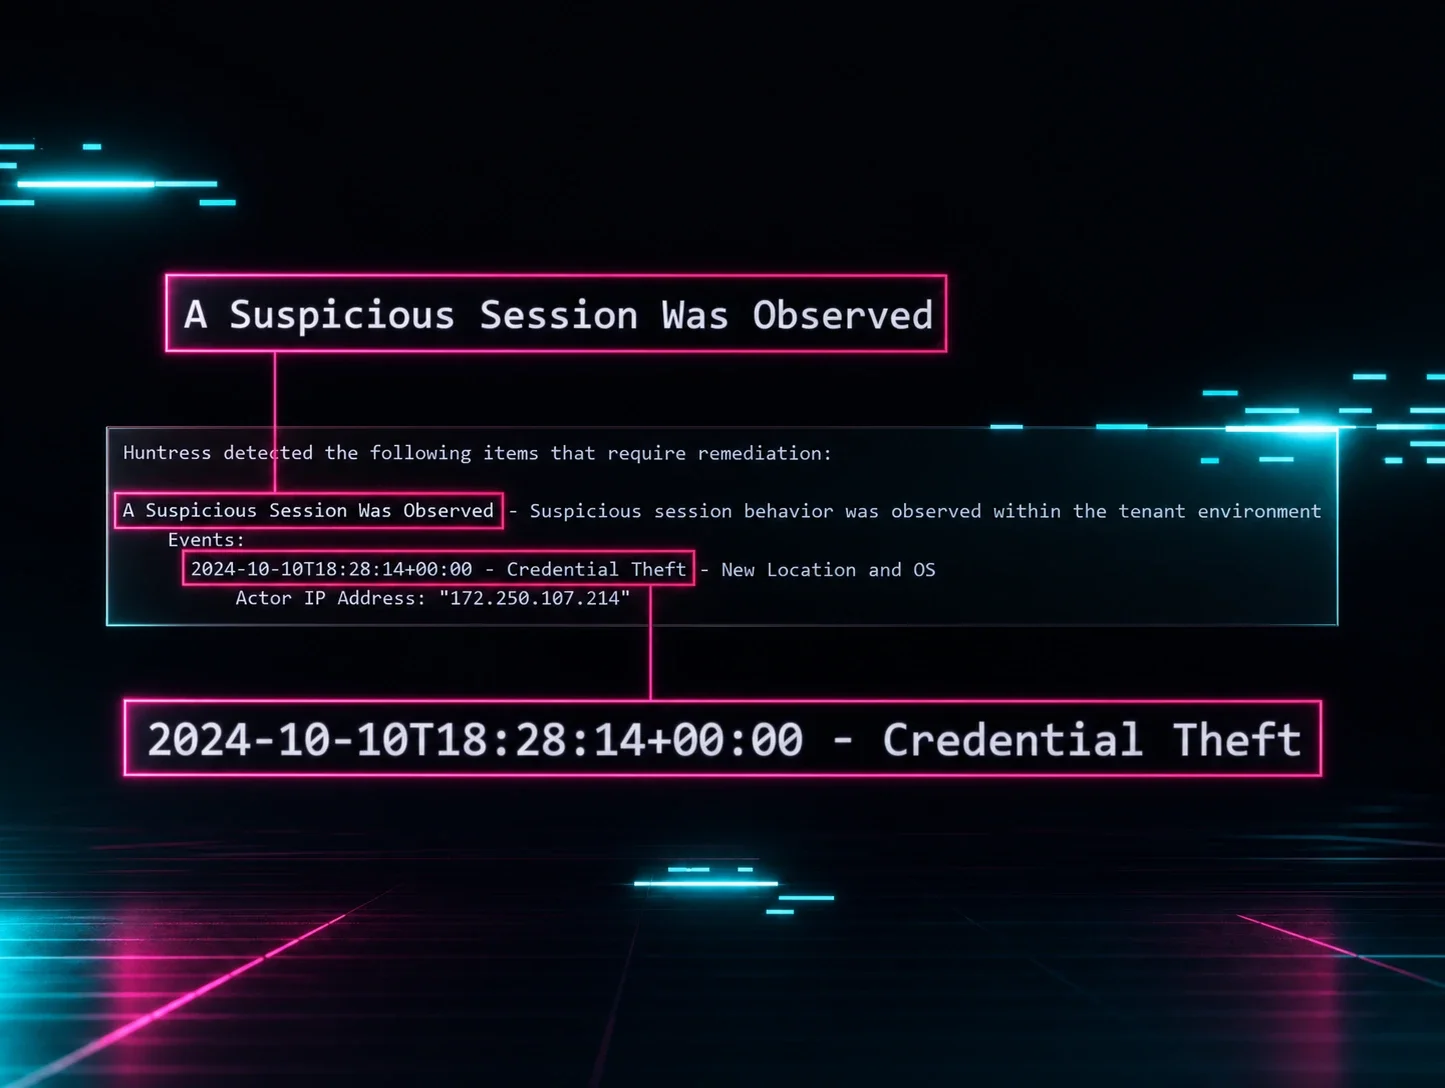
Como contexto, ITDR fue desarrollado para contrarrestar firmemente las tácticas de acceso inicial en el verano del año pasado cuando lanzamos nuestra capacidad de Acceso No Deseado. Acceso No Deseado combate directamente el robo de credenciales, el robo de tokens de sesión y otras formas de toma de control de cuentas al analizar la telemetría de inicio de sesión. Desarrollamos el producto para analizar e identificar discrepancias en ubicaciones anómalas, VPN inesperadas, reutilización de tokens y otras formas de acceso inicial.
Crucialmente, dividimos el modelo de amenazas en dos áreas distintas: ubicación y túneles. “Ubicación” aquí significa la ubicación geográfica indicada por una dirección IP. Un inicio de sesión desde una dirección IP residencial ubicada en Alemania, por ejemplo, podría ser anómalo si la identidad protegida no viaja a menudo y está ubicada en Estados Unidos. Esto aborda el desafío clásico de detección de identidad de identificar ubicaciones anómalas y detener una toma de control de cuenta cuando se origina desde una ubicación inesperada.
“Túneles” representa un espacio de detección mucho más interesante y matizado. Cuando se usan proxies o VPN, la noción de ubicación geográfica de una dirección IP esencialmente deja de tener sentido. Esto tiene sentido si lo piensas. Supongamos que observas un inicio de sesión desde una dirección IP con base en Alemania. Si se toma al pie de la letra, uno se sentiría tentado a llamarlo “un inicio de sesión desde Alemania”, pero si esa dirección IP es un nodo de salida de VPN registrado, ¿realmente podemos decir que el usuario detrás de ese inicio de sesión (malicioso o no) realmente está “iniciando sesión desde Alemania”? Por supuesto que no. Sin embargo, esa es una de las formas más comunes en que he visto que otras soluciones manejan el concepto de inicios de sesión anómalos para la identidad, y es donde veo que otras soluciones fallan más.
Así que, desde los primeros principios, construimos ITDR para manejar las dos clases de “ubicación” de manera diferente. ¿Hay una VPN o proxy asociado con la IP en cuestión? Ignora la ubicación. ¿No hay asociación con VPN o proxy? Trata la geografía implícita como relevante. El país, estado, región o continente implícito por la dirección IP para un evento de inicio de sesión con VPN es irrelevante. El hecho relevante es la VPN en sí, el proveedor de esa VPN, y si esa VPN es usada rutinariamente por la identidad o no.
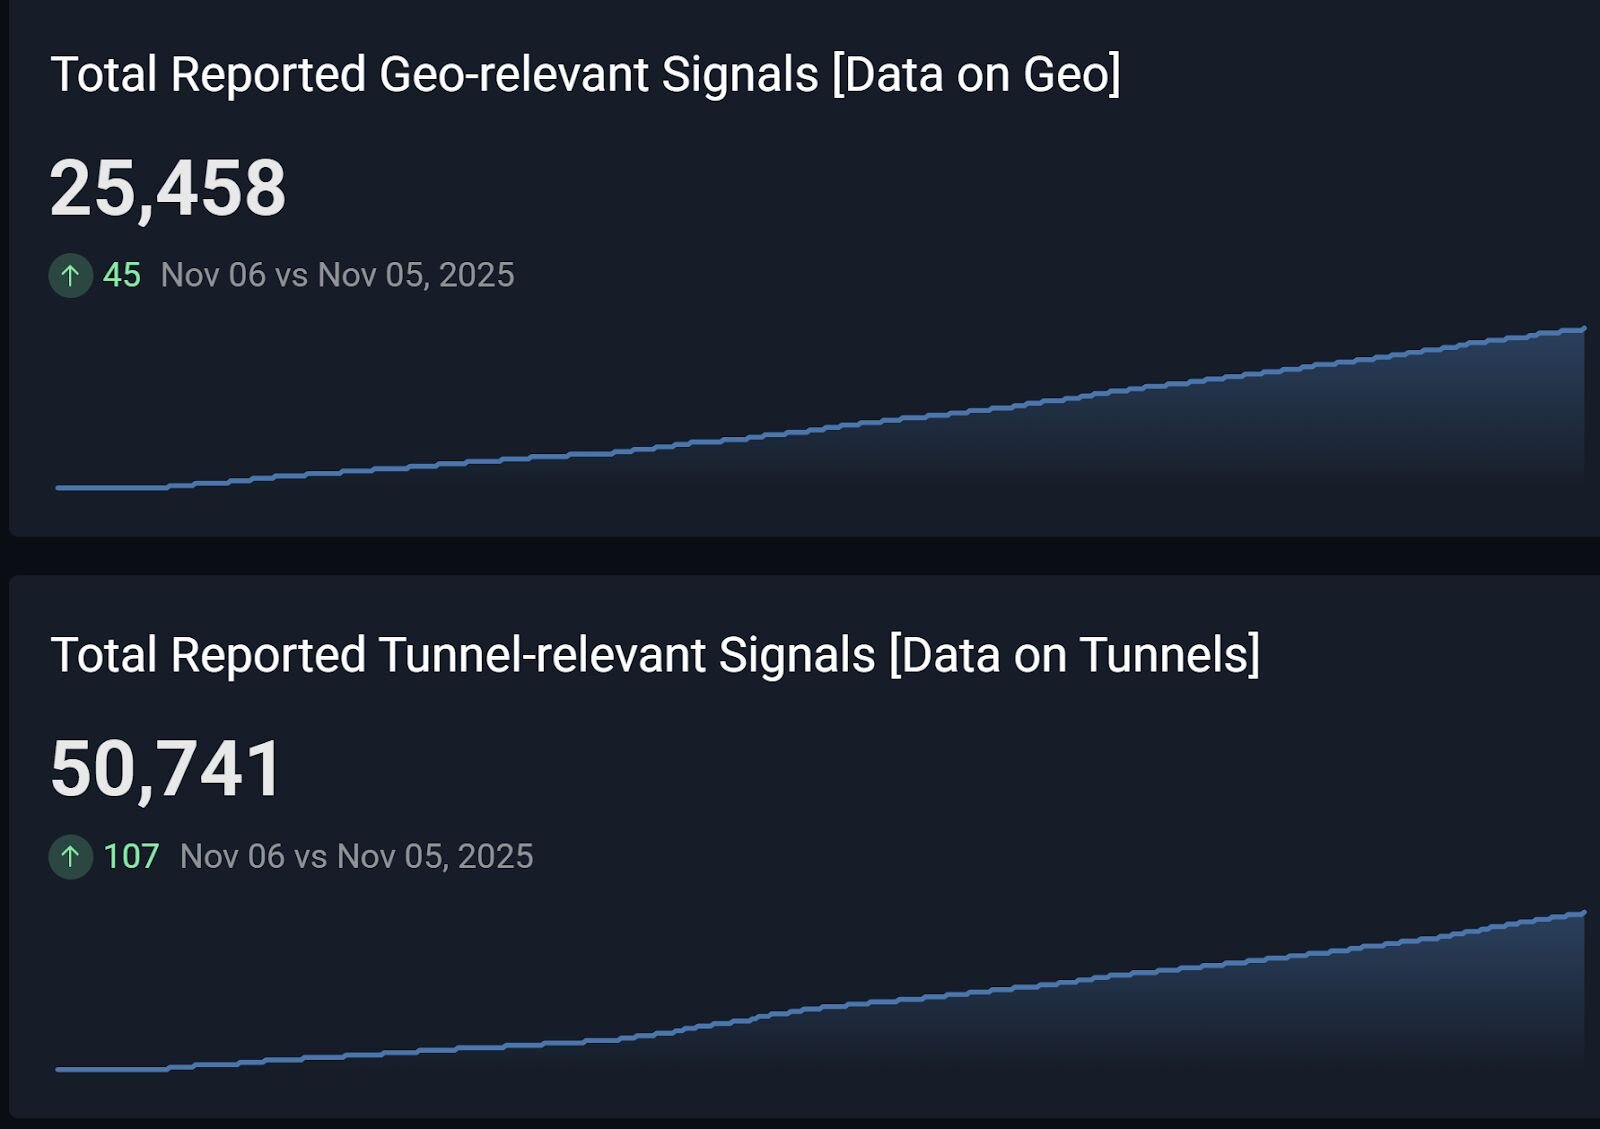
Esta estrategia dista de ser perfecta, pero ha demostrado ser extremadamente efectiva. Incluso vemos que los incidentes relacionados con túneles ocurren al doble de la tasa de direcciones IP geográficamente relevantes. Si tratas todas las “ubicaciones” de direcciones IP por su geografía implícita, pierdes por completo este matiz.
Figura 5: Observamos y reportamos incidentes relacionados con túneles a aproximadamente el doble de la tasa de incidentes geográficamente relevantes
(Nota al margen, perdón por la divagación. Esto es precisamente por qué el “viaje imposible” no es una estrategia de detección sólida. Abordar la detección midiendo la velocidad implícita entre dos puntos en la Tierra pierde el matiz de las tecnologías involucradas. Puedes “teletransportarte” de España a Surinam con solo hacer clic en un botón si usas una VPN. Gran parte de este “viaje imposible” es solo un atributo benigno de las formas intrincadas en que ocurre la autenticación en el espacio de identidad. Las sesiones se mueven mucho. Como, mucho, mucho. ¡Podría, y probablemente lo haré, escribir todo un artículo sobre este tema algún día!)
En resumen, Huntress Managed ITDR lo estaba haciendo increíble a la hora de encontrar tomas de control de cuentas tanto cuando se usaba una VPN o proxy como cuando no se usaba. Así que imagina mi sorpresa cuando no pudimos explicar un número preocupante de métodos de acceso inicial. ¿Qué estaba pasando?
Ni ubicación, ni túnel, sino una tercera cosa secreta
Eventualmente descubrimos que existe un tercer tipo de “ubicación” cuando se trata de direcciones IP y los puntos de origen para las tomas de control de cuentas. Y es un poco más sutil que las otras dos.
Nuestro proveedor de inteligencia de amenazas, Spur, etiqueta direcciones IP según sus atributos. Sus datos son nuestro mecanismo principal para determinar si una dirección IP está usando un proxy, VPN, nodo de salida de TOR, u otra tecnología. Una de esas etiquetas es la etiqueta de infraestructura. La etiqueta de infraestructura suele ser nula, pero a veces muestra un valor como “SATELLITE”, “AIRPLANE-WIFI”, o “MOBILE.” Estos valores representan el tipo de infraestructura que provee el espacio IP. Los que acabo de listar se explican por sí mismos. Pero hay una etiqueta de infraestructura adicional que me llamó la atención: “DATACENTER”. Esto, resulta que sería la clave para resolver este misterio.
Figura 6: Puedo escuchar el zumbido del progreso al mirar esta imagen (Fuente)
Sí, centros de datos. Esas ciudadelas de acero y silicio que ahora impulsan la mayor parte del mundo digital. El espacio IP provisto por centros de datos no es nada nuevo, pero la forma en que estas IP se presentan en la telemetría de identidad cuando puedes observar ocho millones de identidades en acción cada día es extremadamente interesante.
Aquí hay una observación: la mayoría de las VPN y proxies operan en espacio IP de centros de datos. Pero hay instancias de IP sin ningún nodo de salida de VPN asociado, nodo de salida de proxy, nodo de salida de TOR, o cualquier otro atributo que represente una tecnología, que están etiquetadas como IP de centro de datos. Así que tenemos una especie de situación de rectángulo/cuadrado donde la mayoría de las VPN y proxies se ejecutan sobre infraestructura de centros de datos, pero no toda la infraestructura de centros de datos aloja VPN y proxies exclusivamente. Esto tiene sentido si piensas en cómo los centros de datos de Microsoft Azure hacen mucho más que simplemente alojar nodos de salida de VPN, pero muchos proveedores de VPN probablemente alojan su tecnología en espacio cloud.
Aquí hay otra observación: al igual que cuando una VPN o proxy está en juego, la ubicación física del centro de datos es irrelevante. Hay varias razones por las que es así. Por un lado, cualquiera puede levantar infraestructura cloud, autenticarse en ese host cloud, y luego usarlo como punto de pivote mientras accede a recursos de identidad. Esto podría ser tan simple como usar un host Linux basado en cloud como pivote de proxy SOCKS, o tan complicado como Azure Virtual Desktop. ¿Importa dónde esté físicamente ubicado el centro de datos? Esencialmente, no. De manera similar al paradigma de VPN y proxy, un inicio de sesión desde un centro de datos ubicado en EE. UU. no es “un inicio de sesión desde EE. UU.”
Cuando dimos un paso atrás y reevaluamos cómo la infraestructura de centros de datos cambia la noción de “ubicación” en el espacio de identidad, quedó claro que habíamos perdido una oportunidad de detección seria: IP de centros de datos sin atributos adicionales. En otras palabras, ya estábamos detectando inicios de sesión desde espacio IP de centros de datos cuando la IP en cuestión también estaba etiquetada como VPN o proxy, pero no logramos identificar cuando la IP en cuestión no tenía ningún atributo adicional.
Entonces, esto debería ser un caso cerrado, ¿verdad? ¿Todas las autenticaciones desde espacio IP de centros de datos son anómalas y pueden reportarse, verdad? Esto debería ser una brecha fácil de cerrar, ¿verdad??? ¿¿¿Verdad??!!
Ni de cerca.
Diez millones de eventos de autenticación después
La cantidad de telemetría de identidad que se origina en infraestructura de centros de datos es asombrosa.
Estoy mirando el panel de todas las identidades protegidas por Huntress en este momento mientras escribo esto. Filtrando por los últimos 14 días de datos y solo contra eventos de autenticación exitosos, hay 10.2 millones de eventos para clasificar. Esa es un área de superficie de detección absurdamente grande para trabajar. Necesitaremos ser creativos.
Déjame ilustrar lo complicado que puede ser este espacio de detección con un ejemplo de un error importante que cometí al principio. El año pasado, formé la hipótesis de que el robo de tokens en espacio IP de centros de datos sería fácil de probar examinando eventos dentro de la misma sesión donde un evento se originaba desde espacio IP de centro de datos y otro evento ocurría desde una IP que no estaba etiquetada como centro de datos. Esta hipótesis funciona de maravilla para atrapar el robo de tokens desde VPN, proxies y ubicaciones anómalas, así que imaginé que sería igualmente efectiva. Esta hipótesis llevó a construir un detector que rutinariamente creaba más de mil alertas por día, donde casi ninguna tenía valor para el SOC. Para poner esto en perspectiva, los detectores equivalentes que identifican el robo de tokens desde ubicaciones anómalas y VPN crean una fracción de ese volumen de alertas por día y son rutinariamente todos verdaderos positivos.
Mi hipótesis resultó ser inútil para sacar a la luz el mal, pero invaluable para demostrar que los eventos benignos rebotan mucho en el espacio IP de centros de datos.
Así que, de vuelta al tablero de diseño.
Si analizar sesiones que usan espacio IP de centros de datos es inútil para la detección y la ubicación geográfica de una IP de centro de datos no es relevante, ¿hay otra forma de subdividir este espacio del problema? Sí, la hay.
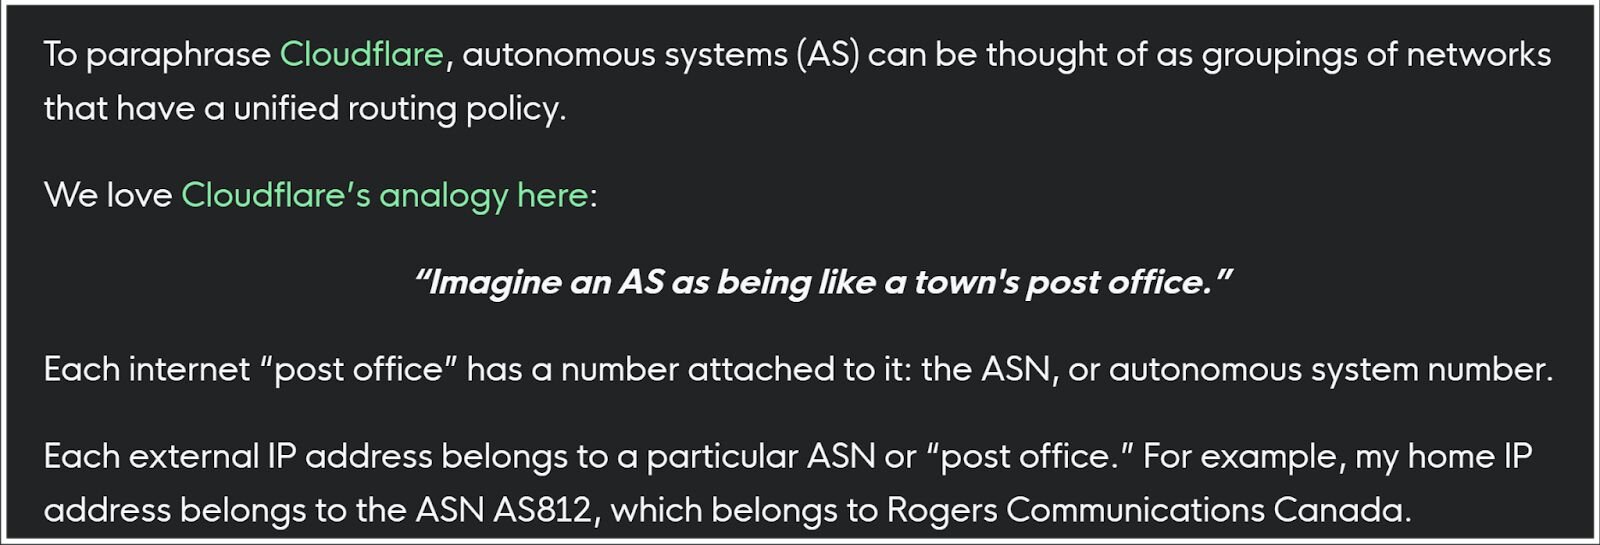
Resulta que no puedes simplemente construir un centro de datos y comenzar a repartir espacio IP arrendado. Todas las direcciones IP deben registrarse y organizarse bajo un Sistema Autónomo (AS). Mis colegas han escrito sobre usar AS como un dato principal de threat hunting, y no se me ocurre una forma mejor de describir el concepto de lo que lo hicieron en ese artículo, ¡así que simplemente lo publicaré aquí!
¿Cómo se ven los 10 millones de eventos de autenticación cuando se agrupan por AS? Hay una distribución de ley de potencia en juego donde más de la mitad de esos eventos se originan desde centros de datos de Microsoft. Las 10 principales organizaciones de AS restantes no son sorprendentes e incluyen a CloudFlare, Google, ZScaler, Amazon y algunos otros pesos pesados.
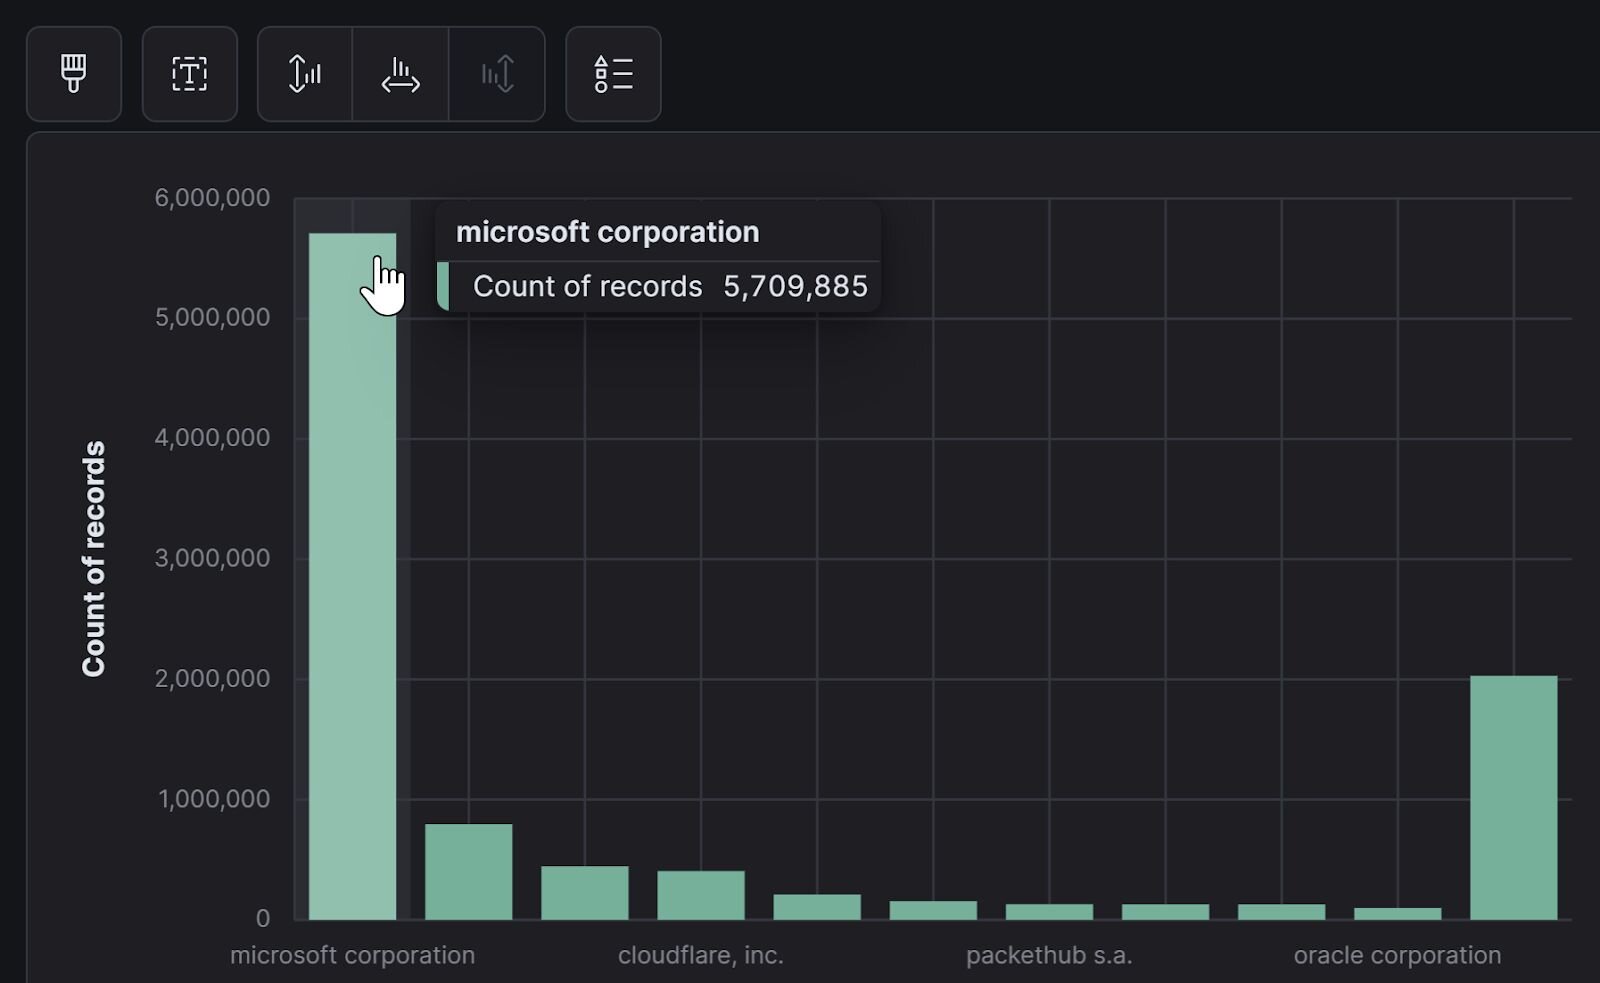
Sin embargo, lo que falta en este gráfico son los nombres de la cantidad descomunal de otros Sistemas Autónomos que existen en el mundo. Microsoft tiene la mayor parte de la actividad, pero hay cientos y cientos de otras organizaciones en esta telemetría.
Podemos subdividir el problema examinando los eventos de una identidad a través de la lente de su organización AS. Esta es la piedra angular de nuestra estrategia: el AS se convierte en el “país” para un inicio de sesión desde una IP de centro de datos si esa IP no tiene ningún otro atributo como una VPN o proxy.
Pero esa no es la única forma de abordar el problema de detección. Adicionalmente…
AS súper sospechosos
No todos los AS se construyen de la misma manera. Microsoft tiene diferentes opciones de pago, requisitos de cumplimiento y prácticas comerciales que algo como “1337 Services GmbH.” Muchos de estos AS arriendan espacio IP y realizan negocios de una manera que describiría profesionalmente como “sospechoso af bro.”
Un excelente ejemplo de mi investigación es Latitude.sh, un proveedor de bare-metal con sede en Brasil. Latitude arrienda activos cloud y acepta criptomonedas anónimas como pago. Esto, por supuesto, es atractivo para los cibercriminales.
Podemos concluir con seguridad que algunos AS tienen un potencial más alto de abuso y fraude que otros AS según su país de origen, las leyes de ese país, la aceptación de criptomonedas y otros factores similares. No es justo decir que toda autenticación desde un proveedor como Latitude.sh es maliciosa todo el tiempo, pero es defendible describirla como al menos digna de investigación.
Con esta información en mano, redacté planes para implementar un sistema de detección que clasifica los inicios de sesión de identidad desde infraestructura de centros de datos, compara los eventos con una línea base de actividad previa de centros de datos, y marca la autenticación desde IP de centros de datos que pertenecen a un AS con un potencial de abuso más alto. El equipo de ingeniería de ITDR de Huntress y yo trabajamos durante el verano para dar vida a este sistema. Salió en vivo en agosto de 2025, y aquí están los resultados.
Los resultados
Al subdividir el espacio del problema, convertimos más de 10 millones de eventos en un pajar manejable de unos pocos cientos de eventos por día para analizar. Hasta la fecha, hemos reportado más de 3,400 instancias de eventos de autenticación de centros de datos que cumplieron los criterios para investigación. De los 3.4k reportes, alrededor del 3.2% fueron rechazados. Este es un desempeño sólido comparado con la línea base de eficacia de detección de identidad, que usualmente ronda una tasa de rechazo del 4-5%.
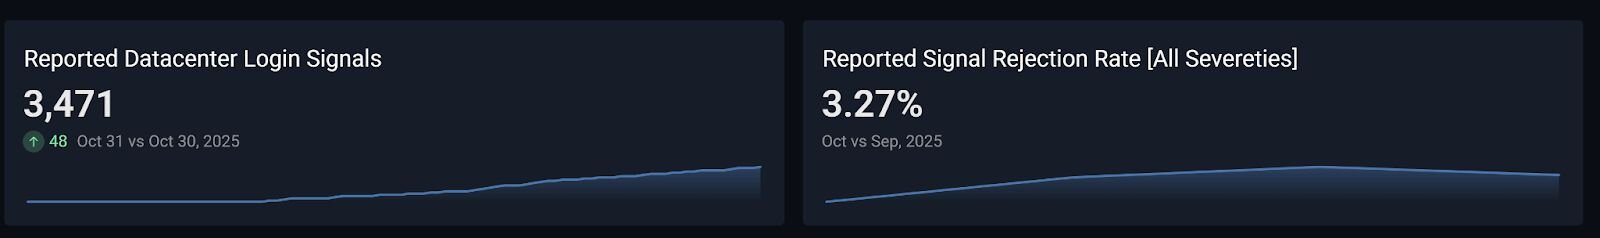
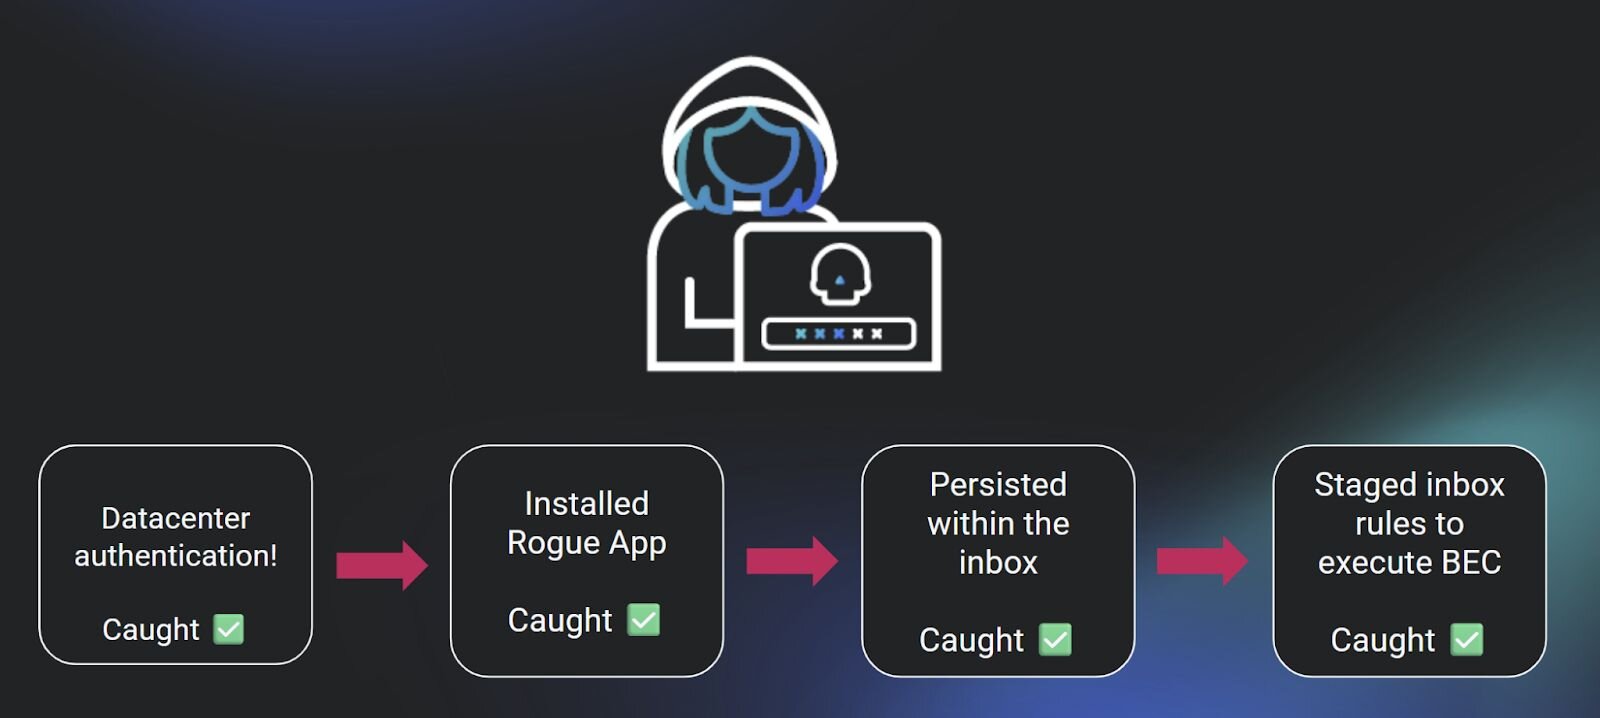
Lo más importante es que esto ha reducido severamente el número de ejemplos donde el producto ITDR pasaba por alto por completo el método de acceso inicial pero luego atrapaba tácticas posteriores a la explotación.
Figura 9: Puedo dormir tranquilo de nuevo. Por ahora.
Conclusión
Entonces... ¿de dónde vienen los ataques de identidad?
Si solo interpretas la “ubicación” como geográfica, pierdes una gran parte del panorama general. Incluso si interpretas la ubicación para incluir la tecnología que un adversario podría usar, como una VPN, sigues perdiendo matices. Hoy, estamos viendo que los hackers se alejan de las VPN en favor de los VPS, donde pueden alquilar espacio IP de centro de datos que se mezcla entre el diluvio de actividad de identidad benigna de centros de datos.
Necesitamos alterar nuestra estrategia en el espacio defensivo cuando se trata del punto de origen de los ataques de identidad. “Ubicación” en el espacio de identidad incluye la geografía implícita por una dirección IP, la huella tecnológica de esa dirección IP, y la infraestructura subyacente que facilita la dirección IP. La forma en que manejamos cada uno de esos tipos de “ubicación” marca toda la diferencia a la hora de cerrar las brechas de visibilidad.