

Una estrategia de administración de parches es un enfoque estructurado para identificar, probar e implementar actualizaciones de software en todo tu entorno. Tener una estrategia dedicada importa porque los parches aplicados sin método dejan brechas, y esas brechas son justo lo que buscan los atacantes. |
|---|
La mayoría de los incidentes de seguridad no empiezan con un ataque sofisticado.
Empiezan con una vulnerabilidad conocida que nunca se parchó. De hecho, aplicar parches es una de las formas más directas de frenar un ataque antes de que empiece. Un exploit armado dirigido a una vulnerabilidad que tu equipo ya parchó no tiene adónde ir.
Una estrategia de administración de parches es un enfoque estructurado para identificar, probar, implementar y verificar actualizaciones de software en todo tu entorno. Tener una estrategia dedicada importa porque los parches aplicados sin método dejan brechas, y esos sistemas expuestos son justo lo que buscan los atacantes.
Aprende a crear una estrategia de administración de parches que resista la presión operativa real, no solo en el papel. Encontrarás un marco paso a paso, buenas prácticas y errores comunes que debes evitar antes de que te cuesten caro.
¿Qué es la administración de parches?
La administración de parches es una disciplina de seguridad proactiva. Es el proceso de identificar, evaluar y aplicar actualizaciones a software, sistemas operativos y firmware en todo tu entorno. Pero va mucho más allá de hacer clic en "instalar" ante una notificación y seguir adelante.
Piénsalo así: que salga un parche es solo el disparo de salida. Antes de que algo toque producción, tu equipo necesita saber qué sistemas se ven afectados, qué tan urgente es realmente la solución y si la actualización podría romper algo más en el proceso. Todo ese flujo de trabajo, desde el descubrimiento hasta la implementación verificada, es lo que realmente abarca la administración de parches.
Los equipos de TI suelen gestionar tres categorías de actualizaciones:
Parches del sistema operativo (Windows, Linux, macOS): actualizaciones centrales del sistema que suelen tener los mayores riesgos de seguridad
Parches de aplicaciones de terceros: navegadores, herramientas de productividad, plugins y otro software que los actores de amenazas explotan con frecuencia porque es fácil pasarlos por alto
Actualizaciones de firmware y controladores: actualizaciones de nivel inferior para hardware como switches de red, servidores y endpoints que pueden generar riesgo si no se atienden
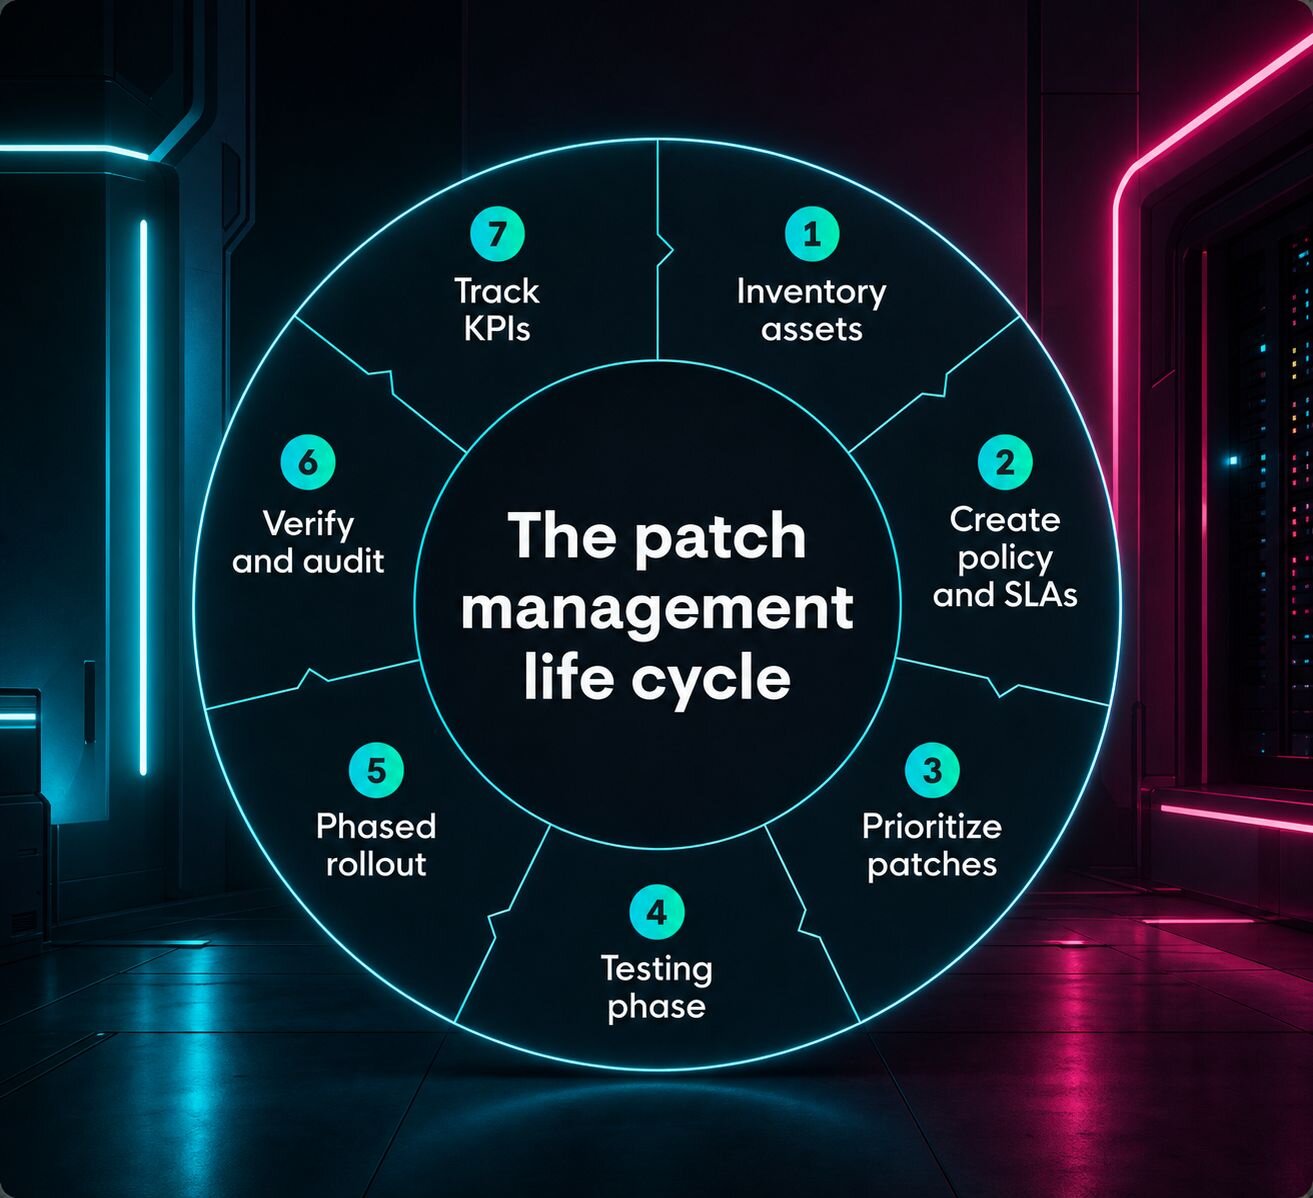
El ciclo de vida abarca desde el descubrimiento inicial hasta la verificación final de que una vulnerabilidad realmente desapareció. Cada etapa conlleva sus propios riesgos y requiere su propio criterio.
Parches de seguridad vs. corrección de errores vs. actualizaciones de funciones
No todas las actualizaciones son iguales, y tratarlas de la misma manera es una receta para el agotamiento por parches o, peor aún, para un sistema de producción roto. Así es como se comparan:
Parches de seguridad | Corrección de errores | Actualizaciones de funciones | |
|---|---|---|---|
Propósito | Cerrar vulnerabilidades conocidas | Corregir un comportamiento no deseado | Agregar nuevas funciones |
Desencadenante | Divulgación de vulnerabilidad o explotación activa | Defecto de software o informe de fallas | Hoja de ruta del producto o solicitud del usuario |
Urgencia | Alta a crítica | Baja a media | Baja |
Requisitos de prueba | Acelerados, pero aun así necesarios | Estándar | Exhaustivos |
Riesgo | Alto si se retrasa | Moderado | Bajo a moderado |
Impacto en el usuario | Generalmente mínimo | Mínimo a moderado | Puede cambiar los flujos de trabajo |
Quién es responsable | El equipo de seguridad dirige, TI implementa | El equipo de TI o de desarrollo | Gestión de cambios o TI |
La tensión principal aquí es velocidad frente a estabilidad. Los parches de seguridad suelen necesitar plazos agresivos porque los atacantes actúan rápido en cuanto una vulnerabilidad se hace pública. Una vulnerabilidad de zero-day puede pasar de divulgada a explotada activamente en cuestión de horas, dejando poco margen para un proceso de aprobación lento.
Las actualizaciones de funciones, en cambio, suelen permitir una espera más larga. Implementarlas demasiado rápido sin pruebas es la forma más segura de terminar con un flujo de trabajo roto, más difícil de arreglar de lo que valía el parche.
7 pasos para construir una estrategia de gestión de parches desde cero
Una estrategia sólida de gestión de parches es un sistema repetible que tu equipo puede ejecutar bajo presión. El orden de los siguientes pasos importa: saltarse pasos fundamentales, como el inventario o la política, suele causar fallas en la implementación más adelante, no solo dolores de cabeza.
Paso 1: Establece un inventario completo de un activo de ciberseguridad
No puedes aplicar parches a lo que no puedes ver.
Shadow IT, los endpoints remotos y los activos en la cloud que nunca llegaron a tu base de datos de gestión de configuración (CMDB) son exactamente donde se esconden las vulnerabilidades. Antes de poder crear cualquier flujo de trabajo de parchado, necesitas una imagen clara de todo lo que hay en tu red.
La mayoría de los equipos manejan el descubrimiento de dos maneras:
Escaneo basado en agentes: El software instalado directamente en cada endpoint te da visibilidad continua y detallada, incluso para dispositivos que están fuera de la red corporativa
Escaneo sin agentes: Usa sondeos a nivel de red para detectar dispositivos sin necesidad de instalar software, lo cual es útil para activos que no controlas por completo
Ningún enfoque es perfecto por sí solo, y la mayoría de los programas maduros usan ambos. El punto más importante es que el inventario no es un proyecto de una sola vez. A medida que tu entorno cambia, tu lista de activos tiene que mantenerse al día.
Paso 2: Define una política con responsabilidades claras y SLA
Sin una política escrita, el parchado se convierte en terreno de "quien llegue primero". Eso es un problema.
Una política de parchado sólida detalla:
Ventanas de mantenimiento: Cuándo se pueden implementar los parches y qué sistemas pueden tolerar tiempo de inactividad
Flujos de aprobación: Quién da el visto bueno antes de que algo llegue a producción
Plazos de remediación: Qué tan rápido deben aplicarse los parches según la gravedad (más sobre esto en el Paso 3)
Procedimientos de reversión: Qué pasa cuando un parche rompe algo
La responsabilidad nombrada importa aquí. "El equipo de TI se encarga del parchado" no es suficiente. Roles específicos deben encargarse de fases específicas: descubrimiento, pruebas, implementación y verificación. Cuando algo sale mal, no quieres estar averiguando quién es responsable en medio de un incidente.
Las ventanas de parchado también deben alinearse con las operaciones del negocio. Implementar actualizaciones durante las horas pico es una forma rápida de generar fricción con el resto de la organización.
Paso 3: Prioriza las actualizaciones según el riesgo, no la fecha de lanzamiento
No todos los parches necesitan salir esta semana. Intentar parchar todo a la máxima velocidad es uno de los mayores causantes de la fatiga de parchado, y es insostenible para cualquier equipo que no esté totalmente dedicado a este trabajo.
La priorización basada en riesgo significa observar algunos factores clave antes de decidir dónde enfocarse:
Puntaje CVSS: Una calificación de gravedad estandarizada, pero que no cuenta toda la historia por sí sola
Puntaje EPSS: Estima la probabilidad de que una vulnerabilidad sea realmente explotada en el mundo real
Criticidad de un activo de ciberseguridad: Una vulnerabilidad en tu controlador de dominio afecta de manera distinta que una en una máquina de prueba
Exposición: Los sistemas expuestos a internet generalmente se parchan primero
El catálogo de vulnerabilidades explotadas conocidas (KEV) de CISA vale la pena guardarlo. Es una lista continua de vulnerabilidades que están siendo explotadas activamente, lo que ayuda a filtrar gran parte del ruido en torno a las calificaciones de gravedad de los proveedores.
Hablando de eso, no tomes las etiquetas de "crítico" de los proveedores al pie de la letra. El contexto local determina el riesgo real. Un parche crítico para un software que no usas no es urgente. Un parche de gravedad media para un sistema expuesto a internet podría serlo.
Paso 4: Implementa una fase de pruebas rigurosa
Las pruebas son la válvula de seguridad de todo el proceso. Son lo que evita que un parche cause una interrupción mayor que la vulnerabilidad que se suponía debía corregir.
El objetivo es un entorno de prueba que realmente refleje tu configuración de producción.
Si tu entorno de prueba usa versiones distintas del sistema operativo, configuraciones de aplicaciones o perfiles de hardware diferentes, no estás probando tu entorno real.
Para equipos con recursos limitados, algunas opciones prácticas incluyen:
Grupos canario: Implementa primero en un pequeño subconjunto de endpoints y monitorea posibles problemas antes de implementar a gran escala
Implementaciones por fases: Empieza con sistemas no críticos antes de tocar algo esencial para el negocio
Implementación por anillos: Segmenta tu entorno en anillos y mueve los parches a través de ellos de manera secuencial
Los plazos de prueba varían según la gravedad. Un parche crítico con explotación activa puede reducir considerablemente tu ventana de prueba. Una actualización de rutina del sistema operativo puede seguir un ciclo estándar.
Paso 5: Ejecuta la implementación con una estrategia por fases
La mayoría de los parches siguen un ritmo predecible, como el Patch Tuesday para entornos Windows. Pero ese ritmo habitual es para parches estándar. Los parches de emergencia fuera de banda son un modo completamente distinto.
Para una implementación de rutina, un enfoque por fases se ve más o menos así:
Grupo piloto: Un pequeño conjunto de endpoints voluntarios o designados, idealmente representativos de tu entorno general
Sistemas no críticos: Estaciones de trabajo, herramientas internas e infraestructura de menor riesgo
Servidores de producción y sistemas críticos: Los últimos en la fila, después de confirmar que el parche es estable
Las fuerzas laborales remotas añaden complejidad aquí. Los dispositivos que rara vez están en la red corporativa necesitan un mecanismo de aplicación de parches que no dependa de una conexión VPN ni de un viaje a la oficina. Las herramientas basadas en agentes y las soluciones de endpoint gestionadas en la cloud manejan esto mejor que los enfoques tradicionales.
Paso 6: Verifica y audita el éxito de los parches
Un estado "correcto" en tu herramienta de implementación no significa que la vulnerabilidad haya desaparecido. Los parches fallan en silencio. Algunos requieren un reinicio que nunca ocurrió. Otros se aplican, pero no logran remediar el CVE debido a problemas de configuración.
El escaneo posterior a la implementación es la forma de confirmar que el parche realmente cumplió su función. Ejecuta un escaneo de seguimiento después de cada ciclo de implementación y compara los resultados con lo que informó tu herramienta.
También presta atención a la desviación de configuración de parches, que ocurre cuando un sistema se parcha, y luego se restaura desde una copia de seguridad o se reimagina, volviendo a su estado vulnerable original. Sin un escaneo continuo, esos sistemas pueden permanecer expuestos indefinidamente sin que nadie lo note.
Paso 7: Monitorea los KPI y mide la salud del programa
Lo que mides define cómo mejoras. Algunas métricas que vale la pena monitorear de forma constante:
el tiempo medio de respuesta (MTTR): Cuánto tiempo pasa desde que se revela una vulnerabilidad hasta que se confirma su remediación
Cobertura de parches: El porcentaje de sistemas dentro del alcance que tienen los parches actuales aplicados
Cantidad de excepciones: Cuántos sistemas o parches tienen excepciones abiertas, y cuánto tiempo llevan pendientes
Vulnerabilidades obsoletas: Problemas conocidos que no se han remediado dentro de tu ventana de SLA
Al informar a los directivos, vincula estos números con la reducción de riesgo en lugar de la actividad operativa. "Parcheamos el 94% de las vulnerabilidades críticas en 72 horas" causa mejor impresión que "ejecutamos 12 ciclos de parches el trimestre pasado".
A los interesados no técnicos les importa la exposición, no el proceso.
Buenas prácticas de gestión de parches para una estrategia de seguridad más sólida
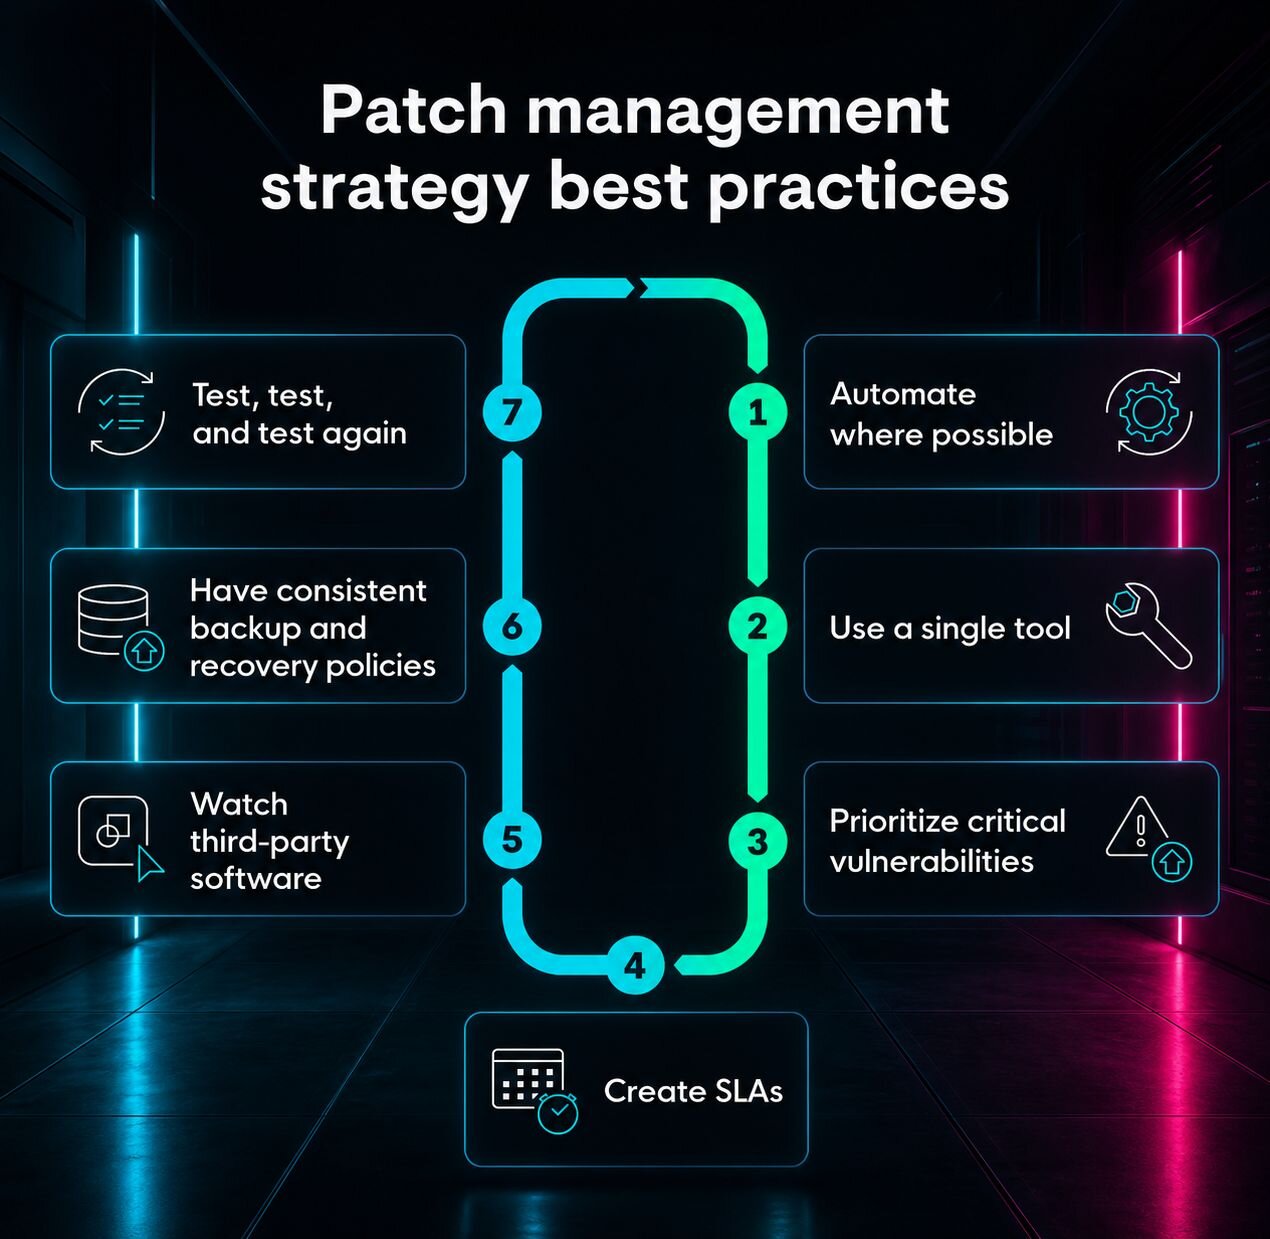
Una estrategia sólida de gestión de parches solo funciona si los hábitos diarios que la sostienen son firmes. Estas no son tareas de configuración única; son la disciplina operativa que evita que tu programa se desmorone en silencio entre ciclos.
Automatiza donde sea posible: El parcheo manual no escala. La automatización se encarga de la implementación, programación e informes rutinarios para que tu equipo pueda enfocarse en excepciones y casos límite que realmente necesitan criterio humano.
Usa una sola herramienta: Las herramientas fragmentadas crean puntos ciegos. Una plataforma centralizada de gestión de parches te da una vista consistente de tu entorno y reduce la posibilidad de que algo se escape porque dos herramientas te dijeron cosas distintas.
Prioriza las vulnerabilidades críticas: No todo puede ser urgente, y tratarlo así lleva al agotamiento. Clasifica según la explotabilidad y la exposición de un activo de ciberseguridad para que tu equipo invierta tiempo donde está el riesgo real.
Crea SLAs: Sin plazos de remediación definidos, el parcheo se vuelve reactivo e inconsistente. Los SLAs generan responsabilidad y te dan una base clara para medir si tu programa está funcionando.
Vigila el software de terceros: Los sistemas operativos reciben mucha atención, pero los navegadores, plugins y herramientas de productividad se explotan igual de seguido y son más fáciles de pasar por alto. Asegúrate de que las apps de terceros estén dentro del alcance de tu programa de parcheo, no como algo secundario.
Ten políticas consistentes de respaldo y recuperación: Si un parche rompe algo, necesitas una vía clara para revertirlo. Los respaldos consistentes hacen que una implementación fallida no se convierta en una interrupción prolongada.
Prueba, prueba y vuelve a probar: El tiempo que dedicas a validar un parche en un entorno de pruebas casi siempre es menor que el tiempo que pasarías recuperándote de una implementación fallida en producción. No te saltes este paso cuando los plazos se ajustan.
Errores comunes en la gestión de parches y cómo evitarlos
La mayoría de los problemas de parcheo vienen de errores recurrentes. Algunos a tener en cuenta:
Intentar parchear todo a la vez: Tratar cada actualización como urgente lleva al agotamiento y a los atajos. La priorización basada en riesgo existe por una razón: úsala.
Entornos de prueba que no reflejan producción: Si tu configuración de pruebas usa versiones o configuraciones de sistema operativo distintas, no estás probando tu entorno real. Las implementaciones por fases ayudan a cerrar esa brecha.
Asumir que implementación equivale a remediación: Implementar un parche con éxito no significa que la vulnerabilidad haya desaparecido. El escaneo posterior a la implementación es lo que lo confirma.
Dejar las excepciones sin resolver: Cada excepción aprobada que se olvida es una vulnerabilidad abierta con el reloj corriendo. Haz seguimiento, establece fechas de vencimiento y revísalas con regularidad.
Cómo encaja la gestión de parches en los marcos de cumplimiento
El parcheo oportuno es un requisito básico en casi todos los principales marcos de cumplimiento. La buena noticia es que un programa de gestión de parches bien ejecutado genera la mayor parte de la documentación que necesitas para una auditoría sin esfuerzo adicional.
Algunos marcos clave que debes tener en cuenta:
NIST SP 800-40: La guía federal de referencia sobre la gestión de parches. Cubre todo el ciclo de vida, desde la planificación hasta la verificación, y hace énfasis en la priorización basada en riesgo en lugar de tratar todos los parches por igual.
PCI DSS: El Requisito 6 señala específicamente la necesidad de proteger los sistemas contra vulnerabilidades conocidas instalando los parches de seguridad aplicables de manera oportuna, normalmente dentro de plazos definidos para los problemas de alto riesgo.
HIPAA: Aunque la Security Rule no menciona explícitamente la gestión de parches, exige que las entidades cubiertas agreguen procedimientos para protegerse contra software malicioso, lo cual los reguladores interpretan de forma consistente como que incluye el parcheo.
El enfoque aquí importa. Los informes listos para auditoría deberían ser un subproducto de un buen programa de parcheo, no un proyecto aparte que armas a las apuradas una vez al año. Si tu programa tiene SLAs claros, aprobaciones documentadas y registros de remediación verificados, ya tienes la mayor parte del camino recorrido.
Fortalece tu gestión de parches para soluciones a largo plazo
Las vulnerabilidades siguen apareciendo y no van a dejar de hacerlo (o lo que sea que haya dicho Smash Mouth), los entornos siguen cambiando, y los atacantes que buscan brechas en tu estrategia de gestión de parches no están bajando el ritmo. Los equipos que se mantienen a la delantera son los que parchean de forma más inteligente, con un proceso repetible diseñado para una mejor seguridad de endpoints a largo plazo.
Si buscas cerrar las brechas que un flujo de trabajo de parcheo estándar pasa por alto, Huntress Managed ESPM va más allá de la implementación básica de parches para darte visibilidad continua sobre la exposición de tus endpoints y la postura de seguridad, para que puedas hacer cambios proactivos en lugar de reactivos.
Preguntas frecuentes
¿Cuáles son los pasos clave en la gestión de parches?
Los pasos principales son: inventariar tus activos, definir una política de parcheo con responsabilidades claras, priorizar las actualizaciones por riesgo, probar los parches antes de una implementación amplia, implementarlos por fases, verificar la remediación y hacer seguimiento de los KPI. Saltarse pasos iniciales como el inventario o la política tiende a generar problemas más adelante.
¿Qué es un ejemplo de gestión de parches?
El Patch Tuesday de Microsoft es un ejemplo común. Cada segundo martes del mes, Microsoft lanza actualizaciones de seguridad para Windows y software relacionado. Los equipos de TI evalúan qué parches aplican a su entorno, los prueban y los implementan según la gravedad y la criticidad de un activo de ciberseguridad.
¿Cuáles son los KPI para la gestión de parches?
Los más útiles son el tiempo medio de respuesta (MTTR), el porcentaje de cobertura de parches, la cantidad de excepciones abiertas y la cantidad de vulneridades sin resolver. Vincular estos indicadores a la reducción de riesgo en lugar de al volumen de actividad los hace más útiles al reportar a los líderes.
¿Cuál es la diferencia entre la gestión de parches y la gestión de vulnerabilidades?
La gestión de vulnerabilidades es el proceso más amplio de identificar, evaluar y priorizar las debilidades de seguridad en todo tu entorno. La gestión de parches es una forma de remediar esas debilidades, específicamente aplicando las actualizaciones publicadas por los proveedores. No todas las vulnerabilidades tienen un parche disponible, y ahí es donde entran los controles compensatorios.
¿Qué tan rápido deben implementarse los parches críticos?
La mayoría de los marcos recomiendan implementar los parches críticos entre 24 y 72 horas después de su lanzamiento, especialmente si hay evidencia de explotación activa. El catálogo CISA KEV es una señal útil aquí; si una vulnerabilidad está en esa lista, ya se está explotando activamente y debe tratarse con urgencia.
¿Cuál es el estándar de NIST para la gestión de parches?
NIST SP 800-40 es el documento de referencia principal. Describe un enfoque basado en riesgo para la gestión de parches que cubre la planificación, la implementación y el mantenimiento continuo, y los programas de seguridad federales y empresariales lo citan ampliamente.
¿Cómo se manejan los sistemas legados que no se pueden parchear?
Cuando un sistema no se puede parchear, el enfoque pasa a los controles compensatorios: segmentación de redes para limitar la exposición, lista de aplicaciones aceptadas, monitoreo mejorado y controles de acceso estrictos. Esto no elimina el riesgo, pero reduce la superficie de ataque hasta que el sistema pueda actualizarse o retirarse.
¿Cuál es una meta realista de cobertura de parches?
La mayoría de los equipos de seguridad buscan un 95% o más en parches críticos dentro de las ventanas de SLA definidas. Llegar al 100% de manera constante es difícil en la práctica debido a sistemas heredados, excepciones y limitaciones operativas. La pregunta más útil es si tu cobertura en sistemas de alto riesgo expuestos a internet está cerca del 100%.