

Los periodos vacacionales son algo que toda organización debe enfrentar. Ya sean las vacaciones de verano u otro periodo en el que muchas personas toman licencia, la realidad es que muchas empresas operarán durante un tiempo con personal reducido.
Para los equipos de TI y seguridad, esto puede representar un desafío particular.
El trabajo de los proyectos puede ralentizarse o incluso detenerse por completo. Puede haber menos personas disponibles en soporte de TI, redes, aplicaciones y seguridad, así como en el resto de la empresa. Los proveedores externos también pueden estar operando con recursos reducidos.
Entonces, ¿nuestro enfoque ante el cambio debería seguir siendo el mismo?
¿El personal reducido cambia el riesgo?
Una de las primeras cosas que creo que las organizaciones deben considerar es si operar con recursos reducidos cambia su perfil de riesgo o incluso su apetito de riesgo.
Un cambio con el que estaríamos cómodos durante operaciones normales puede verse muy distinto cuando el personal clave está ausente.
¿Podemos realizar el mismo nivel de pruebas? ¿Podemos comunicar el cambio de manera efectiva a la empresa? ¿Contamos con las personas adecuadas disponibles para monitorear lo que ocurre después? Más importante aún, si algo sale mal, ¿tenemos a las personas, el conocimiento y la autoridad disponibles para manejarlo?
El riesgo técnico asociado con un cambio puede no haber variado, pero nuestra capacidad para lidiar con las consecuencias sí podría haberlo hecho.
Esa es una distinción importante.
¿Congelamiento de cambios o cambio controlado?
Una respuesta común es implementar un congelamiento de cambios durante los periodos vacacionales. En algunas circunstancias eso tiene mucho sentido, pero no creo que un congelamiento general deba ser necesariamente la única respuesta.
Existe la oportunidad de planificar antes de entrar en un periodo de personal reducido.
¿Qué cambios están programados? ¿Cuáles son genuinamente necesarios? ¿Cuáles pueden esperar? ¿Cuáles son las dependencias? ¿Cuál podría ser el impacto si algo sale mal, y las personas que realmente estarán disponibles tienen la capacidad de gestionar esas consecuencias?
También hay otro lado de esto desde la perspectiva de la seguridad.
Una vulnerabilidad crítica no le importa que la mitad del equipo de seguridad o TI esté de vacaciones. Si una vulnerabilidad cambia significativamente la superficie de ataque de la organización y existe una alta probabilidad de explotación, no hacer nada puede introducir más riesgo que hacer el cambio.
Por lo tanto, la pregunta no siempre es simplemente si debemos hacer un cambio. A veces se trata de entender el riesgo de hacer el cambio frente al riesgo de no hacerlo.
¿Seguimos teniendo la capacidad operativa?
El personal reducido no debería analizarse solo en términos de números.
Necesitamos entender qué capacidades siguen disponibles.
La organización puede tener normalmente un gran equipo de TI o seguridad, pero ¿qué pasa si las personas con conocimiento detallado de un sistema, aplicación o red en particular están ausentes? ¿Las personas restantes tienen el acceso necesario? ¿Saben cómo recuperar el servicio? ¿Pueden contactar al tercero adecuado si se necesita soporte especializado?
Lo mismo aplica para la toma de decisiones.
Si algo sale mal, ¿las personas que trabajan durante ese periodo realmente tienen la autoridad para tomar las decisiones que podrían requerirse?
Y esto no es solo una decisión de TI. Un incidente podría requerir decisiones de negocio, operativas, financieras o de seguridad. Quienes normalmente toman las decisiones podrían no estar disponibles, así que la organización necesita entender quién tiene esa autoridad en su ausencia.
¿Qué pasa si ocurre un incidente?
La respuesta a incidentes es otra área que vale la pena considerar.
Muchas organizaciones tienen planes de respuesta a incidentes que describen quién debe participar cuando ocurre un incidente significativo. Pero, ¿qué tan bien funciona ese plan cuando una gran parte de esas personas está de vacaciones?
Un plan de respuesta a incidentes que asume un equipo completo, total capacidad técnica y una sala llena de tomadores de decisiones puede verse muy diferente cuando debe ser ejecutado por un equipo reducido.
Las rutas de escalamiento internas y externas también importan aquí.
¿Las personas que trabajan saben a quién contactar? ¿Están disponibles los datos de emergencia y fuera de horario? ¿Pueden contactar al SOC de la organización, al proveedor de soporte de TI, al proveedor de la aplicación u otros proveedores críticos? ¿Y esos proveedores pueden brindar el nivel de soporte que la organización espera durante el periodo de vacaciones?
Estas preguntas acercan mucho más la gestión del cambio, la respuesta a incidentes, la continuidad del negocio y la resiliencia operativa.
Prepara a tu equipo para actuar
Si eres socio o cliente de Huntress, ¿cómo puedes asegurarte de que la plataforma agéntica de Huntress esté configurada de manera óptima para contener y responder a incidentes? A esto lo llamamos Huntress Managed Response.
Para los socios y clientes de Huntress, habilitar Managed Response crea una primera línea de defensa más resiliente. Le da al Centro de Operaciones de Seguridad de Huntress (SOC) permiso para tomar acciones predefinidas y específicas en nombre del socio cuando se publica una amenaza confirmada como reporte de incidente. En lugar de esperar a que alguien revise una alerta, decida qué hacer y presione otro botón, el SOC puede comenzar la contención y la remediación de inmediato.
Huntress Managed Response ofrece varios resultados.
Aislar amenazas en minutos en lugar de horas
El primer resultado es la velocidad. Managed Response está diseñado para comenzar la remediación tan pronto como el SOC confirma una amenaza y publica el reporte de incidente, con el objetivo de contener incidentes en minutos en lugar de horas.
Reducir la brecha entre la detección y la contención puede ayudar a limitar el impacto potencial de un incidente, mientras le da a los equipos de seguridad más tiempo para enfocarse en las prioridades del negocio y en la recuperación.
Respuesta experta disponible cuando tu equipo la necesita
Incluso los equipos más capaces no pueden estar disponibles cada minuto de cada día. Managed Response extiende el alcance de socios y clientes al permitir que los expertos de Huntress tomen acciones iniciales y urgentes en los momentos en que más importan.
Manejo confiable cuando tus recursos están limitados
Los incidentes pueden generar incertidumbre, incluso para equipos experimentados. Managed Response convierte procedimientos de remediación comprobados en una acción repetible.
Para los socios que dan soporte a múltiples entornos, y para los clientes que buscan un proceso de respuesta confiable, esta consistencia facilita operacionalizar, medir y mejorar el manejo de incidentes.
Empoderar a los equipos para pasar rápidamente de la contención a la recuperación
Managed Response se encarga del trabajo inmediato de interrumpir la actividad del atacante y expulsar la amenaza. Los equipos del socio y del cliente pueden entonces enfocarse en asegurar el entorno, restablecer por completo las contraseñas afectadas, identificar la causa raíz, como un correo de phishing, aplicar los parches necesarios y restaurar las operaciones normales.
Para las organizaciones y los socios que las apoyan, habilitar Managed Response es una forma práctica de fortalecer la resiliencia operativa. Reduce la dependencia de una sincronización perfecta, un personal perfecto y la reacción manual, mientras conserva la supervisión, la propiedad de la recuperación y la oportunidad de aprender de cada incidente.
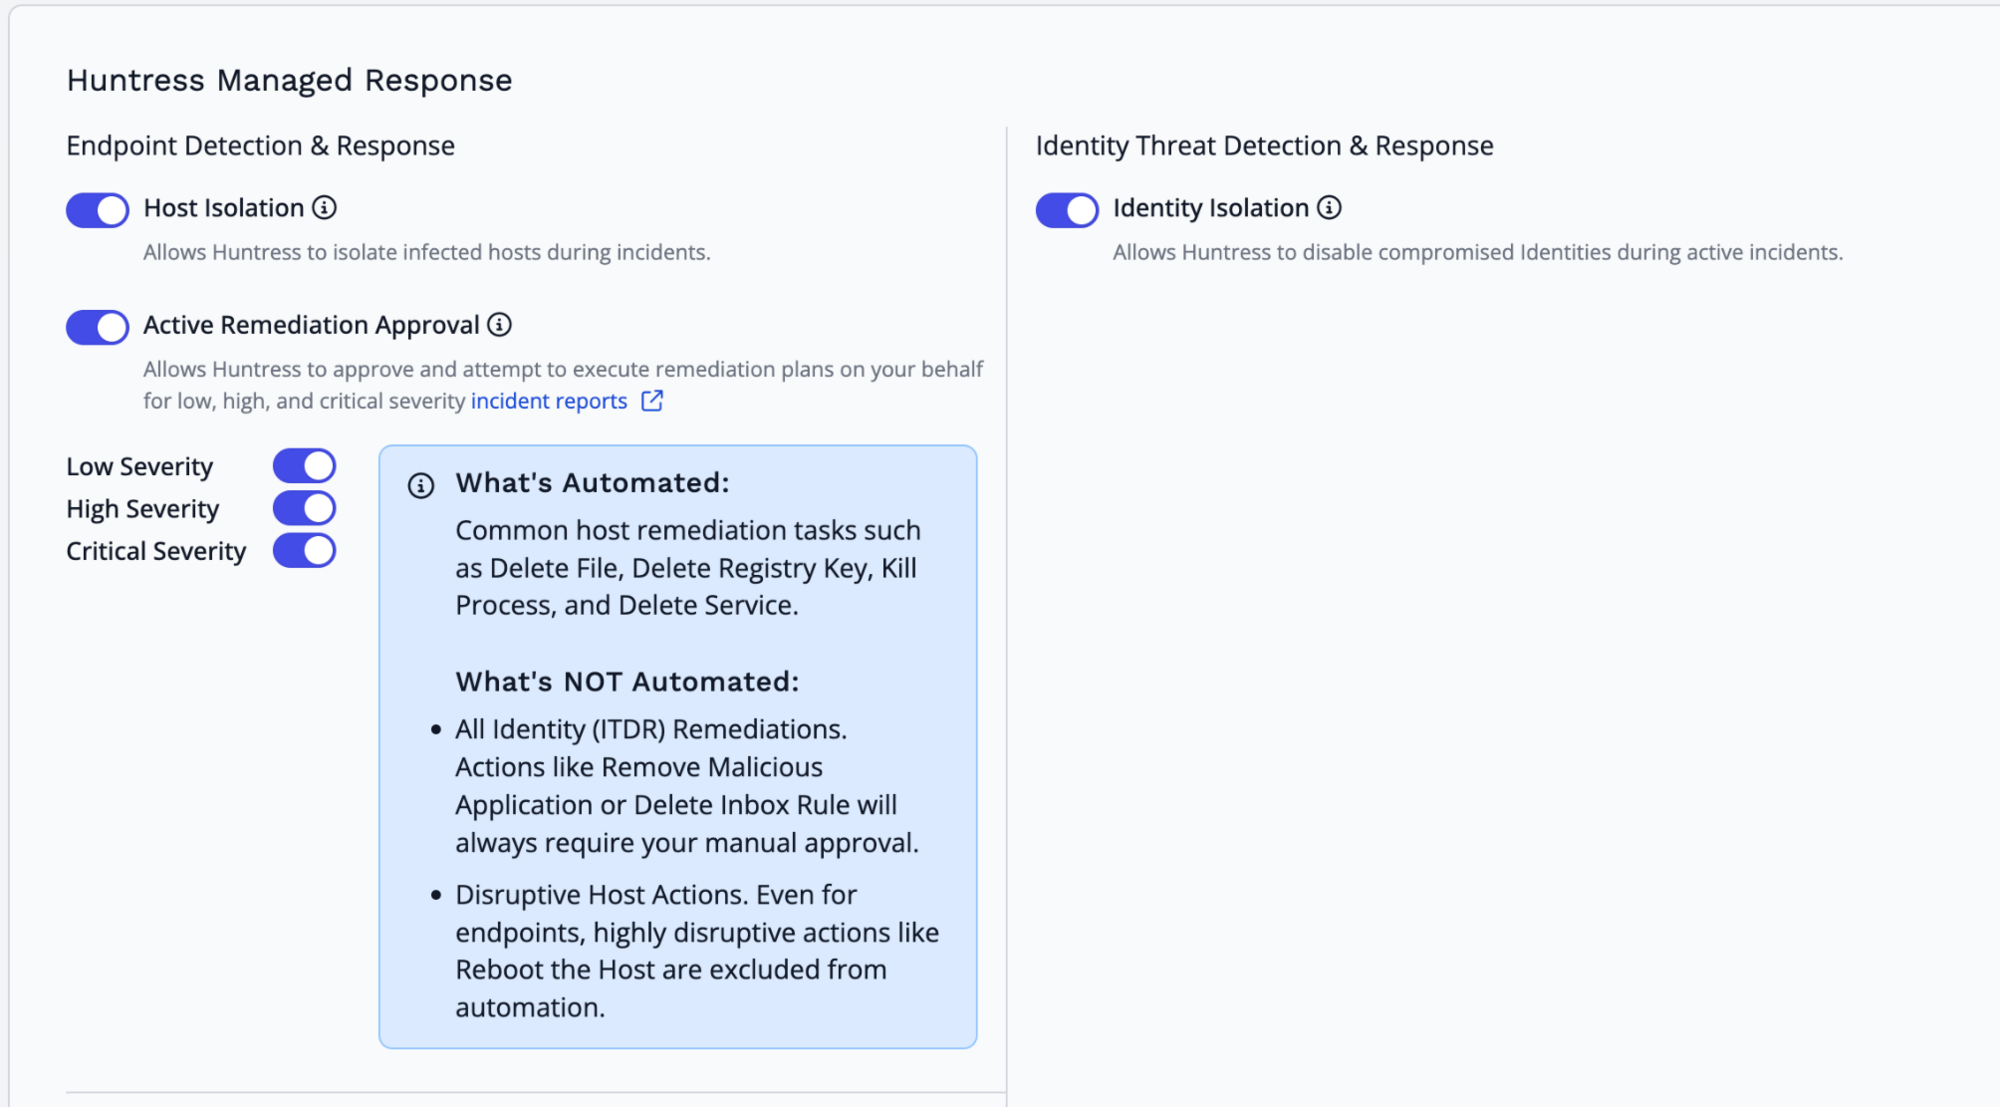
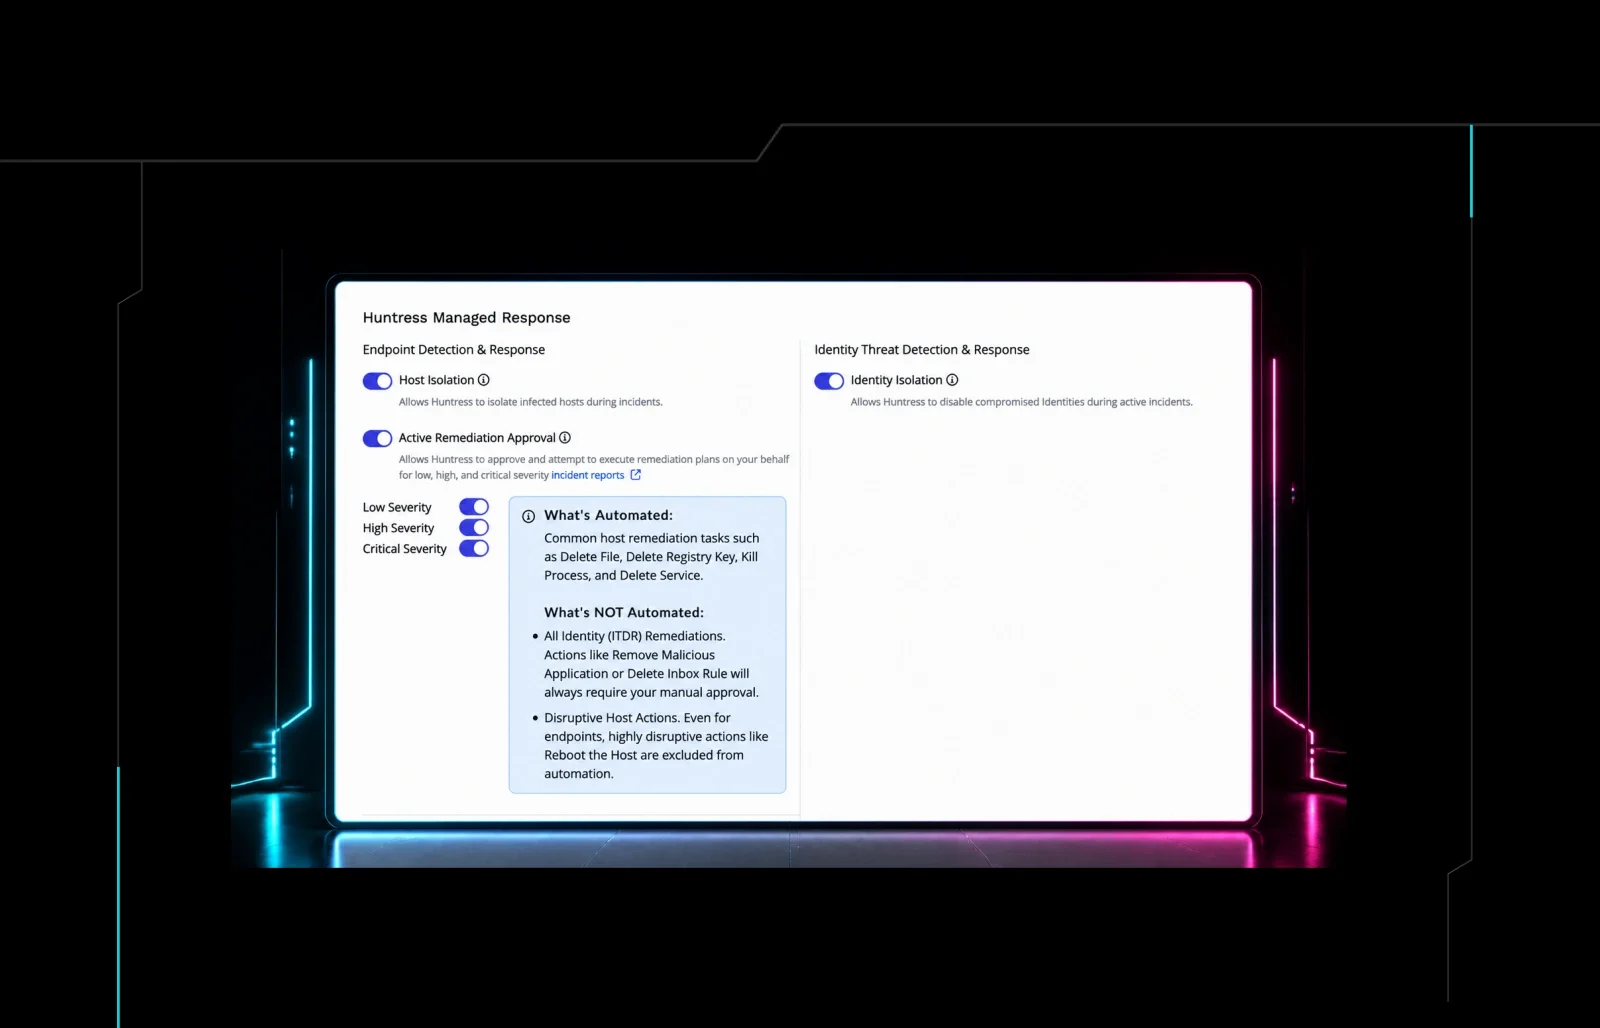
Figura 1: Opciones de contención, remediación y automatizaciones de Huntress Managed Response.
Preguntas que vale la pena hacerse sobre la resiliencia operativa
Antes de entrar en un período de personal reducido, creo que las organizaciones deberían hacerse algunas preguntas simples:
¿El personal reducido cambia nuestro perfil de riesgo actual o nuestro apetito de riesgo?
¿Necesitamos congelar los cambios, o podemos operar con un enfoque controlado para los cambios necesarios?
¿Entendemos las dependencias y las posibles consecuencias de los cambios que se permite que avancen?
¿Qué capacidades mínimas de TI, seguridad y negocio deben seguir disponibles?
¿Contamos con el conocimiento y el acceso adecuados, y no solo con suficiente gente?
¿Las personas que trabajan tienen la autoridad para tomar las decisiones técnicas, de seguridad, operativas, financieras y de negocio necesarias?
¿Nuestro plan de respuesta a incidentes seguiría funcionando de manera efectiva con menos recursos?
¿Son claras nuestras rutas de escalamiento internas, externas, de emergencia y fuera de horario?
¿Hemos confirmado qué soporte está realmente disponible por parte de nuestros terceros críticos?
¿Cómo responderíamos si una vulnerabilidad de seguridad crítica requiriera un cambio urgente?
¿Entendemos el riesgo de no hacer un cambio en particular?
¿Cuál es nuestro plan para volver a las operaciones normales?
Esa última pregunta se pasa por alto fácilmente.
Cuando la gente regresa, puede haber una acumulación de trabajo de proyectos, parches, actualizaciones y otros cambios esperando. Simplemente liberar todo a la vez podría crear otro período de mayor riesgo.
Hace falta pensar en cómo se comunica, prioriza y reincorpora esa demanda al proceso normal de cambios.
La pregunta no es solo si el cambio está aprobado
Nada de esto significa que las organizaciones deban dejar de hacer cambios cada vez que la gente sale de vacaciones.
Significa que las circunstancias en las que hacemos esos cambios deben formar parte de la decisión de riesgo.
Un cambio puede haber sido probado. Puede haber pasado por el proceso normal de cambios. Incluso puede tener un plan de reversión aprobado.
Pero si algo sale mal, ¿quién está ahí para reconocerlo, tomar la decisión, ejecutar esa reversión, comunicarse con el negocio y gestionar las consecuencias?
El riesgo técnico del cambio puede ser exactamente el mismo.
La capacidad de la organización para enfrentar el fallo puede no serlo.
Así que, quizás durante períodos de personal reducido, además de preguntarnos si un cambio ha sido probado y aprobado, hay otra pregunta que deberíamos hacernos: ¿Tenemos la resiliencia operativa para hacer este cambio de forma segura justo ahora?