

Todos hemos visto informes de amenazas y análisis de intrusiones que se ven muy pulidos, con una línea de tiempo coherente que destaca una telemetría y habilidades de análisis increíbles. Abundan los diagramas geniales que ilustran las cadenas de ataque de los actores de amenazas, el beaconing, el acceso a credenciales, ¡todo! Y la verdad es que todos, yo incluido, amamos este tipo de análisis, que destacan diversos productos y servicios y elevan a toda la industria al compartir conocimiento.
Pero, ¿qué pasa cuando hay vacíos en la telemetría? El registro de eventos está desactivado, hay un servidor olvidado, o existe algo heredado bajo el escritorio de alguien que realiza funciones críticas para el negocio.
En estos escenarios, al igual que el gran Skee Lo, terminamos diciendo: "Ojalá…"
- Ojalá este sistema tuviera los registros de eventos que necesito
- Ojalá tuviéramos acceso a la telemetría de red del sistema Y
- Ojalá los registros estuvieran fluyendo hacia un SIEM, ya que se han sobrescrito en el dispositivo VPN
- Ojalá este servicio de Azure tuviera activada su configuración de diagnóstico
La lista de ojalá sigue y sigue.
A veces podemos desear todo lo que queramos: ser más altos, tener un Impala del '64, o contar con más telemetría, y aun así nuestros deseos no se cumplen por alguna razón.
En estos escenarios, tenemos dos opciones: rendirnos y aceptar la derrota con frustración, o ponernos a trabajar, por imperfectos que sean los datos.
En este blog, destacaremos algunas técnicas que el equipo de Respuesta Táctica de Huntress utiliza para dar el máximo valor al socio, incluso frente a una telemetría imperfecta.
Empecemos con la historia de los registros de eventos de Windows faltantes.
Registros de eventos de Windows faltantes
En un caso reciente, recibimos una alerta sobre un evento sospechoso de creación de usuario que ocurrió en un sistema.
Normalmente, en estos escenarios, veríamos quién agregó al usuario y usaríamos eso como punto de partida o hilo para seguir investigando. Rastrear las autenticaciones en entornos Windows puede ser complicado a veces, incluso si todo el registro necesario está activado.
En este caso en particular, observamos que el usuario fue creado por la máquina o la cuenta SYSTEM. Esto sugiere que ocurrió algún tipo de movimiento lateral, en el que el sistema donde se creó el usuario fue accedido desde otro sistema mediante algo como WinRM, WMI, o incluso un RMM.
Para obtener mejores respuestas, recurrimos a los eventos 4624 de Windows Security para ver de dónde provenían las autenticaciones del sistema afectado.
Sorprendentemente, no observamos ningún evento 4624 para el día del incidente, que en este caso fue el 1 de octubre de 2025.
Al ampliar un poco la vista, armamos un gráfico de tiempo que mostraba cuántos eventos 4624 se registraron por día, para determinar cuándo se había registrado el último 4624.
Esto fue lo que encontramos:
Figura 1: Gráfico que muestra la ausencia de eventos 4624 de Windows Security en un sistema de interés
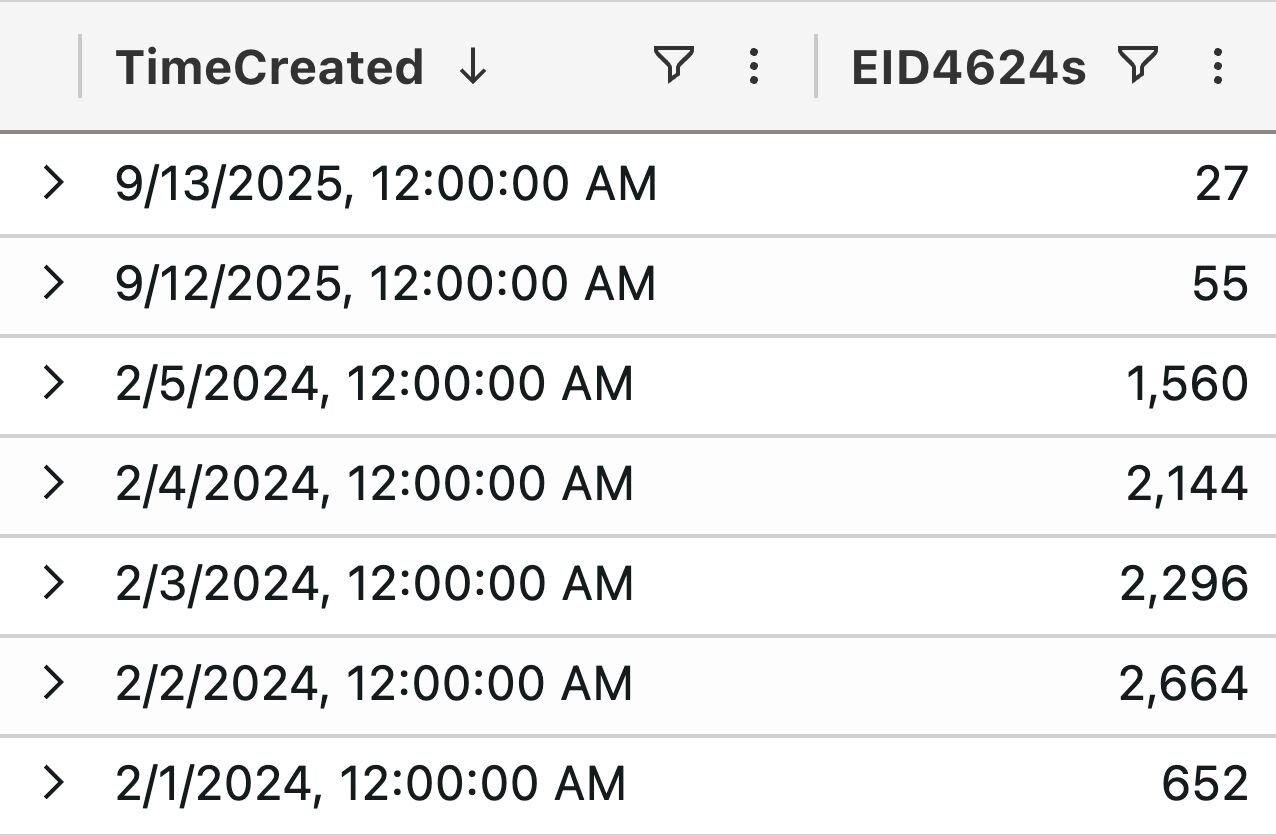
Lamentablemente, el último evento 4624 se registró el 13 de septiembre. Eso no es muy útil para un incidente ocurrido el 1 de octubre.
"¿Y los otros eventos de autenticación?", podrías preguntar.
Por suerte, en este caso, los eventos 4776 de validación de credenciales eran un poco más recientes:
Figura 2: Gráfico que muestra los eventos 4776 de Windows Security en un sistema de interés
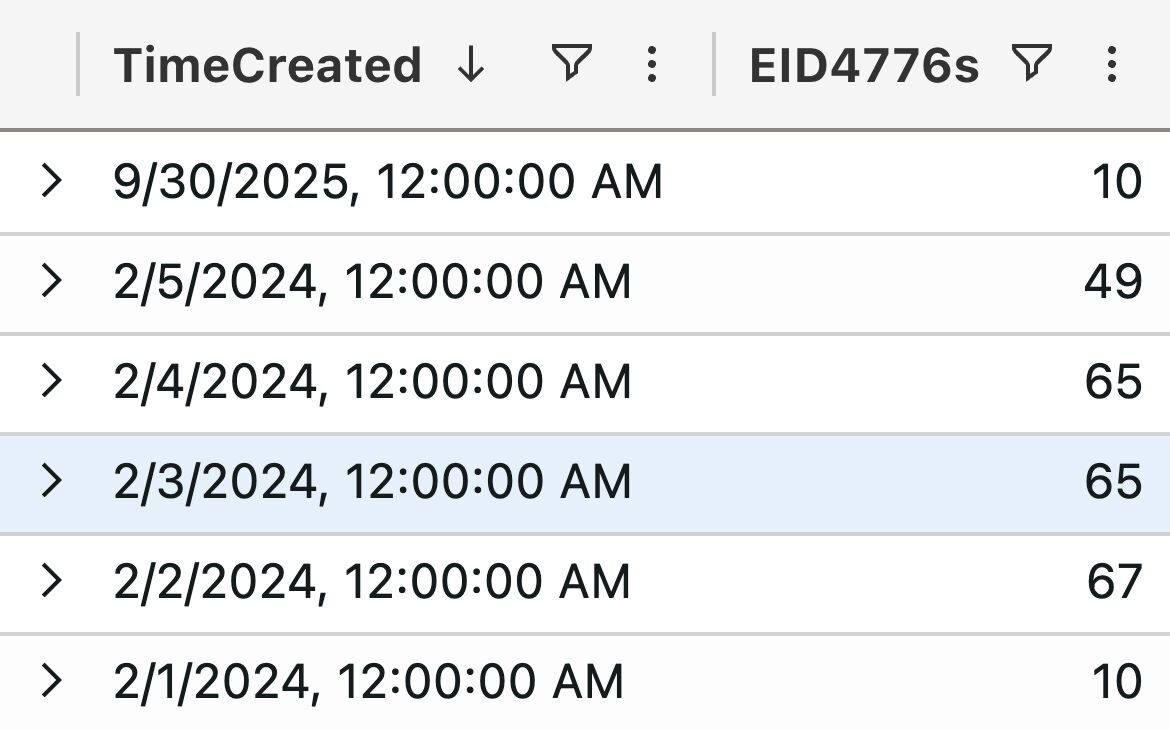
Estos eventos no arrojaron mucha información adicional. También examinamos la caché DNS, las conexiones activas y otros artefactos del endpoint, sin éxito en determinar desde dónde se creó la cuenta de usuario o qué conexiones se hicieron hacia esta máquina.
¿Hacia dónde ir desde aquí?
Al lidiar con intrusiones, a menudo nos enfocamos en lo puramente técnico y perdemos de vista el elemento humano. En este caso, comunicamos nuestros hallazgos al socio. Le informamos que a esta máquina se le había cambiado la política de auditoría, lo que resultó en que no registrara eventos de autenticación críticos que nos habrían ayudado a esclarecer el incidente y responder las preguntas del socio.
En lugar de enfocarnos simplemente en lo que no teníamos, nos enfocamos en lo que sabíamos: sospechábamos que se había accedido a la máquina afectada de forma lateral, pero no teníamos evidencia concluyente que mostrara exactamente desde dónde se accedió.
En este punto, el socio investigó un poco por su cuenta y descubrió que este endpoint en particular exponía un servicio a internet que no debía estar expuesto. Este servicio, de ser explotado, podría haber permitido que un actor de amenazas ejecutara comandos en esta máquina en el contexto de SYSTEM.
Esta dinámica ilustra muy bien la importancia de una comunicación transparente y precisa entre todas las partes interesadas. Podríamos haber pasado horas investigando el endpoint y los sistemas a su alrededor, intentando ubicar el origen de la creación de la cuenta de usuario. Sin embargo, sin comunicación, no habríamos tenido forma de saber sobre el servicio expuesto en esta máquina ni cómo funciona ese servicio en particular.
Aunque no pudimos identificar el origen de esta intrusión con 100 % de certeza debido a la falta de telemetría, aun así pudimos generar resultados de seguridad positivos:
- Al comunicarnos de forma transparente e intencional, pudimos trabajar con nuestro socio para identificar la probable fuente de la intrusión
- Identificamos un vacío crítico de telemetría en sus endpoints, y pudimos precisar cómo y cuándo se habían cambiado las políticas de auditoría en las máquinas
- El socio pudo identificar un servicio expuesto por error en sus máquinas
- Después del incidente, también examinamos la presencia externa del socio e identificamos otros servicios que estaban expuestos
Este escenario plantea una buena pregunta: ¿habría cambiado drásticamente el resultado anterior si la máquina hubiera estado registrando eventos 4624?
Aunque anhelamos la satisfacción de un caso de intrusión perfectamente resuelto, diría que en este caso, el resultado general no habría mejorado drásticamente si los eventos 4624 hubieran estado presentes en la máquina.
¿Qué haces cuando los registros se sobrescriben?
De forma predeterminada, una máquina con Windows almacenará 20 MB de datos en su archivo de registro de seguridad. ¡Incluso los reproductores de MP3 más básicos y baratos de antaño almacenaban más que esto! Y aun así, este valor predeterminado a menudo no se cambia en los entornos.
Esta dinámica se aplica no solo a las máquinas con Windows, sino también a los dispositivos VPN.
Nos encontramos con este escenario con frecuencia, como muestra la Figura 3:
Figura 3: Ilustración de una búsqueda en Slack que muestra casos en los que los registros se han sobrescrito en dispositivos de interés investigativo
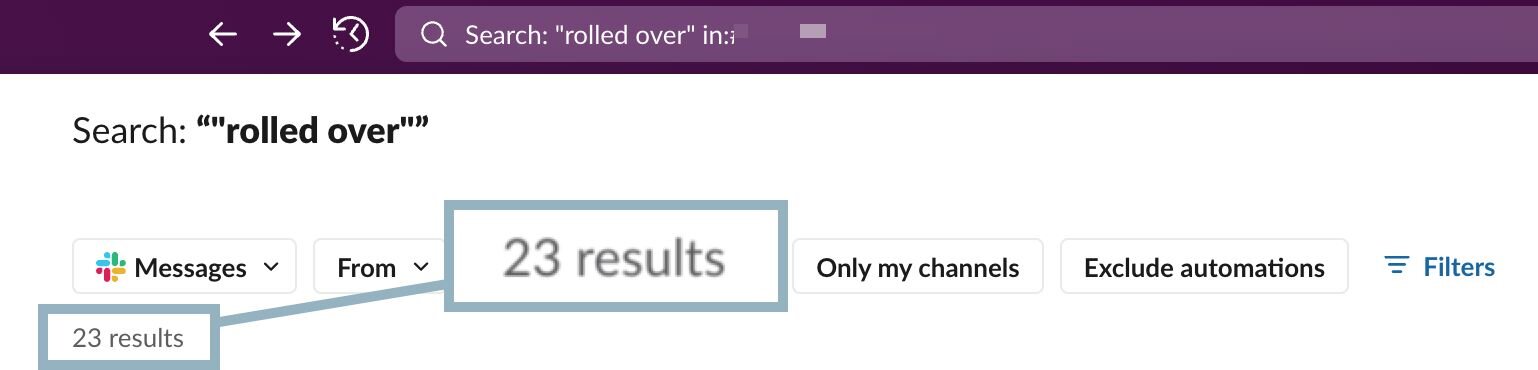
Esta búsqueda ilustra que, en los últimos meses, hemos tenido 23 casos en los que un registro se sobrescribió, ya sea en una máquina o en un dispositivo VPN.
Los registros que se sobrescriben son un evento muy común, uno con el que los analistas de respuesta deben aprender a lidiar y encontrar la forma de resolver.
En máquinas Windows, es común que el canal de registro de seguridad se sobrescriba como si estuviera ocurriendo un ataque de fuerza bruta. Normalmente generaría una gran cantidad de eventos fallidos Security-4625 que llenarían rápidamente un canal de registro de seguridad de tamaño predeterminado.
¿Abandonamos nuestro análisis en este punto? Por supuesto que no.
Un evento de fuerza bruta puede llenar un canal de registro en un endpoint, pero también nos brinda pistas como direcciones IP, nombres de estaciones de trabajo, ventanas de tiempo, entre otras. Usa esta información como punto de referencia y revisa otros endpoints en el entorno, ya que pueden no estar sujetos al mismo ataque de fuerza bruta o tener sus canales de registro configurados para admitir tamaños más grandes.
Otros canales de registro como Application y System normalmente no se llenan tan rápido como el canal de registro de seguridad, así que también vale la pena examinarlos en busca de señales de actividad de actores de amenazas. El canal de registro Application es particularmente útil, ya que registra varias instalaciones de aplicaciones y similares.
Esta misma dinámica también se aplica a los dispositivos VPN. A menudo, el almacenamiento de registros en el dispositivo se satura si el equipo está sujeto a un ataque de fuerza bruta o incluso al ruido general de internet. Como hemos explicado en nuestro blog antes, los dispositivos VPN son un vector de acceso inicial popular para los actores de amenazas, así que dedicamos mucho tiempo a analizar la telemetría de VPN.
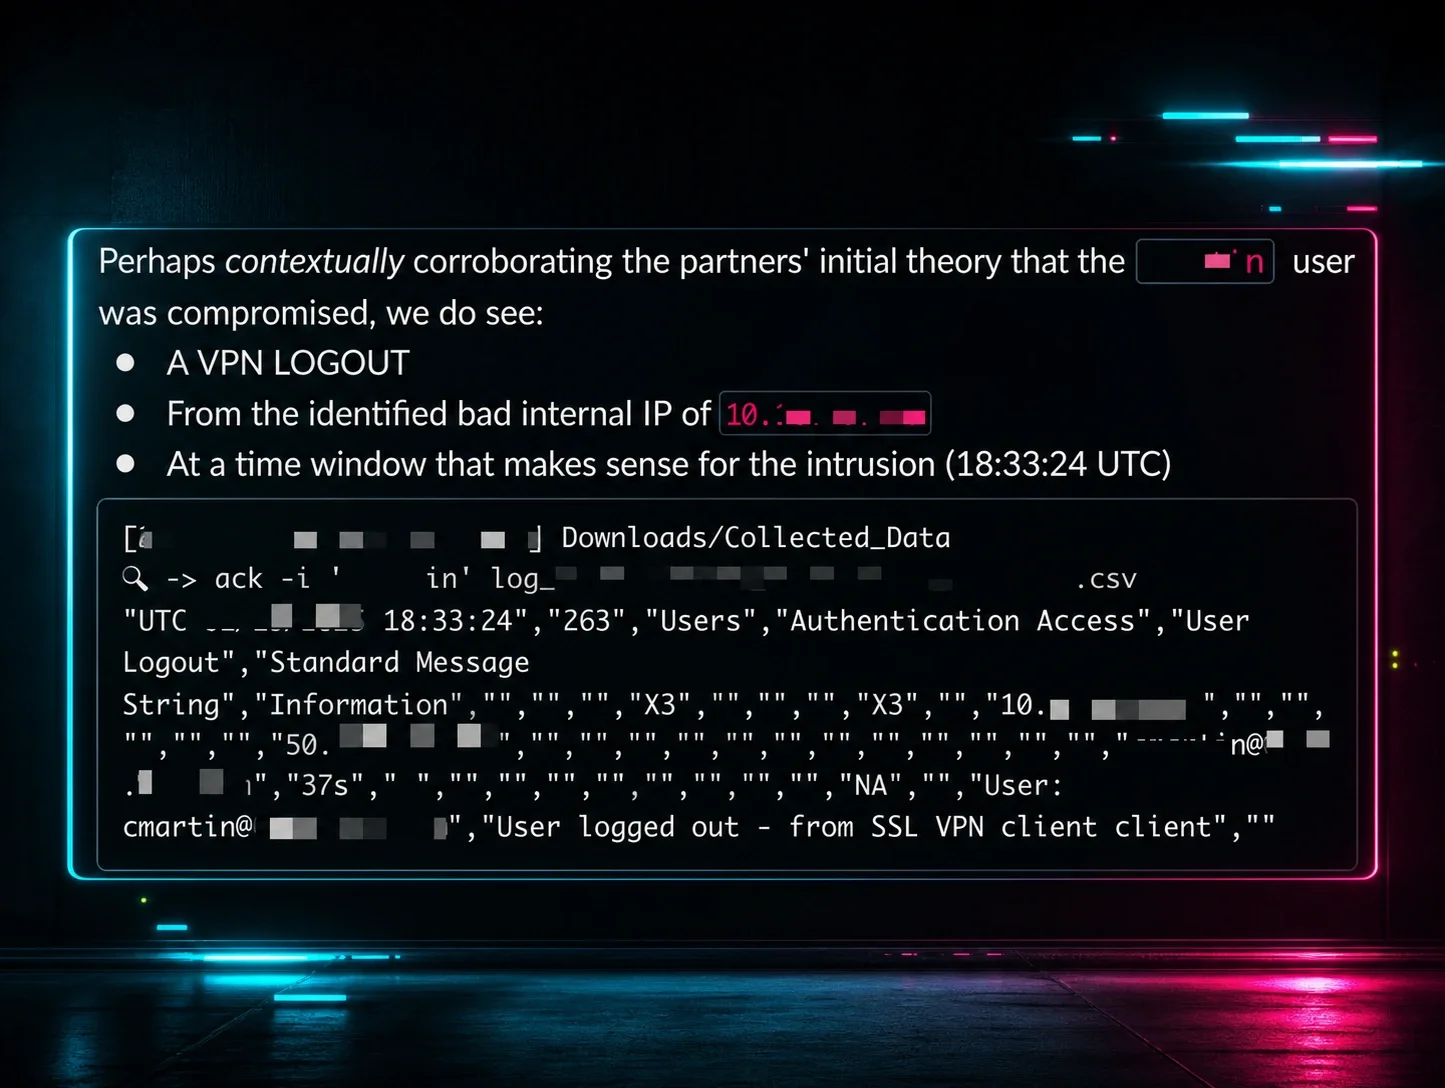
A veces, observamos telemetría de VPN donde un evento de inicio de sesión se sobrescribió, pero hay un evento de cierre de sesión presente que indica actividad maliciosa. Dependiendo de cómo esté configurado un entorno en particular, estos eventos pueden contener solo direcciones IP internas y no externas, pero aun así proporcionan contexto importante.
Un dato clave de telemetría se obtiene a través de los eventos de cierre de sesión de VPN: las asignaciones de IP. Si usamos los registros de eventos de Windows para determinar que una dirección IP en particular fue asignada a una máquina perteneciente a un actor de amenazas, podemos potencialmente rastrear esto hasta su vector de acceso inicial, si el compromiso ocurrió a través de una VPN, usando solo eventos de cierre de sesión, como se ilustra en la siguiente captura de pantalla:
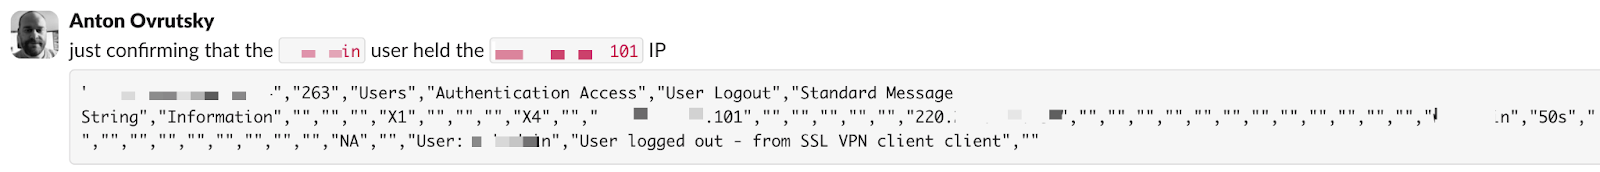
Figura 4: Imagen de un mensaje de Slack que muestra un evento de cierre de sesión de un dispositivo VPN
De igual manera, también podemos combinar esta telemetría de asignación de IP con un elemento temporal, lo que ayuda a reforzar las hipótesis de análisis, como se ilustra a continuación.
Figura 5: Imagen de un mensaje de Slack que muestra el análisis de un registro de VPN sin un evento de inicio de sesión presente
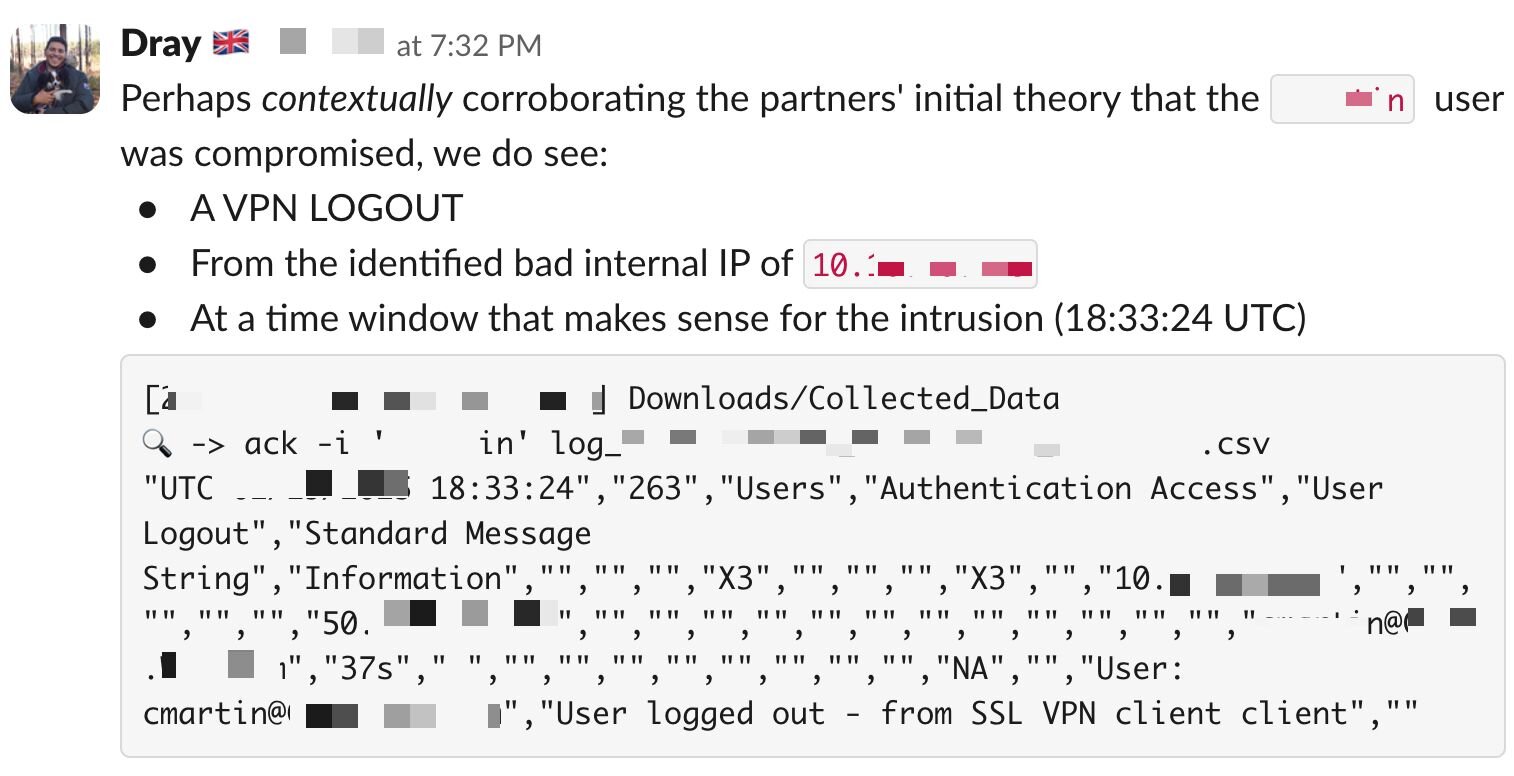
Estos ejemplos ilustran cómo incluso datos imperfectos se pueden usar para resolver casos de intrusión difíciles y brindar a nuestros partners el mayor valor de seguridad posible.
Nubes parcialmente nubladas
Hasta ahora, nos hemos enfocado en los endpoints y los dispositivos VPN al examinar cómo lidiar con telemetría de seguridad imperfecta o degradada. Esta dinámica se agrava mucho en los entornos en la nube, ya que las configuraciones de registro están dispersas en varios servicios y, a menudo, son difíciles de controlar por completo para los equipos de seguridad.
Solo Microsoft Entra tiene alrededor de 18 tipos de registro distintos disponibles, que abarcan desde AuditLogs y SignInLogs hasta tipos de registro más avanzados y recientes como MicrosoftGraphActivityLogs.
Al investigar intrusiones en la nube, probablemente deberíamos asumir que muchos de estos tipos de registro no tendrán sus configuraciones de diagnóstico correspondientes habilitadas.
Si ampliamos un poco la perspectiva y observamos el ecosistema más amplio de Microsoft 365, hay aproximadamente más de 150 tipos de registro diferentes para los servicios de Azure, que abarcan almacenamiento, red y varios servicios de aplicaciones. Esto se suma a otros aproximadamente más de 150 tipos de registro para Office 365, que incluyen aspectos como SharePoint, Teams y Power BI. En total, según lo estimado por un LLM que analizó la documentación de Microsoft, hay hasta más de 900 tipos de registro diferentes en todo el ecosistema de Microsoft 365.
En algunas cadenas de ataque populares dentro de Microsoft 365, como el phishing, los SignInLogs pueden ser suficientes para detectar autenticaciones anómalas. Sin embargo, si el actor de amenazas se mueve a otros servicios como Teams o SharePoint, se necesitan diferentes tipos de fuentes de telemetría para reconstruir una línea de tiempo completa de las actividades del actor de amenazas. En muchos casos, estos registros simplemente no están habilitados.
En estos escenarios, ningún nivel de conocimiento técnico te ayudará, y se necesita un cambio de mentalidad para explicar esta brecha a las partes interesadas relevantes de una manera constructiva en lugar de derrotista.
Las brechas de registro siempre estarán presentes en los entornos, y en entornos particularmente complejos como dentro de la nube de Microsoft 365, estas brechas pueden presentarse con más frecuencia de lo que a quienes trabajamos en este campo nos gustaría.
Las siguientes secciones cubren algunos consejos prácticos y orientación general para lidiar con telemetría relevante para la seguridad degradada, faltante o de otro modo ausente.
Conclusiones para profesionales
Si eres nuevo en el campo de la detección, la respuesta o la caza de amenazas y te has encontrado lidiando con telemetría imperfecta, tenemos los siguientes consejos:
- Enfócate en el contexto más amplio en lugar de en un evento atómico en particular
- Si no ves un evento o una fuente de telemetría presente, ¡no pierdas la esperanza!
- Al mismo tiempo, sabe cuándo has llegado a los límites de lo técnicamente factible: la telemetría no se puede manifestar, solo registrar
- Comunica lo que sabes y lo que no sabes con claridad, con propósito y sin culpar a nadie
- A todos nos encantan los laboratorios donde toda la telemetría que podríamos desear está activada; practica en un entorno de laboratorio con telemetría limitada o degradada, ya que esto puede ayudarte a descubrir fragmentos de telemetría más nuevos o pasados por alto que pueden ser útiles en tus investigaciones
- No te enfoques en lo que no tienes, sino en los datos disponibles y en cómo se pueden usar
- Señalar la telemetría faltante está bien, ¡pero explicar a las partes interesadas por qué esta telemetría es fundamental, cómo habilitarla y a dónde enviarla es aún mejor!
Conclusiones para partners
¿Quieres ayudarnos a ayudarte mientras te aseguras de que la telemetría de tus dispositivos críticos esté disponible para el análisis? Entonces tenemos lo siguiente para compartir:
- Verifica dos y tres veces tus GPO para asegurarte de que tu política de auditoría preferida se aplique a todos los endpoints en tu entorno
- De manera similar, haz un inventario de los servicios en la nube utilizados en tu entorno y verifica que la telemetría relevante no solo esté habilitada, sino también enviada a un SIEM para su análisis
- Hablando de GPO, ¡también puedes usarlos para establecer el tamaño de tus canales de registro! Asegúrate de que el tamaño de los canales de registro, especialmente para canales críticos como Security, esté configurado en al menos unos pocos GB
- Asegúrate de implementar el agente de Huntress en todos tus activos, no solo en servidores o controladores de dominio
- Considera usar nuestro Managed SIEM: enviar los eventos de Windows y los registros de VPN en particular a un SIEM ayuda a protegerte de que los registros se sobrescriban o sean eliminados por un actor de amenazas
Conclusión
En este blog, cubrimos varias técnicas y métodos utilizados por el equipo de Huntress Tactical Response cuando se enfrenta a intrusiones en un entorno con telemetría degradada. Los casos en los que existe una telemetría perfecta para cada rincón que quieres analizar son escasos y poco frecuentes. Una gran cantidad de aspectos técnicos y no técnicos hacen que los entornos del mundo real difieran drásticamente de los diversos entornos de laboratorio y CTF que la comunidad de seguridad aprecia con razón.
Una conclusión clave de este blog es que deberíamos enfocarnos más en investigar entornos con telemetría imperfecta o degradada. En particular, necesitamos poder ajustar no solo nuestros estilos de comunicación al enfrentar este tipo de entornos, sino también nuestra orientación investigativa.