Los actores de ransomware tienen un objetivo principal: ganar dinero. Pero la forma en que lo hacen varía de un ataque a otro.
Antes de activar el payload del ransomware, algunos actores de amenazas intentan dificultar la detección de su actividad o evitar que los expulsen. Otros prefieren un enfoque más de "entrar y arrasar", con un buen conocimiento previo del entorno de la víctima, de las herramientas de seguridad que usa, y más. Los actores de amenazas que siguen este patrón actúan rápido: despliegan el ransomware y luego presionan a la víctima para que pague.
En el Huntress Informe de ciberamenazas 2025, descubrimos que el tiempo promedio hasta el rescate en los incidentes de seguridad fue de casi 17 horas, y los grupos de ransomware realizaron un promedio de 18 acciones antes de activar el payload del ransomware.
Para las empresas, las métricas de tiempo hasta el rescate muestran la urgencia de los ataques de ransomware una vez que los actores de amenazas logran entrar a sus sistemas. Algunos atacantes tuvieron un tiempo promedio hasta el rescate de poco más de cuatro horas después de lograr el acceso inicial, así que cada minuto cuenta para que las empresas definan su estrategia y se preparen ante este tipo de ataques.
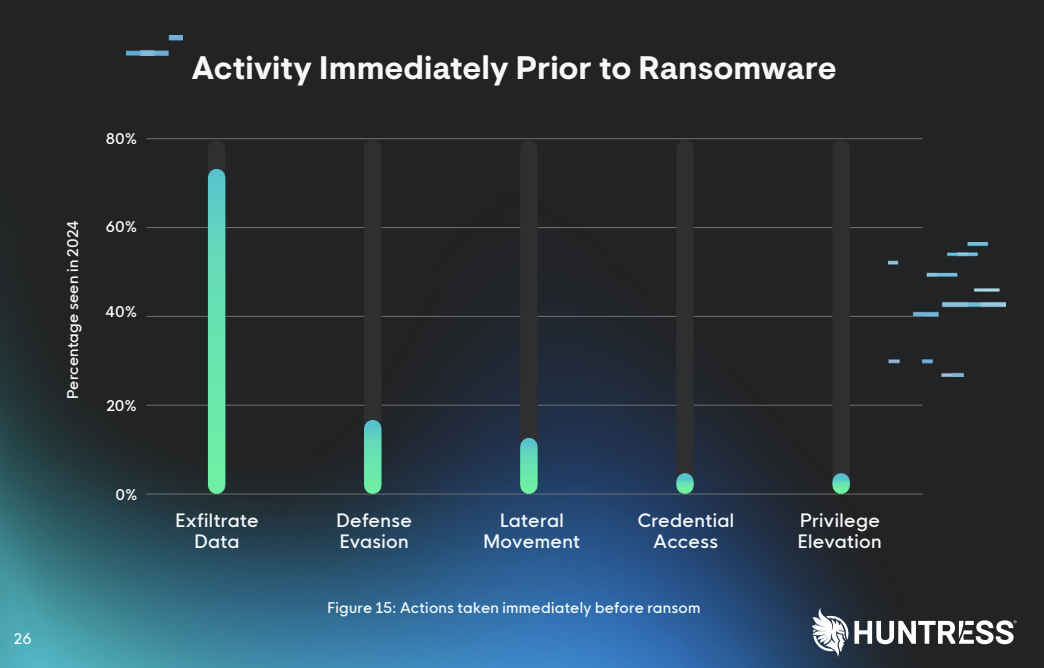 Figura 1: Gráfico de las principales actividades previas al ransomware
Qué nos dice el tiempo hasta el rescate sobre los grupos de ransomware
¿Por qué es importante llevar un seguimiento del tiempo hasta el rescate? Demos un paso atrás y veamos qué nos dice realmente esta métrica.
El tiempo hasta el rescate se mide en la cantidad promedio de horas que tardan los atacantes en pasar del acceso inicial al despliegue real del ransomware. Vimos tiempos de despliegue más rápidos en algunos actores de amenazas, como Play, Akira y Dharma/Crysis, y tiempos más largos en otros, como (irónicamente) Rapid, Sodinokibi y Phobos.
"How Ransomware Groups Plan & Execute Attacks", con la participación de Greg Linares de Huntress, Greg Linares
Otra métrica que estudiamos estaba vinculada a las actividades maliciosas reales que los actores de amenazas llevaron a cabo en una ventana de 48 horas antes de activar el ransomware, como comandos que facilitaban la escalada de privilegios o el movimiento lateral. Actores de ransomware como Phobos y Maze realizaron, en promedio, más de 30 acciones antes de desplegar el ransomware. En el otro extremo, Conti, Play y Black Basta realizaron, en promedio, menos de 10 acciones.
Muchas veces, estas diferencias se explican por los motivos de los actores de amenazas y por cómo abordan los ataques. Actores como Play y RansomHub, por ejemplo, entran a un entorno sabiendo exactamente qué deben hacer para moverse lo más rápido posible.
Pero hay otras consideraciones. Los atacantes que realizan una mayor cantidad de actividades maliciosas podrían tener objetivos relacionados con el robo de datos o el espionaje. Algunos intentan frustrar los esfuerzos de mitigación y respuesta de los equipos de seguridad al atacar las copias de seguridad, borrar registros y desactivar herramientas de seguridad.
Más allá de las distintas acciones que realizan después de lograr el acceso inicial, descubrimos que la mayoría de los actores de amenazas exfiltraron datos justo antes de activar el payload del ransomware. Con el auge de los métodos de doble extorsión y los sitios públicos de filtración de datos, los actores de ransomware buscan sacar el mayor provecho posible de los datos en los sistemas de las víctimas.
Tiempo hasta el rescate: cómo recopilamos los datos
Para determinar el tiempo hasta el rescate, analizamos casos en los que habíamos investigado incidentes de ransomware en entornos de clientes. Usamos datos desde finales de 2023, donde revisamos registros de actividad para:
- Identificar eventos vinculados al ransomware y luego encontrar el punto de acceso inicial o las primeras señales de actividad maliciosa observada, ya sea mediante el acceso no autorizado a una cuenta con credenciales robadas o a través de ataques de fuerza bruta contra el escritorio remoto (RDP)
- Registrar el tiempo promedio que tardaron los actores de amenazas en pasar de ese punto de acceso inicial o de la primera actividad maliciosa detectada hasta el eventual despliegue del ransomware
- Atribuir el tiempo hasta el rescate a distintos grupos de ransomware según la nota de rescate que los actores de amenazas entregaron durante el incidente
Es importante señalar que existen varias variables que podrían afectar el tiempo hasta el rescate en cualquier incidente dado.
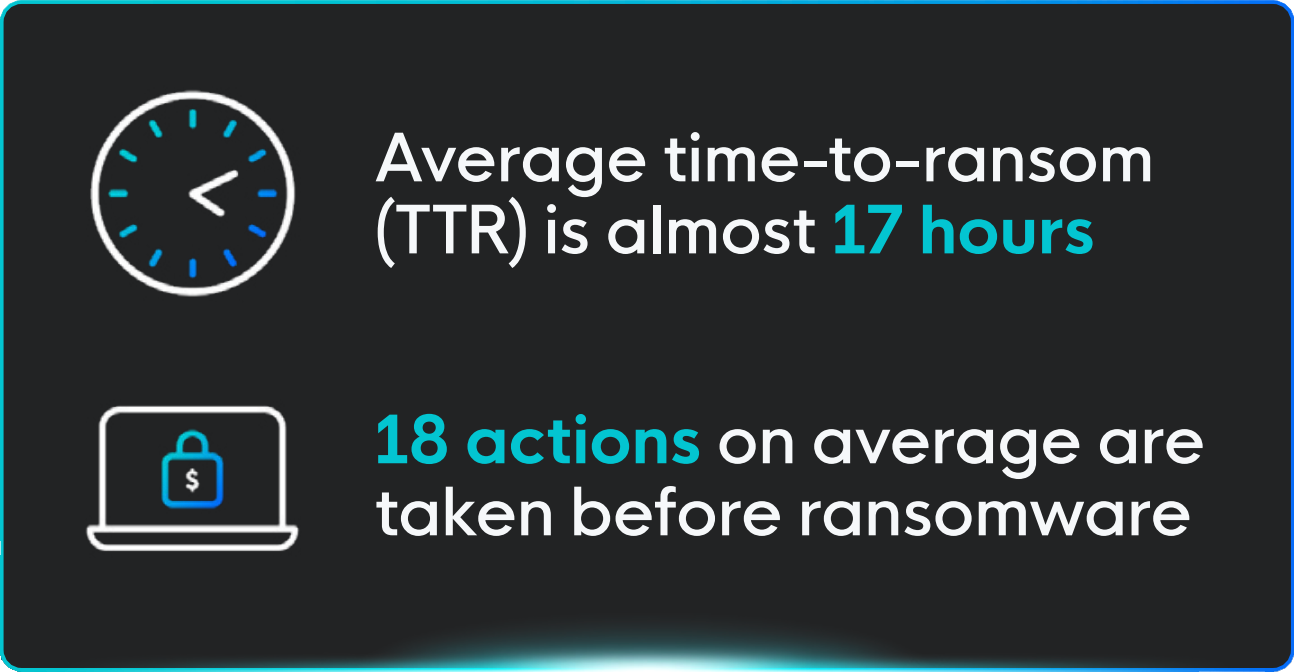 Figura 2: El TTR promedio y las acciones realizadas antes del despliegue del ransomware
Una variable importante aquí es la visibilidad de Huntress: por ejemplo, en algunos incidentes, Huntress se instaló en respuesta a un posible incidente, o no se instaló en todos los endpoints, lo que podría limitar lo que podíamos ver. Otras veces, los actores de amenazas usaron técnicas de evasión de defensas, como deshabilitar registros de eventos, lo que puede limitar el alcance de la visibilidad sobre el funcionamiento interno del ataque.
Huntress también trabaja con organizaciones que tienen redes más pequeñas. Eso podría afectar el período de tiempo de los incidentes de ransomware que observamos: el movimiento lateral, por ejemplo, se ve distinto en una red pequeña comparado con cómo podría verse en redes empresariales más grandes.
Ningún incidente es igual a otro, y las diferencias dentro de los propios ataques también pueden afectar el tiempo y el número de acciones maliciosas vinculadas a un incidente. El punto de acceso inicial para los actores de amenazas podría influir en la rapidez con la que aceleran el ataque, por ejemplo. Los actores de amenazas que obtienen acceso inicial mediante credenciales comprometidas de una cuenta con privilegios de nivel inferior podrían necesitar pasos adicionales, como aprovechar un desbordamiento de búfer basado en heap que podría ser explotable por usuarios locales, para elevar privilegios. Por otro lado, si los actores de amenazas obtienen acceso a una cuenta de administrador, contarán con esos privilegios desde el principio y estarán listos para actuar de inmediato.
La historia de dos incidentes
Veamos dos incidentes distintos y cómo se desarrolló el tiempo hasta el rescate en esos ataques.
El año pasado, respondimos a un ataque de ransomware INC contra una entidad del sector salud. En este caso, la primera evidencia de que algo andaba mal fue el 22 de diciembre, cuando una estación de trabajo controlada por el atacante tuvo acceso a una cuenta durante más de nueve minutos. Seis días después, el 28 de diciembre, se vio a una cuenta de administrador moviéndose con rapidez, extrayendo credenciales y cifrando endpoints.
Durante el recorrido más largo de tiempo hasta el rescate en este incidente, estas son algunas de las cosas en las que se enfocó el actor de amenazas entre el acceso inicial y el despliegue del ransomware
- Volcar credenciales almacenadas en la memoria de proceso del Local Security Authority Subsystem Service (LSASS): Aquí, el actor de amenazas intentó volcar las credenciales de LSASS mediante la utilidad de línea de comandos ProcDump (“C:\ Windows\Temp\Procdump\procdump.exe”)
- Intentar desactivar herramientas de seguridad para evitar la detección: El actor de amenazas intentó desactivar Microsoft Defender después de que este bloqueara el intento inicial de implementar el ejecutable del ransomware.
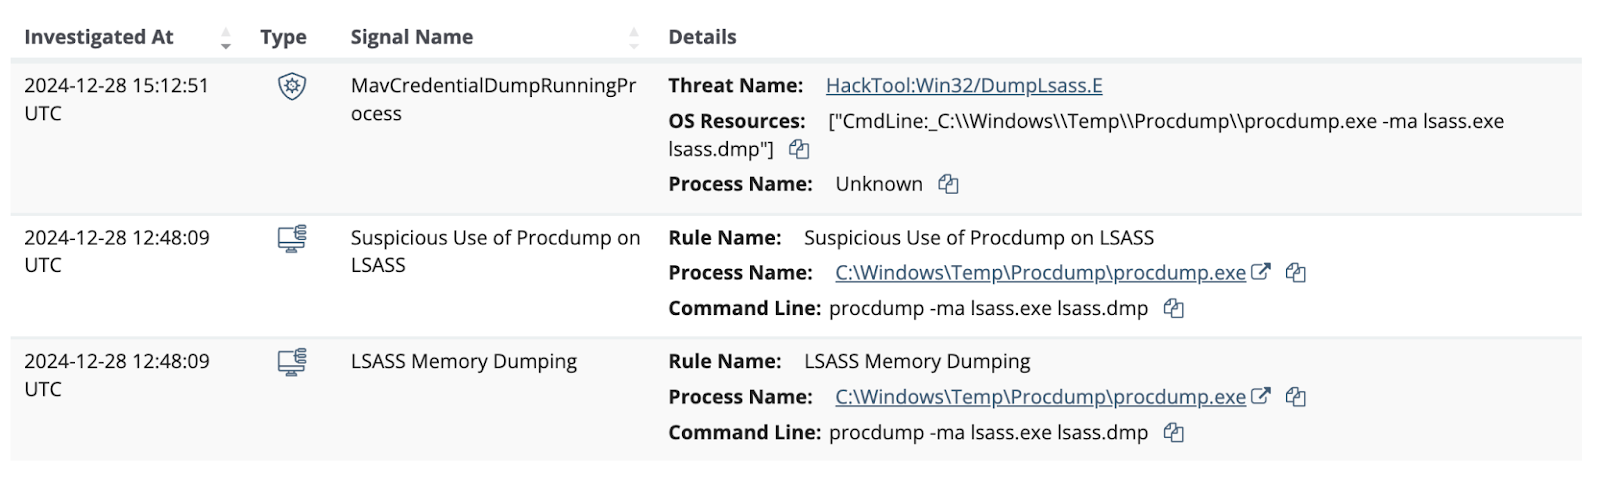 Figura 3: Señales que muestran el volcado de credenciales con ProcDump
Ahora, veamos otro incidente, ocurrido en el mismo mes (diciembre de 2024), pero esta vez con un tiempo hasta el rescate más rápido. En este incidente, el actor de amenazas atacó a una empresa de tecnología y desplegó el ransomware Akira.
Los primeros indicios de actividad vinculada al actor de amenazas provinieron de una cuenta legítima con credenciales robadas, desde una estación de trabajo conocida y controlada por el atacante, el 12 de diciembre. Al día siguiente, el atacante realizó una serie de actividades en rápida sucesión antes de implementar el ransomware, entre ellas:
- Movimiento lateral: El actor de amenazas usó WMI para modificar el registro y facilitar el movimiento lateral a través de RDP.
- Autenticación alternativa: El actor de amenazas ejecutó un comando de PowerShell para desactivar el modo de administrador restringido en RDP, un modo que permite a los usuarios iniciar sesión en servidores remotos sin transmitir sus credenciales al servidor. Cuando este modo está desactivado, podría ser indicio de un ataque pass-the-hash, en el que los actores de amenazas roban versiones hash de las credenciales de usuario y las usan para crear nuevas sesiones en la misma red.
Como se mencionó antes, una variable importante para medir el tiempo hasta el rescate es la posición de Huntress y su conocimiento del incidente. En ambos casos, Huntress recibió alertas de ciertas señales, como un canario de ransomware activado que indicaba que los datos de una máquina habían sido cifrados, o argumentos sospechosos a través de WMI que podrían indicar movimiento lateral.
Si bien esto nos dio una idea de en qué punto del ataque se encontraba el actor de ransomware en ese momento, una revisión retrospectiva y más detallada de los registros de eventos de seguridad nos dio las pistas hasta el punto de acceso inicial. En casos como estos, contar con gestión de eventos e información de seguridad (SIEM) podría dar a las organizaciones una forma más proactiva de reconocer amenazas antes de que escalen.
¿Por qué debería importarnos el tiempo hasta el rescate?
Para las empresas, observar las acciones que realizan los actores de amenazas —y el tiempo que dedican a realizarlas— antes de activar el ransomware puede dar una idea aproximada de las oportunidades de detección que existen antes de que se implemente el ransomware, y de cuánto tiempo podrían tener para responder a los ataques de ransomware en general.
Hay una marcada discrepancia al comparar los promedios de tiempo hasta el rescate con el cronograma de respuesta de las empresas ante un ataque. Un informe de 2024 de Statista encontró que la duración promedio de la interrupción tras ataques de ransomware en empresas de EE. UU. fue de 24 días. Eso significa que un ataque de horas podría derivar en una interrupción de semanas para la víctima.
Como hemos expuesto, muchos actores de ransomware se basan en métodos probados para sus ataques, y las empresas deben estar preparadas. Aquí algunas formas de ser proactivo:
- Mantén copias de seguridad cifradas y sin conexión para los datos críticos, y pruébalas en escenarios de recuperación ante desastres
- Crea un manual de respuesta a incidentes, revisado y comprendido en toda la cadena de mando de tu empresa, que deje claro:
- Quién se encarga de qué en las fases de remediación inmediata, contención y recuperación
- Cómo se manejarán los procedimientos de notificación de filtraciones de datos y posibles problemas de cumplimiento
- Cómo se comunicarán los detalles y las actualizaciones, tanto dentro de la organización como con el público