

Puntos clave:
El cifrado es el último paso de la intrusión. El informe M-Trends 2026 de Mandiant ubica la mediana global del tiempo de permanencia en 14 días, así que lo que para ti es la hora cero, para ellos suele ser la segunda semana.
Da por hecho que los datos salieron antes de que se bloquearan los archivos. El aviso de CISA sobre Akira registra casos en los que la exfiltración se completó dos horas después de que el atacante entrara.
Restaura algo desde una copia de seguridad antes de que alguien le dé a la junta directiva un tiempo de recuperación. Los grupos de ransomware ahora buscan la infraestructura de copias de seguridad a propósito.
La mayoría de las fallas del primer día son fallas de decisión. Los pasos técnicos están escritos en algún lado. La autoridad para tomarlos, por lo general, no.
El primer reporte rara vez proviene de una regla de detección. Viene de un supervisor de turno que no puede abrir el calendario de producción, o de un empleado de finanzas que encontró un archivo de texto en la unidad compartida con instrucciones de pago.
Para cuando esa llamada te llega, la parte del ataque que todavía puedes influir ya comenzó. Lo que sigue es la forma de un primer día, hora por hora, tal como lo he visto ocurrir en casos de ransomware en producción de alimentos, servicios empresariales y retail. Las marcas de hora son aproximadas. El orden no lo es.
Hora 0: El reloj empezó mucho antes de que lo notaras
Lo más útil que puedes establecer en los primeros diez minutos es cuándo comenzó esto, y la respuesta casi nunca es hoy.
El informe M-Trends 2026 de Mandiant, publicado en marzo de 2026 y basado en más de 500.000 horas de investigaciones en primera línea, reporta que la mediana global del tiempo de permanencia subió a 14 días desde 11.
Un segundo hallazgo de ese informe cambia la forma en que delimitas el día. En 2022, la mediana del tiempo entre un evento de acceso inicial y la transferencia a un segundo grupo de amenazas era de más de ocho horas. Para 2025, se redujo a 22 segundos.
La consecuencia práctica: el grupo que cifra tus archivos a menudo no es el grupo que entró. Estás reconstruyendo dos conjuntos de actividad con herramientas y objetivos distintos, y el silencioso llegó primero.
Horas 0 a 1: Confírmalo antes de decir la palabra
Decir "ransomware" en voz alta inicia una cadena de llamadas que no puedes deshacer, así que la primera hora compra certeza. Revisa si la nota de rescate está en más de un endpoint, si una extensión de archivo cambió en todo un recurso compartido o solo en una estación de trabajo, y si tu Detección y respuesta para endpoints (EDR) muestra modificación masiva de archivos por un solo proceso.
Un trabajo de respaldo fallido y un cliente de sincronización roto se ven igual desde un ticket de mesa de ayuda, y equivocarte al llamarlo te cuesta credibilidad que vas a necesitar después.
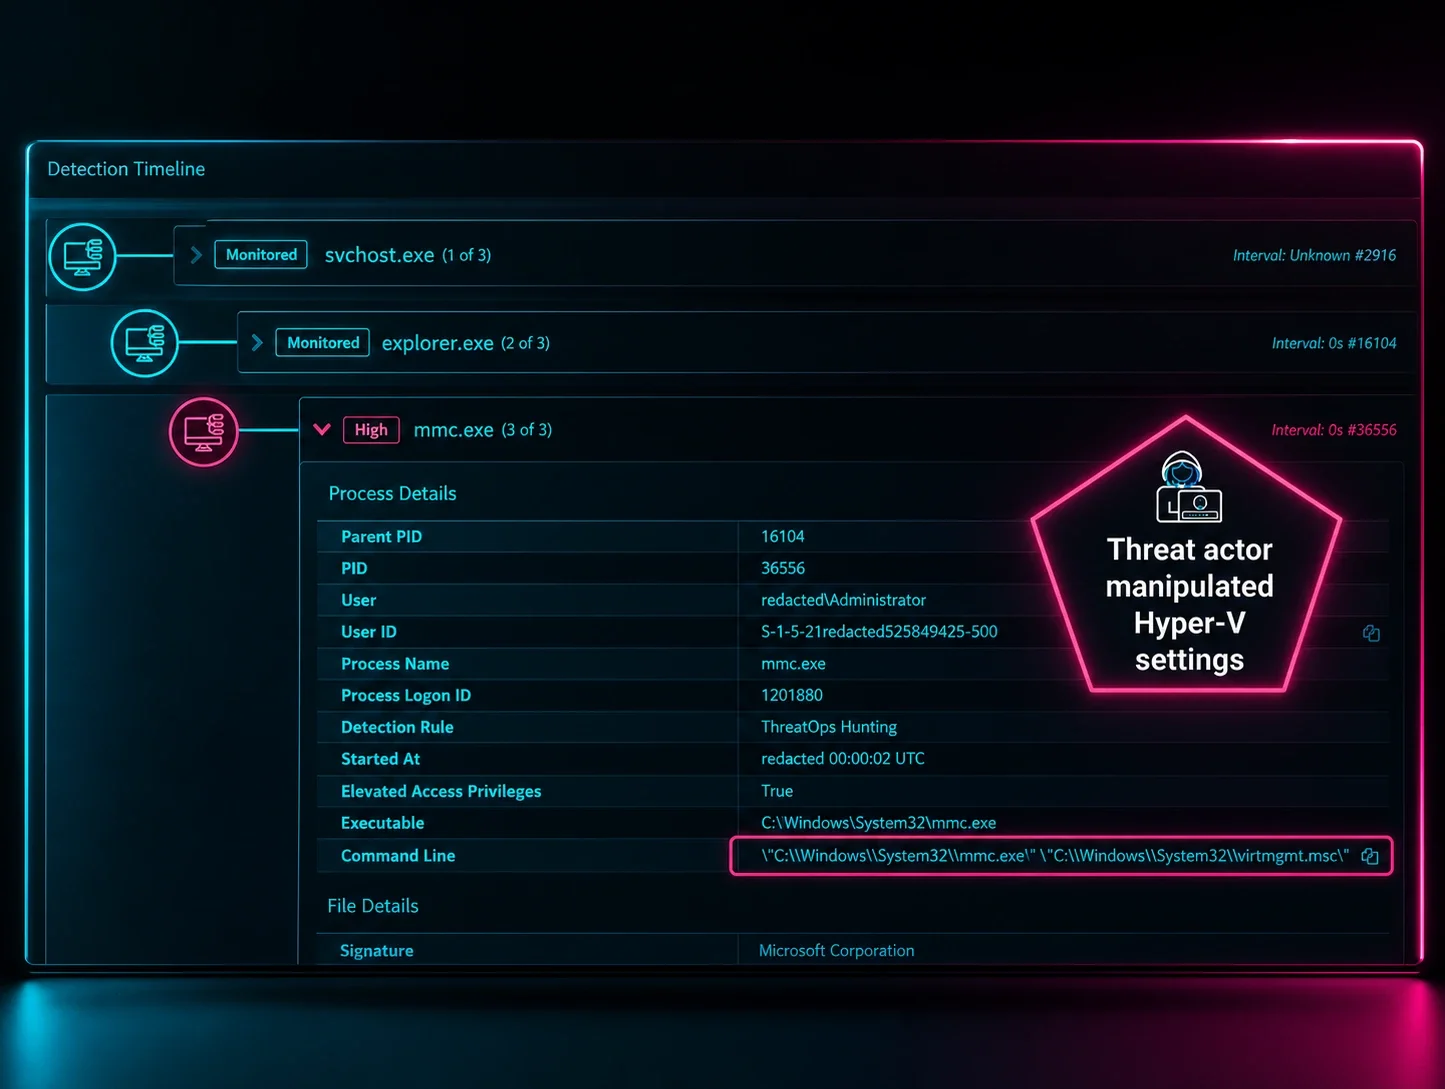
Equivocarte en la otra dirección cuesta más. En un caso al que respondieron los especialistas de UnderDefense, el ransomware ya había llegado a 22 hipervisores para cuando alguien contestó el teléfono. La señal había llegado como un puñado de alertas poco notables repartidas a lo largo de una semana.
Así que delimita por radio de impacto: un endpoint, un recurso compartido de archivos, un controlador de dominio, la capa de virtualización. Cada paso hacia arriba en esa lista cierra decisiones en la siguiente sección.
Horas una a dos: Decisiones de contención que no puedes revertir
La primera hora decide la mayor parte del resto. Cada acción de contención compra algo y destruye algo, y ese intercambio casi nunca está escrito en ningún lugar que tu ingeniero del turno nocturno pueda encontrar a las 3:00 a. m.
Acción | Qué detiene | Qué te cuesta | Elígela cuando |
|---|---|---|---|
Aislar el endpoint de la red desde la consola de EDR | El movimiento lateral y el comando y control desde ese endpoint | Tu propio acceso remoto, a menos que mantengas abierta una lista de aceptados | El endpoint todavía ejecuta un agente que controlas |
Desconectar el cable | Lo mismo, en un endpoint sin agente | Acceso remoto, sin opción de lista de aceptados | No hay agente y alguien puede llegar a él físicamente |
Apagar el endpoint | El cifrado que aún se ejecuta en ese disco | La memoria, que a menudo contiene el proceso inyectado, las herramientas del operador y a veces material de claves | Los archivos se están cifrando activamente y no tienes otra forma de detenerlo |
Deshabilitar la VPN y el acceso remoto externo | El reingreso por la ruta que más probablemente usaron | El personal remoto y cada tercero que da soporte a tus sistemas | Temprano, a menos que una dependencia documentada te lo impida |
Deshabilitar las cuentas comprometidas y restablecer krbtgt dos veces | La reutilización de tickets y credenciales robadas | Una ola de fallas de autenticación que después tendrás que clasificar | El robo de credenciales está confirmado y puedes programar ambos restablecimientos |
Apagar el clúster de hipervisores | El cifrado propagándose por todos los invitados a la vez | Cada sistema en él, incluidos los sanos | El plano de administración mismo está confirmado como comprometido |
La fila de la VPN es la que yo actuaría primero. El aviso de CISA sobre Akira, actualizado en noviembre de 2025 junto con el FBI, el EC3 de Europol y socios en Francia, Alemania y los Países Bajos, enumera un servicio VPN sin autenticación multifactor configurada como un vector de acceso principal. Si el tuyo está en ese estado, cerrarlo es a la vez contención y causa raíz.
La velocidad aquí vale más que la elegancia. En un caso de retail en Suiza que comenzó con una ola de más de 3.000 correos sin relación aparente, la intrusión se contuvo en 43 minutos y se detuvo antes de que se llegara a desplegar el ransomware.
Horas dos a cuatro: Los datos salieron antes de que se bloquearan los archivos
Trata la exfiltración como confirmada hasta que puedas demostrar lo contrario, porque la cronología no te da ninguna razón para suponer otra cosa. El mismo aviso de CISA registra que, en algunos incidentes, los operadores de Akira exfiltraron datos en poco más de dos horas desde el acceso inicial, y ubica las ganancias reclamadas en aproximadamente $244,17 millones a finales de septiembre de 2025.
La herramienta usada es común, y por eso pasa desapercibida en una revisión de registros casual. El aviso menciona FileZilla y WinRAR para preparar los archivos, WinSCP y RClone para la transferencia, Mega para almacenamiento en la cloud y Ngrok para la creación de túneles: casi todo software que tus administradores tienen una razón legítima para usar.
Busca patrones de volumen y destino. Las firmas de malware no detectarán esto. Un solo endpoint que envía decenas de gigabytes a un endpoint de cloud de consumo durante un fin de semana es la señal que buscas.
Esta también es la hora en que tu asesor legal se une a la llamada, porque lo que salió del edificio determina a quién hay que avisar y para cuándo.
De la hora tres a la seis: abre un respaldo antes de prometer un tiempo de recuperación
El peor momento del primer día suele ser aquel en que alguien restaura un archivo de prueba y este no vuelve.
M-Trends 2026 describe esto como un cambio deliberado hacia la negación de la recuperación. Sus autores observaron que los operadores, incluidos grupos que usan REDBIKE y AGENDA, "atacaron activamente la infraestructura de respaldo, los servicios de identidad y los planos de gestión de virtualización", y registran que los atacantes eliminan objetos de respaldo directamente del almacenamiento en la cloud. El aviso de CISA documenta la versión más simple de la misma idea: copias de sombra de volumen eliminadas con un breve comando de PowerShell.
Antes de que alguien le dé un tiempo de recuperación a un ejecutivo, recorre esto y anota lo que encuentres:
Restaura un archivo real del respaldo más reciente y ábrelo.
Verifica si el servidor de respaldo se autentica contra el mismo dominio que estás por reconstruir.
Confirma en la consola que la inmutabilidad o el bloqueo de objetos esté activado hoy.
Encuentra la última fecha en que se probó realmente una restauración completa de principio a fin.
Identifica quién tiene credenciales para la consola de respaldo que no sean cuentas de dominio.
Cada respuesta aquí es una hora de recuperación que puedes prometer, o una que no puedes. La frase más costosa del primer día es "tenemos respaldos", dicha por alguien que no ha restaurado ninguno.
De la hora cuatro a la ocho: los problemas difíciles dejan de ser técnicos
Para entonces, el panorama técnico ya es lo bastante estable para actuar, y el día se convierte en decisiones que ningún ingeniero tiene la autoridad de tomar.
Alguien debe aprobar sacar de línea una línea de producción, y decidir si la planta funciona en papel durante un turno. La ventana de notificación de tu aseguradora, el reloj de reporte de tu regulador y la cláusula de brecha de tu cliente más grande comienzan con eventos distintos y corren a velocidades distintas, y ninguno se detiene mientras investigas.
La pregunta sobre el rescate llega antes de lo que la mayoría de los planes esperan, y recae sobre quien esté en la sala. Si entablas contacto, quién puede comunicarse y quién da la aprobación final son tres respuestas distintas, y un incidente es un mal lugar para descubrir que no tienes ninguna de ellas.
Aquí es donde he visto fallar la mayoría de los primeros días. El manual de procedimientos describe el aislamiento y el análisis forense en detalle, y no nombra a nadie. Escribe los nombres antes de necesitarlos, con un suplente para cada uno, porque la persona que anotaste eventualmente estará en un avión.
De la hora 8 a la 16: no puedes reconstruir hasta saber cómo entraron
Reconstruir sobre una causa raíz sin responder te compra un segundo incidente.
La identidad es donde vive esta investigación. El aviso de CISA documenta que los operadores de Akira extraen credenciales con Mimikatz y LaZagne, las sacan de la memoria de LSASS y ejecutan Kerberoasting contra cuentas de servicio. Cualquiera de estas cosas significa que las credenciales que estás por restablecer eran legibles mucho antes de que empezara el cifrado.
El relato de UnderDefense sobre una intervención en Colorado describe el paso de detectar Cobalt Strike a eliminarlo de 11 servidores críticos en menos de 24 horas, algo que solo se logra cuando el punto de entrada y el alcance de las credenciales se resuelven mientras la contención todavía está en marcha.
Resuelve las preguntas que condicionan una reconstrucción:
¿Qué cuenta se usó primero, y era de una persona o de un servicio?
¿Faltaba la autenticación multifactor, se evadió, o se satisfizo con un token de autenticación de sesión robado?
¿Qué sistemas tocó esa cuenta en los 30 días previos al evento de cifrado?
¿Tus controladores de dominio todavía conservan los registros de esa ventana, o ya se rotaron?
¿Qué cuentas de servicio tienen contraseñas anteriores a la intrusión y no se pueden rotar sin provocar una interrupción?
La última pregunta suele añadir un día. Nadie documenta el trabajo por lotes de 2019 que falla cuando cambia su contraseña, y todos lo descubren a las 02:00 del segundo día.
De la hora 16 a la 24: recuperación por etapas, y qué significa "estar en línea de nuevo"
La recuperación sigue un orden, y la identidad va primero. Un controlador de dominio limpio en un segmento aislado es contra lo que todo lo demás se autentica, así que restaurar el ERP antes de que el directorio sea confiable solo empuja el problema unas horas hacia adelante.
Reconstruye en un entorno limpio y restaura los datos ahí. Restaurar un sistema comprometido en su lugar original preserva cualquier persistencia instalada junto con el ransomware, que es precisamente el propósito del bróker de acceso.
Horas | Qué estás haciendo | Qué suelen haber hecho ya | La decisión sobre la mesa |
|---|---|---|---|
0 a 1 | Confirmar que es ransomware y delimitar el alcance del impacto | Mantuvieron el acceso durante alrededor de dos semanas | ¿Declaramos un incidente? |
1 a 2 | Aislar endpoints, cerrar el acceso remoto | Terminaron de cifrar lo que tenían planeado | ¿Qué sacamos de línea, y quién lo aprueba? |
2 a 4 | Rastrear el volumen y los destinos salientes | Exfiltraron datos, a menudo a pocas horas de entrar | ¿A quién se le notifica, y cuándo empieza el reloj? |
4 a 8 | Informar a legal, seguros y al equipo ejecutivo | Fijaron un plazo de pago en la nota | ¿Entablamos contacto con ellos o no? |
8 a 16 | Responder la causa raíz y el alcance de las credenciales | Dejaron persistencia para una visita de regreso | ¿Ya podemos reconstruir, o seguimos adivinando? |
16 a 24 | Levantar una identidad limpia, restaurar en orden de prioridad | Esperando a ver si reconstruyes sobre su punto de apoyo | ¿Qué necesita realmente primero el negocio? |
Nada de lo que aparece en esa tabla está terminado a la hora 24. Lo que termina es la fase en la que toda decisión todavía es reversible.
Qué distingue a los equipos que logran superar el primer día
Las organizaciones que salen intactas de un primer día rara vez se mueven más rápido en el momento. Llegan con menos preguntas abiertas.
Su restauración de backup se probó este trimestre, así que el tiempo de recuperación que le dan a la junta directiva es una medición. Su autoridad de decisión sobre el rescate está nombrada en un documento que alguien ha leído. Sus equipos de respuesta cubren las horas en que estas llamadas realmente llegan, es decir, el viernes por la noche y la primera mañana de un día feriado.
La empresa avícola mencionada antes terminó su incidente con cero rescate pagado, según el informe de UnderDefense sobre la intervención, y después reemplazó más de 900 reglas de detección ruidosas por más de 100 escritas específicamente para su propio entorno. Esa segunda parte es la que yo copiaría.
Elige una de estas opciones y hazla esta semana:
Restaura un archivo desde tu backup más reciente y mide el tiempo.
Escribe tres nombres y tres suplentes en la sección de decisiones de tu plan de respuesta a incidentes.
Verifica si hoy cada ruta de acceso remoto a tu entorno aplica autenticación multifactor.
Haz el simulacro de mesa un viernes a las 17:00, con las personas que realmente estarían en esa llamada, y observa qué suposiciones sobreviven el contacto.
Preguntas frecuentes
¿Deberías apagar una máquina que está cifrando archivos activamente?
Solo cuando no tengas una forma más rápida de detenerlo. Apagarla destruye la memoria, que con frecuencia contiene el proceso inyectado, las herramientas del operador y, en ocasiones, material clave que un equipo de respuesta podría haber recuperado. El aislamiento de red desde una consola de EDR detiene la propagación mientras lo preserva todo. Desconecta el cable solo si no hay un agente en el endpoint y puedes acceder a él en persona.
¿Cómo determinas si se robaron datos además de cifrarlos?
Busca volumen e intenta identificar el destino de salida antes de buscar malware. Las herramientas de transferencia mencionadas en el aviso de Akira de CISA de noviembre de 2025 (RClone, WinSCP, FileZilla, Mega, Ngrok) son software legítimo que alguien en tu entorno tiene una razón para usar, así que tu señal es un endpoint enviando un volumen inusual a un endpoint inusual en una hora inusual. La ausencia de pruebas no es prueba de ausencia, y tu asesoría legal lo tratará así.
¿Cuándo deberías contratar a un equipo externo de respuesta a incidentes?
Antes de necesitarlo. Un contrato firmado durante un incidente te cuesta horas de adquisición y revisión contractual, y esas son las horas en que las decisiones de contención todavía son económicas. Si no tienes un contrato y hay un incidente activo, llama en cuanto confirmes que es ransomware. Esperar hasta que tu propio equipo se quede sin opciones gasta las horas que más importan.
¿Pagar el rescate acorta las primeras 24 horas?
No. Las herramientas de descifrado que proporciona un atacante suelen ser lentas e incompletas, y no hacen nada respecto a la persistencia, las credenciales robadas o los datos exfiltrados. El pago es una decisión comercial y legal separada con exposición a sanciones, y debe tomarla gente designada conforme a una política escrita con anticipación.
¿Cuál es la única cosa más útil para preparar antes de un incidente?
Una restauración probada. Todo en las primeras 24 horas depende de si tu tiempo de recuperación es una medición o una esperanza, y un backup del que nadie ha restaurado es lo segundo. En segundo lugar está escribir nombres en los puntos de decisión de tu plan de respuesta a incidentes, porque una decisión sin asignar es la forma más confiable de perder cuatro horas.
Nazar Tymoshyk fundó UnderDefense en 2017 y la dirige como CEO. La empresa gestiona operaciones de seguridad, respuesta a incidentes y pruebas ofensivas para clientes en EE. UU. y Europa.