

Escalar el análisis de datos para cumplir con las exigencias de una empresa en rápido crecimiento es un desafío abrumador. Esta publicación de blog detalla el recorrido de Huntress al enfrentar este mismo dilema.
Sigue leyendo para descubrir cómo transformamos el análisis de datos y análisis de registros de Huntress al migrar a un motor de detección personalizado, aprovechando OpenSearch alojado por AWS.
El problema
En Huntress, recopilamos, analizamos y almacenamos los registros de cada endpoint monitoreado utilizando un único pipeline, pero paralelizado, dentro de una aplicación monolítica. Con esta configuración, podemos ofrecer una garantía de "al menos una vez" y acceder fácilmente a contexto adicional para enriquecer los datos recopilados.
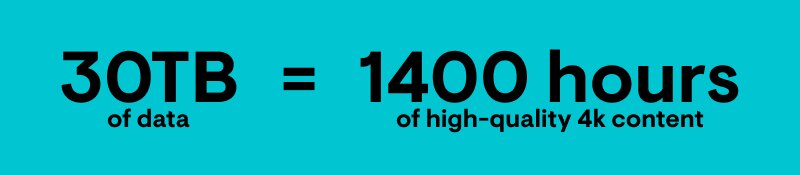
Sin embargo, a medida que hemos crecido como empresa, el sistema ha enfrentado algunos dolores de crecimiento en forma de problemas de escalabilidad, y algunos componentes se han vuelto prohibitivos en costo. Para efectos de este ejemplo, supongamos que estos datos equivalen a aproximadamente 900 TB al mes, o aproximadamente 30 TB al día, en nuestros más de dos millones de endpoints. Para dar contexto, 30 TB equivale a alrededor de 1.400 horas de contenido 4k de alta calidad.
Eso es una CANTIDAD enorme de datos. Entonces, ¿cómo analiza Huntress todo esto?
Soluciones iniciales
Como la mayoría de las empresas de detección y respuesta para endpoints (EDR), utilizamos un agente instalable para la recopilación de datos. Nuestro agente es muy liviano; solo le permitimos recopilar los datos necesarios y luego subirlos a S3. Estos archivos subidos se denominan "surveys". Contienen todos los datos nuevos recopilados desde la última verificación. Luego, una tarea en segundo plano recupera estos archivos de survey e inicia el trabajo de procesamiento. El trabajo de procesamiento convierte el archivo de survey único en un flujo de documentos. Después, enriquece los documentos y almacena los campos clave en nuestra base de datos relacional antes de enviarlos a Elasticsearch. Los datos dentro del archivo de survey siguen aproximadamente el formato Elastic Common Schema para eliminar la necesidad de transformarlos antes de la indexación en Elasticsearch.
Una vez que los documentos están en Elasticsearch, quedan disponibles para otras herramientas dentro del Elastic Stack y para los analistas de nuestro Centro de operaciones de seguridad (SOC). Esta interoperabilidad nos permite utilizar la aplicación Security dentro de Kibana para ejecutar las reglas de detección. Estas reglas se escriben en formato Sigma y luego se convierten a un formato que la aplicación Security puede entender. La aplicación Security ejecutará las reglas con regularidad según nuestra confianza en que la regla solo detectará comportamiento malicioso. Cuanto mayor sea nuestra confianza en la regla, con más frecuencia se ejecuta. Cuando un documento coincide con una regla, se crea un nuevo documento. A este nuevo documento lo llamamos señal. Esta señal contiene el documento original y se enriquece con información sobre la regla que coincidió. Esta señal se almacena en Elasticsearch y se envía a nuestro portal huntress.io.
Una vez que la señal se almacena en la base de datos del portal, nuestros analistas del SOC pueden comenzar sus investigaciones. Durante su investigación, los analistas pueden volver a Elasticsearch para encontrar contexto adicional o para buscar actividad similar en otros endpoints.
¿Por qué resolvimos nuestro problema de análisis de esta manera? Principalmente, nos alineamos con nuestro ciclo virtuoso al implementar una solución que escalara con nuestras metas a corto plazo y que ofreciera un valor desproporcionado. En ese momento, teníamos menos de un millón de agentes y operábamos con un equipo de ingeniería pequeño. Pero los tiempos han cambiado…
Dolores de crecimiento
Somos una empresa mucho más grande y nuestra base de instalaciones se ha más que duplicado, así que, naturalmente, experimentamos algunos dolores de crecimiento. En primer lugar, la app de seguridad es inherentemente retrospectiva. Los documentos debían indexarse antes de poder compararse con nuestro motor de detección. En el mejor de los casos, podíamos detectar una señal un minuto después de que se enviara a Elasticsearch. Pero en el peor de los casos, podía tardar varias horas. Todo dependía de con qué frecuencia se ejecutaban las reglas de detección. Para empeorar el diseño de la app de seguridad, esta limita los resultados de las reglas a los primeros 100 documentos coincidentes, limitando la salida de una sola ejecución a 100 señales. En algunas de nuestras reglas de menor fidelidad, siempre alcanzábamos este límite. Esto nos impedía combinar esas reglas de baja fidelidad para producir una señal de alta fidelidad.
El siguiente problema que descubrimos tenía responsabilidad compartida. Cuando Elastic necesita completar mantenimiento en el componente Elasticsearch de su oferta, retiran el nodo afectado de nuestro clúster y nos entregan uno nuevo. Esta acción no sería un gran problema para clientes con redundancia en sus datos. El servicio de Elasticsearch detectaría que se eliminó un nodo y usaría la segunda copia de cualquier dato faltante para recrearlo. Sin embargo, nosotros no manteníamos copias de réplica de nuestros datos. Cuando perdíamos el nodo, perdíamos los datos contenidos en él. Esto también causaba problemas de indexación intermitentes. Corregir este problema significó que tuvimos que duplicar la cantidad de nodos.
El problema final y más crucial con esta configuración fue el costo general. Varios factores contribuyen al costo del servicio. Cuando duplicamos la cantidad de nodos para dar redundancia, también duplicamos el costo. Además, Elastic no permite que los clientes personalicen los nodos según su caso de uso. Ofrecen personalización de alto nivel según el tipo de carga de trabajo, lo que modifica las proporciones de almacenamiento a RAM. Pero es imposible, por ejemplo, agregar almacenamiento adicional a nodos existentes.
Para empeorar las cosas, los clientes que implementan en múltiples zonas de disponibilidad, como lo hace Huntress, deben agregar nodos a cada zona de disponibilidad de forma proporcional. Finalmente, el proveedor de alojamiento de Elastic, AWS, les cobra por la comunicación entre zonas de disponibilidad. Elastic añade un recargo a ese costo y lo traslada al cliente. Con nuestro volumen de datos, un tercio de nuestro costo mensual se destinaba a la transferencia de datos.
Buscando otras soluciones
Hacia finales de 2022, exploramos arquitecturas alternativas para resolver nuestro problema de análisis. Exploramos alojar nosotros mismos todos los componentes del Elastic Stack. Exploramos implementar una cola de mensajes entre el portal y Elasticsearch, lo que nos permitiría ir enviando eventos de a poco durante el día. Finalmente, exploramos soluciones de registro alternativas; sin embargo, ninguna se ajustaba lo suficientemente bien como para reemplazar lo que ya teníamos.
Finalmente, optamos por escribir un motor de detección personalizado para la generación de señales y utilizar OpenSearch alojado por AWS para el componente de búsqueda.
Este nuevo diseño modifica el flujo de documentos después de almacenar los campos clave en nuestra base de datos relacional. Además de enviar los documentos al nuevo clúster de OpenSearch, los enviamos a un flujo de eventos donde múltiples instancias del motor de detección los leen. Al dividir el flujo de documentos y duplicarlos, conservamos la capacidad de que nuestros analistas del SOC y de amenazas busquen en nuestros datos con una interfaz conocida, a la vez que mejoramos nuestras capacidades de detección presentes y futuras.
Reflexiones finales
Al diseñar nuestro motor de detección, eliminamos todos los problemas que tuvimos con la aplicación Kibana Security. Mantuvimos la garantía de "al menos una vez" al implementar un sistema de cola de mensajes entre el portal y el motor de detección. Esto también significa que procesamos los datos como un flujo continuo, eliminando el retraso que introducía la programación de consultas y el límite de 100 resultados.
El servicio de OpenSearch alojado nos permite reducir costos al disminuir los costos de transferencia de datos y ofrecer configuraciones de nodos personalizables. A diferencia de Elastic, AWS no cobra por la transferencia entre zonas de disponibilidad cuando OpenSearch se implementa con su servicio alojado. También permite a los clientes personalizar el tamaño del almacenamiento en bloque conectado a cada nodo. Esto nos permitió reducir la cantidad de nodos mientras mantenemos el mismo período de retención.
Es muy probable que esta no sea la versión final de nuestro flujo de análisis. A medida que Huntress sigue creciendo, también lo harán nuestras capacidades para atender a nuestros clientes y proteger a las pequeñas y medianas empresas que más lo necesitan.
¿Quieres ver el motor de detección de Huntress en acción? Agenda una demo personalizada para ver cómo funciona Huntress por dentro.