

La demanda de NYT contra OpenAI ha llamado mucho la atención, y una reciente orden judicial ha sacudido al mundo tecnológico. El 13 de mayo de 2025, la jueza magistrada Ona T. Wang, del Distrito Sur de Nueva York, emitió una orden que obliga a OpenAI a "preservar y segregar todos los registros de salida que de otro modo se eliminarían, de ahora en adelante hasta que el tribunal dicte otra orden". Este fallo ha generado preguntas no solo sobre privacidad de los datos, sino también sobre el futuro de la ciberseguridad en la era de la IA.
No hace falta decir que OpenAI reaccionó con un rotundo "de ninguna manera" y apeló de inmediato el fallo. El director ejecutivo Sam Altman también se pronunció en redes sociales, diciendo que la decisión de la jueza compromete la privacidad de los usuarios y "sienta un mal precedente". En este blog, analizaremos los hechos que dieron origen al caso judicial y las implicaciones más amplias de la orden de la jueza Wang para la ciberseguridad y la privacidad de los datos.
NYT contra OpenAI: qué ha pasado con la demanda contra OpenAI
La orden judicial ha desatado debates a nivel mundial, especialmente porque surgió de una batalla legal que comenzó con la demanda por infracción de derechos de autor del New York Times presentada en diciembre de 2023. Los desarrolladores de OpenAI usaron millones de fuentes de todo internet para entrenar su modelo de lenguaje de gran escala. El NYT afirmó que OpenAI se apoyó fuertemente en su contenido—artículos de noticias, editoriales y columnas de opinión—la asombrosa cifra de 66 millones de piezas de contenido usadas sin permiso.
La demanda alegó que, al usar "casi un siglo de contenido protegido por derechos de autor", OpenAI causó un "daño significativo" a los resultados financieros del Times. La demanda también afirma que los productos de OpenAI y Microsoft pueden "generar resultados que repiten contenido del Times textualmente, lo resumen de cerca e imitan su estilo expresivo".
Las preocupaciones de privacidad de OpenAI bajo la lupa
La orden de preservación de la jueza Wang es un momento clave en el caso. Esta refleja la necesidad del NYT de rastrear cómo se usa su propiedad intelectual, en particular cuando están involucrados los datos de las interacciones de los usuarios. Esto incluye registros que de otro modo se eliminarían a solicitud del usuario (vaya cosa). Sin embargo, OpenAI se ha opuesto firmemente.
El director de operaciones de OpenAI, Brad Lightcap, dijo que "esto entra fundamentalmente en conflicto con los compromisos de privacidad que hemos asumido con nuestros usuarios. Abandona normas de privacidad establecidas desde hace mucho tiempo y debilita las protecciones de privacidad".
Su equipo legal ya ha presentado una apelación contra este fallo, argumentando que la solicitud de conservar los datos de ChatGPT de forma indefinida viola los estándares de privacidad y representa riesgos innecesarios para la privacidad de los usuarios.
La tecnología de IA llevada a juicio
El caso del NYT es solo uno entre docenas de casos legales relacionados con la IA que están en curso o que se han resuelto recientemente. Es probable que cada uno de ellos desempeñe un papel en la configuración del panorama de la IA de aquí en adelante, especialmente en cuanto a la privacidad de los datos y la ciberseguridad.
Por ejemplo, el mes pasado, en el caso Walters contra OpenAI , el Tribunal Superior del Condado de Gwinnett, Georgia, emitió un fallo que otorgó un juicio sumario a favor de OpenAI, desestimando la demanda del locutor de radio Mark Walters, quien alegaba que ChatGPT lo difamó al sugerir que era un malversador de fondos. Ese fallo sienta un precedente importante que influirá en cómo los desarrolladores de IA, los profesionales del derecho y los tecnólogos abordan la intersección entre la tecnología emergente y el derecho de responsabilidad civil tradicional.
Es probable que la orden de la jueza Wang tenga repercusiones igualmente enormes en cuanto a la privacidad de los datos en la era de la IA, especialmente considerando la visión de Sam Altman, director ejecutivo de OpenAI, de un modelo de IA que conoce toda tu vida y usa ese conocimiento para generar respuestas personalizadas.
¿El nuevo Google?
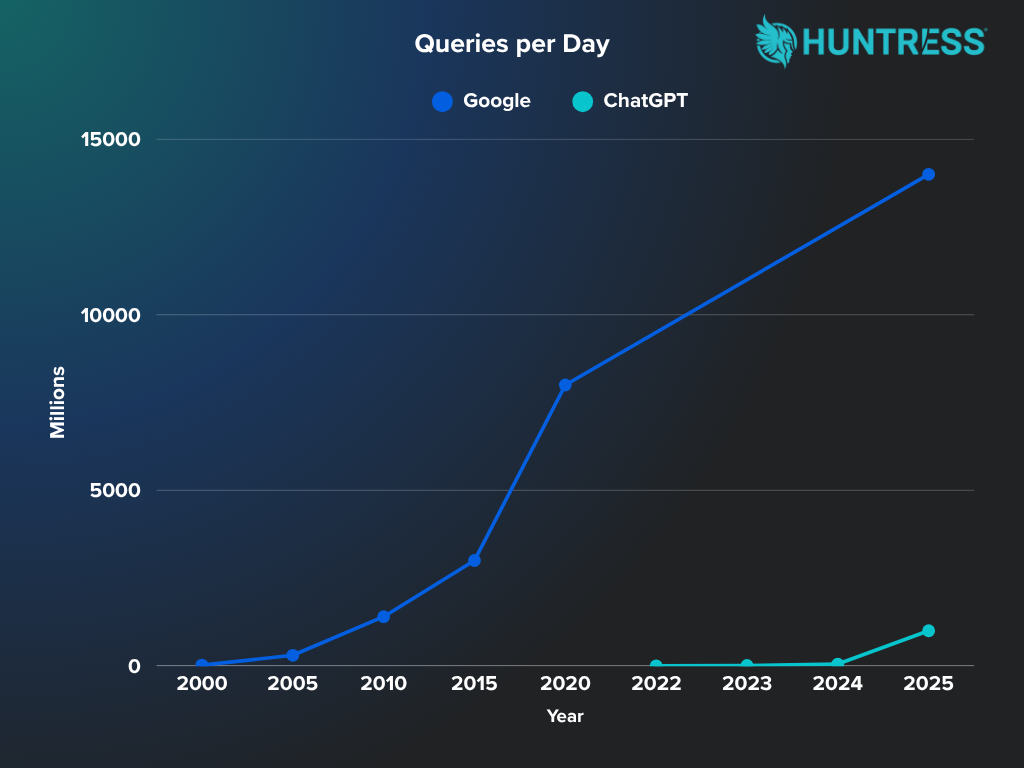
El caso del NYT no es lo único que genera revuelo en torno a OpenAI. En un artículo reciente, PhoneArena planteó que ChatGPT "podría ser el futuro de la búsqueda", pero agregó que todavía "le falta mucho para superar a Google". Sin embargo, un vistazo a los datos sugiere que se está convirtiendo en la herramienta de búsqueda preferida para un número creciente de personas. ChatGPT actualmente maneja más de mil millones de consultas por día. Y esa cifra sigue en constante aumento.
El siguiente gráfico muestra lo rápido que ha crecido su volumen de búsquedas. De millones por día cuando se lanzó a fines de 2022, ha subido a más de mil millones de consultas por día en menos de dos años. Estas cifras son diminutas comparadas con Google, que actualmente maneja alrededor de 14 mil millones de búsquedas al día. Sin embargo, a Google le tomó 27 años llegar hasta ahí.
Fuentes: searchengineland.com, ucaststudios.com, digitalinformationworld.com, ft.com, similarweb.com, reuters.com
Las cosas se ponen interesantes cuando comparamos el uso de ChatGPT con los patrones de uso de Google cuando se lanzó por primera vez. Durante sus primeros dos años, Google vio cómo su volumen de búsquedas aumentó de alrededor de
18.000 por día a alrededor de dos millones. Por supuesto, el mundo de la búsqueda en línea es un lugar muy diferente en estos últimos cinco años comparado con principios de la década de 2000, pero la rápida adopción de ChatGPT plantea
preguntas importantes sobre el papel de la IA en nuestro futuro.
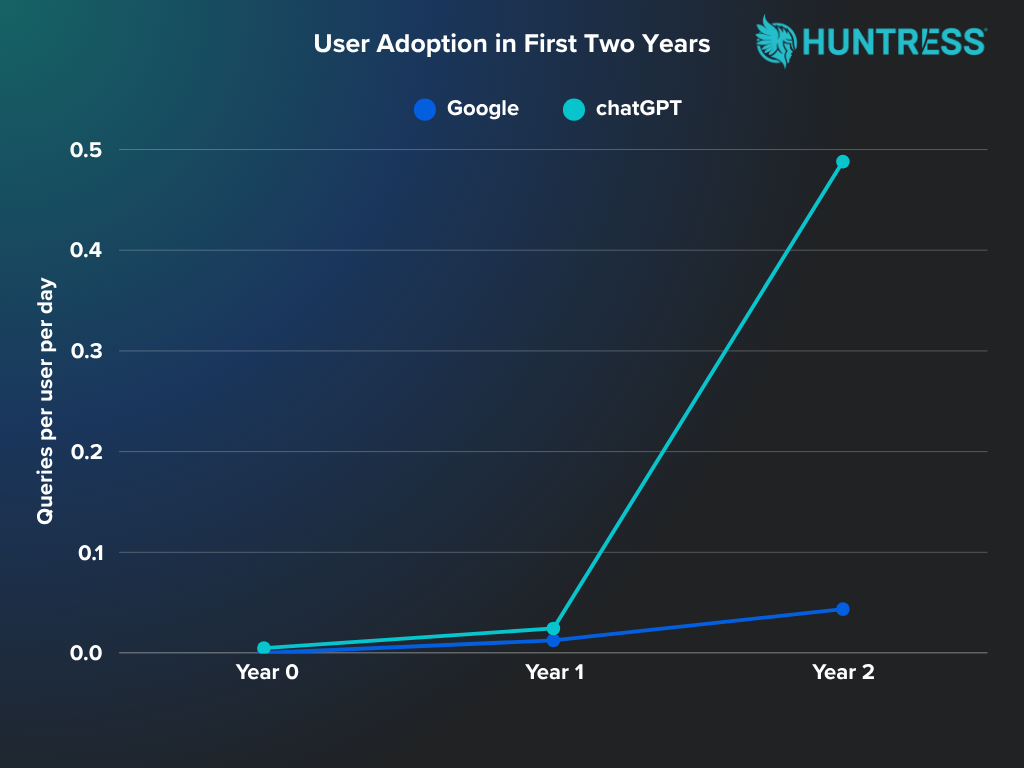
Fuentes: searchengineland.com, ucaststudios.com, digitalinformationworld.com, ft.com, similarweb.com, reuters.com
Cuando Google se lanzó en 1998, la adopción fue muy lenta: la tasa de 0,00005 consultas por usuario al día indica una actividad de búsqueda prácticamente nula. Compara esto con el uso de ChatGPT de alrededor de 0,005 consultas
por usuario al día, lo cual es cientos de veces mayor. Tanto Google como ChatGPT tuvieron un aumento pronunciado después de su primer año, pero de nuevo, el de ChatGPT fue casi el doble que el de Google. Hoy, ChatGPT está
a mitad de su tercer año, y su actividad de consultas por usuario es más de diez veces la de Google en la misma etapa.
Esta comparación muestra que la actividad de ChatGPT por usuario de internet ha sido dramáticamente más alta en cada etapa. A simple vista, eso sugiere un compromiso explosivo y casi instantáneo. Sin embargo, aunque dividir simplemente las búsquedas entre el total de usuarios de internet sugiere adopción, solo cuenta la mitad de la historia. Ten en cuenta que Google todavía tiene alrededor de 15 veces más búsquedas al día que ChatGPT. Google sigue siendo el recurso preferido para búsquedas casuales, y es poco probable que ese equilibrio de poder cambie mientras sigan existiendo tantas dudas en la mente de las personas en torno a la IA.
Una cuestión de confianza
Incluso antes de que se emitiera la orden judicial el mes pasado, la confianza en los países occidentales era baja en cuanto a herramientas de IA como ChatGPT. El Edelman Trust Barometer 2025 muestra que solo el 32 % de los estadounidenses confía en la IA. Esto se respalda con una encuesta de Deloitte de diciembre de 2024, que mostró que un asombroso 90 % de las personas quiere que las empresas hagan más para proteger sus datos personales.
Dray Agha, Security Operations Manager at Huntress, destaca la falta de conciencia entre los usuarios sobre la configuración de privacidad de los datos: "La política de privacidad de OpenAI establece que el contenido que envías puede usarse para mejorar sus modelos a menos que lo desactives en la configuración. Los usuarios pueden deshabilitar el historial de chat o solicitar exclusión del entrenamiento, pero la mayoría no se da cuenta de que deben tomar esos pasos".
El fallo del tribunal en Nueva York solo hará que los usuarios sean más reacios a usar ChatGPT y herramientas similares si creen que sus preguntas quedarán registradas, especialmente si no tienen forma de exigir que sus datos sean eliminados.
Dicho esto, estas preocupaciones son mucho mayores en EE. UU. y Europa que en el resto del mundo. Las leyes de privacidad de los datos son más estrictas en muchas naciones occidentales, y el público está cada vez más receloso del control que las empresas tecnológicas tienen sobre sus datos. El siguiente gráfico muestra cuánto varían los niveles de confianza en distintos países.
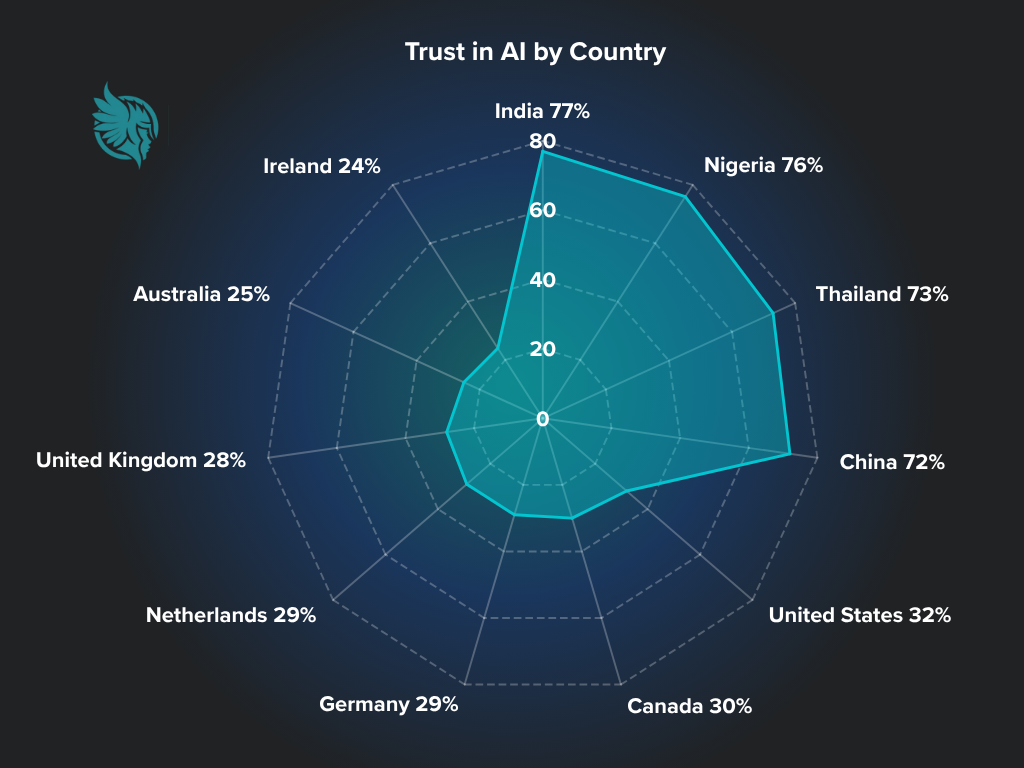
Podríamos pasar una semana discutiendo las posibles implicaciones de estas estadísticas.
Esa es una conversación para otro día, pero en resumen, sugiere que en muchas economías emergentes, la IA se ve como una herramienta de progreso y se vincula con el crecimiento en sectores como la salud, la educación,
y los servicios públicos. Países como China también muestran más confianza, con
un fuerte respaldo gubernamental. Mientras tanto, otros países son más escépticos y están interesados
en priorizar la ética de la IA, las amenazas de ciberseguridad, y la privacidad de los datos por encima de necesidades básicas como la salud y
la educación. Veamos por qué esto importa.
La IA explicable y su implementación ética como camino hacia la confianza
La IA explicable es un conjunto de procesos y métodos que permiten a los usuarios humanos comprender y confiar en los resultados y productos generados por los algoritmos de aprendizaje automático. La IA explicable describe un modelo de IA, su impacto esperado y sus posibles sesgos. El concepto está ganando terreno como requisito fundamental para mantener una implementación de IA legal y ética.
El fallo del tribunal de Nueva York insiste en un grado de transparencia que permita a los usuarios y reguladores entender cómo se toman las decisiones en sistemas de IA generativa como ChatGPT. Esto es lo que significa en la práctica:
- Documentación del modelo: descripciones detalladas de las fuentes de datos de entrenamiento, la arquitectura del modelo y los procesos de ajuste fino.
- Trazabilidad de decisiones: la capacidad de rastrear los resultados hasta las entradas o los datos de origen cuando sea posible.
- Human-in-the-Loop (HITL): incorporar supervisión humana en casos de uso sensibles para mejorar la rendición de cuentas.
La explicabilidad no solo ayuda a cumplir con la orden del juez Wang. También fortalecerá la confianza pública en general, especialmente en los mercados y países donde más falta hace.
Ciberseguridad en la era de la IA generativa
Un informe reciente de la National Cybersecurity Alliance (NCA) mostró que alrededor de dos tercios de los estadounidenses están preocupados por el cibercrimen, y alrededor de un tercio ha sido víctima. Es una historia similar en el Reino Unido, donde el 50 por ciento de los mayores de 65 años piensa que el cibercrimen es un riesgo mayor que la agresión física.
La IA generativa introduce todo un nuevo conjunto de riesgos de ciberseguridad, como:
- Ataques de inyección de prompts: los usuarios maliciosos pueden manipular las respuestas de la IA creando cuidadosamente entradas que desencadenan salidas inesperadas o dañinas.
- Ataques de inversión de modelo: los adversarios pueden extraer datos confidenciales usados durante el entrenamiento del modelo al sondear sus salidas.
- Envenenamiento de datos: corromper los datos de entrenamiento para influir en el comportamiento de la IA de maneras sutiles o abiertamente dañinas.
La directiva del tribunal refuerza la urgencia de que las empresas construyan defensas sólidas contra estas amenazas de ciberseguridad emergentes. Es probable que estas incluyan medidas como monitoreo continuo, pruebas de equipo rojo sobre las salidas de la IA, e integración de prácticas de ciclo de vida de desarrollo de software seguro (SDLC) diseñadas específicamente para la IA.
La cuestión de la privacidad de los datos
Uno de los temas más controvertidos en torno a la IA generativa es la privacidad, y este es, por supuesto, la implicación más importante de la orden judicial. Por su propia naturaleza, los modelos de aprendizaje automático requieren conjuntos de datos enormes para funcionar eficazmente, y estos conjuntos de datos pueden incluir inadvertidamente información personal, confidencial o de propiedad exclusiva.
"Una foto de tu rostro puede considerarse datos biométricos, según leyes como el GDPR, y subirla a un servicio de IA puede significar que renuncias al control sobre cómo se usa", advierte Dray Agha, destacando cómo interacciones aparentemente inofensivas con sistemas de IA pueden generar problemas de privacidad.
El fallo del tribunal ofrece cierto alivio en esta área, ya que subraya la necesidad de:
- Minimización de datos: recolectar solo lo necesario y anonimizarlo rigurosamente.
- Gestión del consentimiento: informar claramente a los usuarios cómo se usan sus datos, incluyendo cuándo podrían usarse con fines de entrenamiento.
- Control del usuario: ofrecer mecanismos para que los usuarios accedan, corrijan o eliminen sus datos, en línea con los principios del GDPR.
Fundamentalmente, la orden judicial exige lograr estos objetivos sin comprometer el rendimiento del modelo ni la experiencia del usuario. Sin embargo, esto presenta desafíos para lograr tanto el cumplimiento legal como la viabilidad técnica. Veremos esto con más detalle a continuación, pero para muchos, no aborda el verdadero problema de fondo: la retención de las búsquedas y el historial de conversaciones de los usuarios.
Con la orden judicial que exige a OpenAI preservar indefinidamente las interacciones de los usuarios, incluso las eliminadas por ellos, muchos temen que las consultas, que pueden contener información personal, relacionada con la salud, legal o financiera, puedan almacenarse y potencialmente ser utilizadas como parte de procesos legales. Esto trae más desafíos relacionados con las expectativas de confidencialidad y el comportamiento efímero de búsqueda que muchos usuarios asocian con los asistentes de IA. También eleva los riesgos relacionados con el cifrado, el almacenamiento y el control de acceso de las consultas de búsqueda.
Encontrar el equilibrio entre la innovación en IA y las leyes de privacidad
La demanda contra OpenAI pone en el centro de atención los desafíos de navegar regulaciones de privacidad como las de EE. UU. y Europa/Reino Unido mientras se avanza con la innovación en IA. Por ejemplo, las leyes de privacidad en EE. UU. cubren derechos del consumidor como el acceso a los datos, su eliminación y la transparencia. Pero estos principios a menudo entran en conflicto con las amplias necesidades de datos de la IA generativa.
Navegar este panorama es un poco como caminar por una cuerda floja. Las organizaciones deben implementar y gestionar las siguientes medidas:
- Aprendizaje federado y privacidad diferencial: estas técnicas permiten que los modelos aprendan de los datos sin centralizarlos, reduciendo la exposición a infracciones regulatorias.
- Principios de privacidad desde el diseño: las consideraciones de privacidad deben incorporarse en cada etapa del desarrollo del modelo.
- Marcos de gobernanza de datos: las políticas claras sobre recolección, retención y uso de datos son esenciales tanto para el cumplimiento como para la excelencia operativa.
La orden judicial ha motivado a las organizaciones a armonizar la innovación en IA con los derechos de privacidad y las obligaciones legales.
Cumplir con las expectativas cambiantes de los consumidores
A medida que los consumidores se vuelven más conscientes de cómo se usan sus datos, empresas como OpenAI deben evolucionar para cumplir con estas expectativas. El fallo judicial subraya la creciente necesidad de una comunicación clara sobre las prácticas de datos y el uso ético de la IA. La respuesta de OpenAI subraya su compromiso con la transparencia: “Compartiremos actualizaciones significativas, incluyendo cualquier cambio en la orden o en cómo afecta tus datos”.
Los proveedores de servicios pueden estar mejor preparados para cumplir con las expectativas cambiantes de los consumidores de varias maneras, incluyendo las siguientes:
- Mejorar la comunicación con explicaciones en lenguaje sencillo tanto de la funcionalidad de su IA como de sus prácticas de datos.
- Mejorar las interfaces de usuario haciendo que los controles de privacidad sean accesibles y comprensibles
- Demostrar una gestión ética yendo más allá del cumplimiento regulatorio básico y defendiendo activamente los derechos de los usuarios y el uso ético de la IA.
Las empresas que logren esto mejor y más rápido harán más que simplemente reducir sus riesgos legales. También verán una ventaja competitiva al satisfacer a los clientes y ganar lealtad a la marca.
Navegar la intersección entre la IA, la privacidad y la ciberseguridad
La demanda contra OpenAI y la orden de preservación ponen un foco grande y brillante sobre el conflicto creciente entre la privacidad de los datos y el crecimiento a velocidad vertiginosa de la tecnología de IA. Mientras OpenAI apela el fallo, el resultado podría sentar precedentes significativos sobre cómo los desarrolladores de IA manejan los datos de los usuarios en el futuro. A medida que la IA sigue transformando industrias, las empresas deben equilibrar la innovación con la confianza del usuario. El desafío está en encontrar la manera de proteger la privacidad y, a la vez, dejar que la IA generativa haga lo suyo. Es una línea delgada, pero debemos caminarla si queremos ver todo el potencial de la IA.