


TL;DR: Cuando Huntress probó Claude Fable 5.1 de Anthropic en evaluaciones, comenzamos con una línea base de ~48% de precisión para recall de API: significativamente más que los modelos anteriores, pero aún bastante bajo. Con tres pequeños cambios en nuestros arneses de codificación, logramos 100% de precisión en siete de nuestras tareas de evaluación.
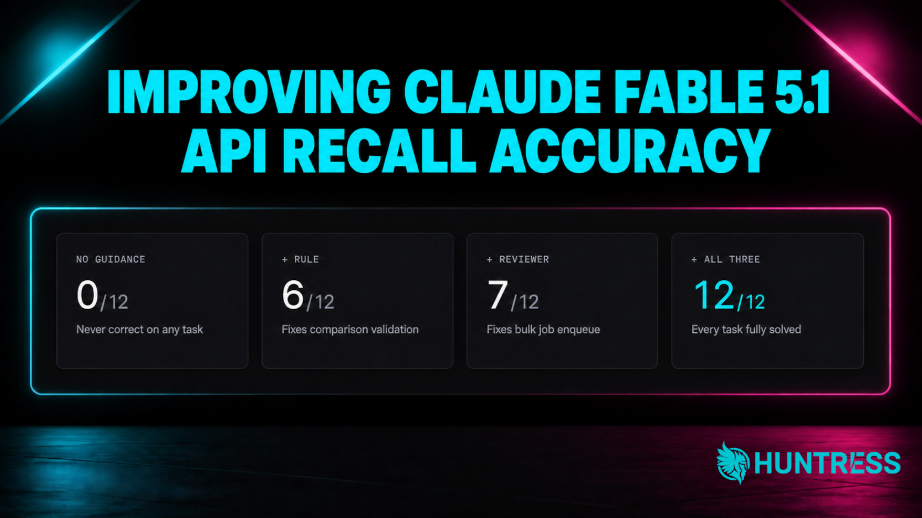
Agregar una regla corta a CLAUDE.md por sí sola lo llevó al 86%. Agregar una herramienta de búsqueda para las gemas de Ruby instaladas y hacer que un segundo modelo lea el diff antes de que el agente termine su trabajo cerró la brecha restante. Sigue leyendo para saber exactamente cómo logramos esto.
Agradecimientos: Gracias a Chris Benninger y Michael Coyne por sus aportes en este proyecto y en este artículo.
¿Cómo se ve el "AI slop" en las bases de código?
Pregúntale a la mayoría de los desarrolladores qué significa "AI slop" y una respuesta común es hacer a mano lo que el lenguaje de programación ya nos da gratis. Utilizar un callback y una llamada a SecureRandom donde has_secure_token serviría. Crear un bucle con perform_later donde existe perform_all_later. Un método de validación personalizado donde comparison: es una sola línea. Cada uno funciona, pasa las pruebas y agrega código que alguien ahora tiene que mantener para siempre.
En la segunda mitad de 2026, el equipo de Ruby on Rails comenzó a publicar Agents on Rails, un benchmark de cómo se desempeñan los agentes de codificación en trabajo real de Rails. Un número destacó como bastante malo: recall de API, es decir, si el agente usa la funcionalidad que Rails ya proporciona o escribe la suya propia. Encontraron un recall preciso de APIs del 41% para Claude Fable 5.1, la mejor puntuación hasta ahora entre los modelos de frontera y los principales. El Rails and AI leaderboard ubicó a Opus 5 en 34.9% y a Sonnet 5 en 25.4%.
Quería probar dos cosas:
¿Podemos determinar la precisión de recall de API en nuestra propia base de código?
Si podemos, ¿hay algo que podamos cambiar en cómo ejecutamos los agentes de codificación para mejorarlo?
Los resultados de estos experimentos pueden, con suerte, dar forma a un arnés de codificación agéntica compartido para nuestros ingenieros internos. Como mínimo, nos da un conjunto de prácticas compartidas que mantienen más fácil de mantener la base de código que estamos produciendo.
Los evals son cómo tomamos esa decisión basados en evidencia en lugar de anécdotas: ejecutamos muchos intentos en la misma tarea con el mismo calificador, mientras cambiamos una variable a la vez.
El arnés
Todo se ejecuta sobre rails/lemans, el arnés detrás del benchmark de Rails. Creamos un fork de este repositorio y agregamos algunos adaptadores personalizados. Un ensayo funciona así:
Un sandbox de Docker arranca desde un commit fijado de nuestra app con sus bases de datos en ejecución.
Una tarea de eval elimina una pieza de código en producción y le entrega al agente el ticket que llevó a que ese código se escribiera. La instrucción nunca nombra la funcionalidad específica de Rails que queremos que use la prueba.
El agente trabaja sin acceso a la red fuera de las llamadas al LLM y tiene un presupuesto de turnos y costo.
Un archivo RSpec oculto califica el resultado, junto con las especificaciones propias de la app y RuboCop sobre los archivos tocados.
Un calificador de recall lee el diff del agente en busca de la funcionalidad de Rails frente a las formas hechas a mano, y revisa la transcripción del LLM para ver si en algún momento identificó la funcionalidad deseada o abrió el código fuente de Rails como referencia para posibles soluciones.
Cada tarea de eval está construida a partir de código real. Tomamos un lugar donde alguien envió su propia versión de algo que Rails ya proporciona, eliminamos ese código y escribimos una historia/ticket que llevaría/debería llevar a que ese código se creara. Antes de aceptar una tarea, confirmamos contra el código fuente de la gema instalada que la funcionalidad de Rails realmente encaja, y que tanto la versión de Rails como la versión hecha a mano pasan la especificación oculta, para que el calificador mida la elección, no el resultado. Comenzamos con siete tareas de recall más una tarea de control.
Nuestra línea base inicial de recall de API: 48% (pero en realidad 83% y 0%)
Ejecutamos el agente en las siete tareas de eval sin ninguna guía. Usó la funcionalidad integrada de Rails en 10 de 21 ensayos, 48%, en el mismo rango que la cifra pública que encontraron los de Rails (41.3%). Esto reveló dos grupos distintos:
Funcionalidades que Claude ya conoce (
generates_token_for,normalizes): usó la funcionalidad integrada en 10 de 12 ensayos, 83%.Funcionalidades a las que Claude nunca recurrió (
perform_all_later,comparison:,has_secure_token): 0 de 9, 0%.
Las transcripciones de nuestros evals explican los ceros. También demuestra cómo el "slop" se acumula. Nuestro agente de codificación busca (grep) en la base de código, encuentra una versión hecha a mano del mismo patrón y la copia. Uno de nuestros generadores de tokens vive en varios modelos porque una persona lo escribió y dos pull requests asistidos por IA terminaron copiándolo. Nuestro benchmark de eval lo copió otra vez. Cada ayudante hecho a mano que se implementa se convierte en más precedente para que el siguiente agente de codificación lo imite.
Puede ser empoderador observar esta progresión controlada y rastreable. A través de la iteración, la experimentación y la comprensión, puedes empezar a ver niveles de mejora que separan el "vibe coding" de algo más maduro.
Tarea de ejemplo
Aquí hay una ilustración clara de cómo se ve una tarea de eval. La solicitud está simplificada y no es nuestro código de producción real, pero la forma es similar a lo que ejecutamos.
EL TICKET
Invitations are being created with no token, so the accept link renders empty. Restore it: a new invitation saved without a token gets a random, URL-safe one of at least 20 characters, a token supplied explicitly is kept, and clearing the token on an existing invitation is still invalid. No migration, and do not touch spec/.Precedente en la base de código
before_validation :generate_token, on: :create

def generate_token

  self.token ||= SecureRandom.base58(21)

end
Lo que queremos que nuestro agente de codificación use
has_secure_token :token, on: :initializeUna línea: has_secure_token genera un token Base58 de 24 caracteres, deja intacto un token proporcionado explícitamente, y con on: :initialize el token existe antes de que se ejecute la validación. Regenerar un token viene gratis como regenerate_token. La especificación oculta pasa de cualquier manera.
La especificación que usamos para calificar los resultados
El agente nunca ve este archivo de especificación. Se ejecuta después de que el agente termina, junto con las especificaciones propias de la app y RuboCop sobre los archivos tocados. Ambas versiones anteriores lo pasan, así que el calificador mide cuál eligió el agente.
RSpec.describe Invitation, type: :model do
   # Instantiated the way the signup flow does, with no token at all. Assigning nil to a
it "gets a URL-safe token of at least 20 characters when created without one" do
invitation = create_without_token
expect(invitation.reload.token).to match(/\A[A-Za-z0-9_-]{20,}\z/)
end
it "keeps a token that was supplied explicitly" do
invitation = create(:invitation, token: "supplied-token-1234567890")
expect(invitation.reload.token).to eq("supplied-token-1234567890")
end
it "gives two invitations different tokens" do
first = create_without_token
second = create_without_token
expect(first.token).not_to eq(second.token)
end
it "is found by the token the accept link carries" do
invitation = create_without_token
expect(Invitation.find_by(token: invitation.token)).to eq(invitation)
end
it "does not quietly regenerate a token cleared on an existing invitation" do
invitation = create(:invitation)
invitation.token = nil
expect(invitation).not_to be_valid
expect(invitation.errors[:token]).to include("can't be blank")
end
endTécnicas de recall de API que probamos
Técnica 1: una regla de cuatro líneas en CLAUDE.md
Lo primero que probamos fue una instrucción corta en el archivo de contexto del agente. La llamamos la regla de recall de API: una adición de cuatro líneas a CLAUDE.md diciéndole explícitamente a Claude Code lo siguiente:
Esto es Rails 8.1
Prefiere las APIs del framework
Verifica la gema instalada antes de escribir un ayudante
Explica en el PR si no encaja
Ejecutamos la regla junto con dos alternativas populares. Esto tuvo un par de resultados interesantes:
Sin guía: 48% (10 de 21 ensayos)
Regla de recall de API en
CLAUDE.md: 86% (18 de 21, p = 0.008, cero regresiones)La lista de verificación "Rails Way" de publicaciones de blog: 71% (no significativo, tres ensayos fallaron el linting)
Una habilidad opcional: 57% (la habilidad nunca se abrió en 27 ensayos)
CONDICIÓN | TASA DE ÉXITO | ENSAYOS | NOTAS |
|---|---|---|---|
Sin guía | 48% | 10 de 21 | Línea base |
Regla de recall de API en | 86% | 18 de 21 | Significativo (p = 0.008); cero regresiones |
Lista de verificación "Rails Way" de publicaciones de blog | 71% | — de 21 | No significativo; tres ensayos fallaron el linting |
Habilidad opcional | 57% | — de 27 | La habilidad nunca se abrió en ninguno de los 27 ensayos |
Dos cosas en esa lista nos sorprendieron. La lista de verificación popular (fijar la versión, leer primero db/schema.rb, preferir pluck) hizo que el agente fuera más rápido y peor; nunca ejecutó RuboCop y envió una infracción de formato autocorregible en tres soluciones que por lo demás eran correctas. Los elementos opcionales fueron ignorados. Una habilidad ubicada en .claude/skills con una descripción que nombraba la situación exacta nunca fue invocada por el agente de codificación (lamentablemente).
La regla de recall de API dejó la tarea de encolado masivo en cero: el agente nunca parece sospechar que perform_all_later existe, así que una regla sobre "asuntos del framework" nunca se activa. Una regla solo puede ayudar con el slop que el agente reconoce como slop.
Técnicas 2 y 3: una herramienta de búsqueda y un revisor al momento de detenerse
En la segunda ronda agregamos dos palancas más y probamos cada combinación de las tres, dándonos cuatro intentos cada una:
La regla de recall de API en
CLAUDE.mdUna herramienta de búsqueda, un script en el sandbox que busca en las gemas de Rails instaladas e imprime las opciones y el código fuente de un método, mencionado en
CLAUDE.mdUn revisor, un hook de Claude Code Stop después de que se escribe el código. Antes de que el agente termine, tenemos un segundo modelo que lee el diff y verifica el código fuente de la gema.
Cara a cara, emparejando cada ensayo contra la misma tarea e intento sin la palanca:
Regla de recall de API en
CLAUDE.md: 23 victorias, 1 derrota. Funciona.Revisor al momento de detenerse: 24 victorias, 0 derrotas. Funciona.
Herramienta de búsqueda: 6 victorias, 2 derrotas. Solo funciona cuando la regla hace que el agente la use.
El revisor fue un salto significativo comparado con las opciones de instrucción previa a la codificación. El encolado masivo pasó de 0 de 16 a 16 de 16. Esto probablemente se debe a que trabaja a partir del código terminado en lugar de la percepción del agente de lo que parece "nativo del framework". La herramienta de búsqueda lamentablemente nunca se ejecutó cuando estaba simplemente disponible, pero una vez bajo la regla, el agente la usó en cada ocasión, y leer la opción on: en has_secure_token llevó esa tarea de 2 de 4 a 4 de 4.
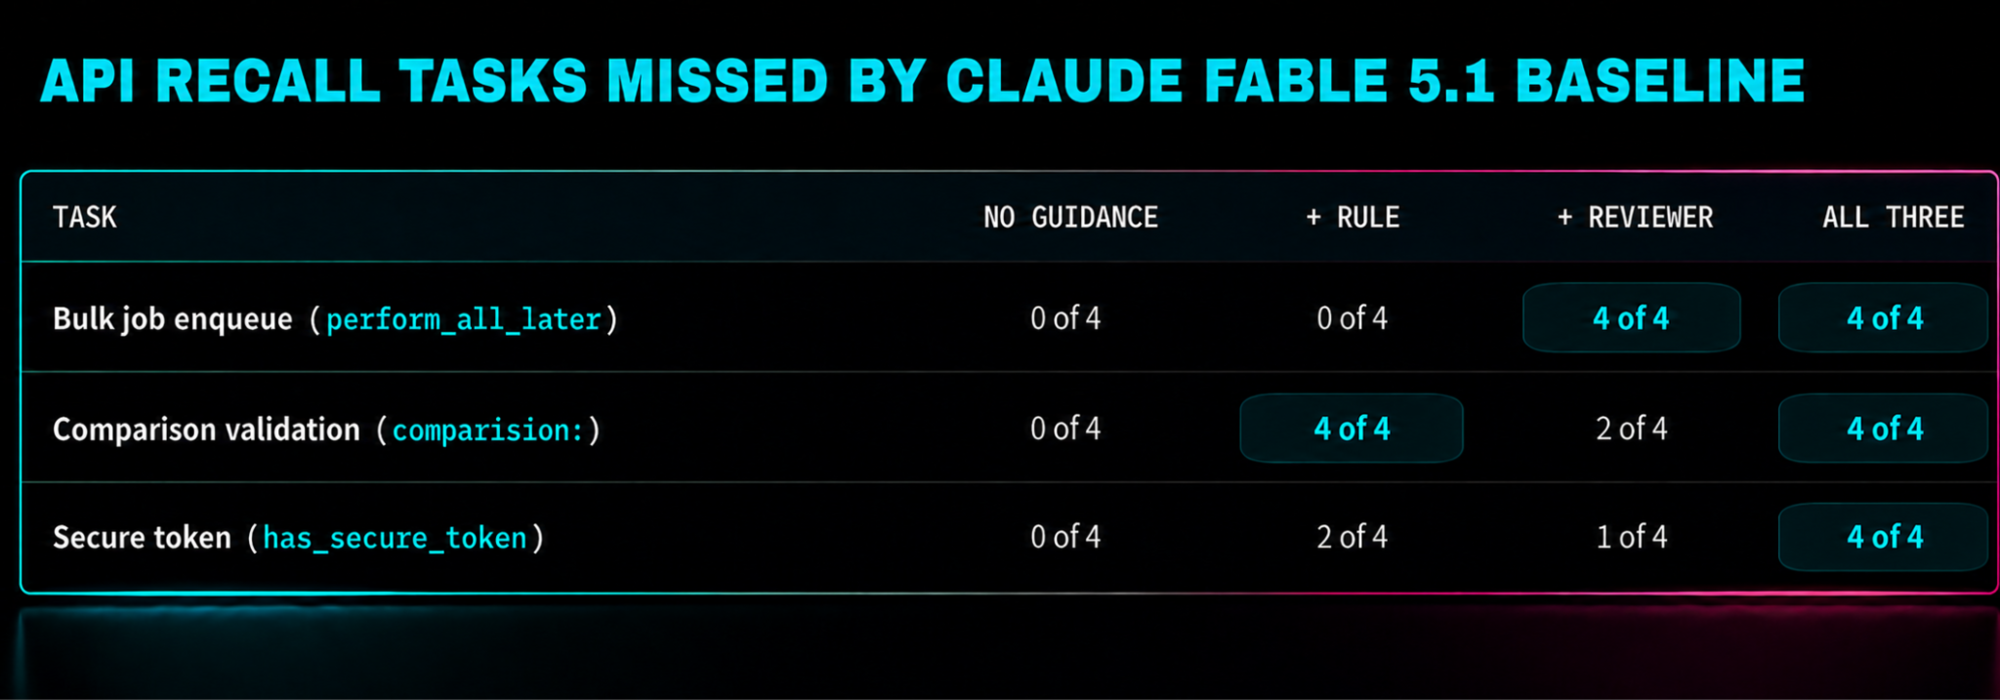
Las tres reglas juntas acertaron lo siguiente:
12 de 12 en las tres tareas que la línea base nunca acertó
16 de 16 en las cuatro que mayormente acertó
28 de 28 en las siete tareas, con todas las soluciones pasando, a aproximadamente 30 centavos más por tarea en Fable 5.1
Lo que esto implica para nuestro arnés de codificación
La regla de recall de API va en el CLAUDE.md de la app. El hook del revisor y la herramienta de búsqueda se implementan a través de algo como Claude Code. Eso deja al revisor como un modelo con una pregunta específica que responder después de que se produce el código.
Si te llevas una sola cosa de esto: la solución más económica es una regla que le diga al agente que revise la gema instalada antes de escribir un ayudante. Para detectar lo que la regla no puede, usa un segundo modelo para hacer una pregunta específica sobre el diff terminado.
Esta fue una prueba limitada y, por lo tanto, un tamaño de muestra de APIs y evals bastante pequeño. Nos divertimos y quisimos compartir lo que vimos temprano. Más datos, más evals, más experimentación impulsarán una historia más sólida, pero eso llevará tiempo.
Los próximos pasos opcionales que podríamos tomar: un prompt de revisor más estricto y la misma matriz en Opus 5 o incluso un modelo de peso abierto. Mantente atento.
Gracias
Nada de esto existe sin el equipo central de Rails. Publicaron Agents on Rails con la metodología y los números, y liberaron como código abierto lemans, el arnés detrás de él, para que cualquiera pueda apuntar la misma maquinaria a su propia app. Hicimos un fork, agregamos un adaptador, y tuvimos un banco de pruebas funcionando contra nuestra base de código en días en lugar de meses. Gracias por medir en público y por facilitar el seguimiento.
Fuentes
Equipo central de Rails, Agents on Rails: Claude Fable 5.1 and GLM 5.3 Flash, la publicación del benchmark, y la página Rails and AI para las cifras actuales por modelo.
Equipo central de Rails, Agents on Rails: the first benchmark report y Agents on Rails: lemans, la metodología y el anuncio del arnés.
rails/lemans, el arnés de benchmark, y nuestro fork con el adaptador de Claude Code.
Documentación de la API de Rails para las funcionalidades en las tareas: has_secure_token, generates_token_for,
normalizes(ver las notas de la versión 7.1 abajo), validates_comparison_of, y perform_all_later.Notas de la versión Rails 7.1, donde llegaron
generates_token_for,normalizesyperform_all_later.Claude Code hooks, el mecanismo detrás del revisor al momento de detenerse.
La prueba de McNemar, la comparación pareada utilizada a lo largo de todo el estudio.
Apéndice
Detalles de las pruebas
Fable 5.1 en esfuerzo predeterminado a través de Claude Code
Una app de Rails 8.1.3.1 en Ruby 4.0.6
Calificación oculta de RSpec más las especificaciones propias de la app y RuboCop como filtro
Ronda uno: cinco configuraciones, ocho tareas, tres intentos, 120 ensayos
Ronda dos: ocho configuraciones, cuatro tareas, cuatro intentos, 128 ensayos
Un seguimiento ejecutó la regla, la herramienta de búsqueda y el revisor juntos en las cuatro tareas restantes, cuatro intentos cada una, 16 ensayos, por lo que la cifra de 28 de 28 cubre las siete tareas
El recall se calificó en el diff del agente mediante regex para la API ancla frente a sus formas hechas a mano
Las comparaciones pareadas usaron una prueba exacta de McNemar con un piso de seis pares discordantes
Las reglas de decisión se escribieron antes de cada ejecución
Cuatro de las siete tareas semilla se escribieron originalmente con Claude Code
La regla de recall de API. Añadida a CLAUDE.md
## Rails
This app runs Rails 8.1 on Ruby 4.0.
Prefer the framework APIs Rails 7.1 and later added over hand-rolled equivalents.
Before writing a helper, concern, callback or loop for a framework concern, check whether Rails already provides it: `grep -rn "def <name>" "$(bundle show <gem>)/lib"`.
Use the framework API unless it demonstrably does not fit, and say why in the PR.
La herramienta de búsqueda
Un script de Ruby enviado al sandbox como bin/rails-api, más este párrafo en CLAUDE.md.
## Rails API lookup
`bin/rails-api search <words>` searches the Rails gems installed for this app for method names and doc comments matching every word.
`bin/rails-api show <method>` (or `Const#method`) prints the doc comment, signature, options and source of a definition.
Both read the pinned gem versions from the bundle, so they answer for the Rails this app actually runs.
El revisor
Un hook de Claude Code Stop. Compara el trabajo del agente, envía este prompt a Sonnet 5 con el diff añadido, y sale con un bloqueo (exit 2) cuando la respuesta comienza con REWORK, para que el agente vea el mensaje y continúe. Se ejecuta una vez por ensayo.
You are reviewing a diff to a Rails 8.1.3.1 app on Ruby 4.0 before it is submitted.
One question only: does this diff hand-roll something the installed Rails already provides
(a callback, validation, token, normalization, limiter, batching, loop or helper that a
framework macro or method covers)?
Check the installed gems, not your memory: run `.claude/hooks/rails-api search <words>` to find candidates
and `.claude/hooks/rails-api show <method>` to read the signature, options and source. Confirm the
options actually fit the diff's requirements before deciding either way.
Answer with exactly one line and nothing else:
OK
or
REWORK: <framework method>, <gem file:line>, <one sentence on why its options fit this diff>